以太坊共同創辦人 Vitalik Buterin:本地 AI 能兼顧隱私與速度,但加密錢包仍需嚴格控管
重點速覽
- •Buterin 的發文標誌著他自四月觀點以來的轉變:本地筆記型電腦模型現在能作為更大範圍任務的主要介面,而非僅限於高度受限的工作。
- •在他的 Strix Halo 筆記型電腦上的基準測試顯示,10 個工作負載的輸入處理速率介於每秒 109.82 至 373.22 個 token,輸出生成速率介於每秒 18.42 至 33.37 個 token。
- •阿里巴巴的開放權重模型 Qwen3.8-Flash-Next 是一款混合專家模型,總參數達 1,250 億,但每個 token 僅啟用 60 億個參數,並在 14 項基準中的 8 項上超越更大的 Qwen3.7-Plus。
- •標準能力基測試並未衡量提示詞注入攻擊的抵禦能力、錢包授權或自主金融行動的正確性,AI 掌控加密資產的問題仍未解決。
- •建議中的防護措施包括 Buterin 針對高風險交易的人與模型 2-of-2 核准規則、軟體定義的支出上限、由以太坊基金會資助的裝置端 Steward 錢包,以及針對交易後狀態斷言的 EIP-7906 草案標準。
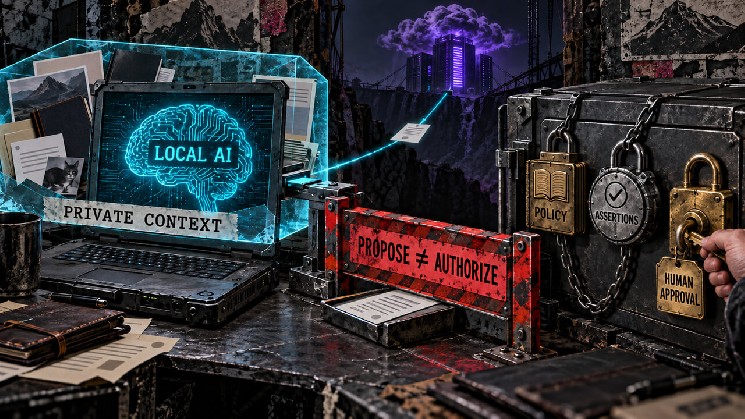
以太坊共同創辦人 Vitalik Buterin 表示,筆記型電腦上的人工智能正接近實用轉折點——不過,在 AI 可被信任掌控加密資產之前,錢包軟體仍需達到高得多的標準。
Buterin 在 9 月 17 日的發文中表示,Qwen 3.8 Flash 以及 llama.cpp(用於在本地硬體上直接執行大型語言模型的開源專案)的近期改進,已使本地模型接近能在他的 Strix Halo 筆記型電腦上處理「大部分」任務。對於更進階的工作,他描述了一種由本地模型協調請求、轉送至更強大的遠端系統,同時不洩漏使用者完整個人情境的做法。
隨文附上的基準測試圖片顯示了 10 個工作負載。報告的輸入處理速率介於每秒 109.82 至 373.22 個 token 之間,輸出生成速率則介於每秒 18.42 至 33.37 個 token 之間。這些數據支持了關於單台高階筆記型電腦回應速度的實用性主張,但模型判斷力、對惡意指令的抵禦能力以及交易授權等問題仍未解決。
本地推論可以改善隱私,而資金移轉的權限則應留在獨立且可執行的控管機制之後。
四月至九月之間的變化
Buterin 在四月對其本地 AI 配置的說明中,對筆記型電腦模型角色的描述較為保守。他當時寫道,Qwen3.5:35B 可以處理有明確範圍的任務和熟悉的程式設計工作,而能夠持續在程式碼庫上工作的高階自主代理,仍超出筆記型電腦的實際能力範圍。更困難的程式編寫與智力工作仍需要更強大的遠端模型。
九月的發文改變了他對實用邊界所在位置的評估。本地模型似乎不再侷限於轉、摘要或其他高度受限的工作。在新的描述中,它可以作為更大範圍活動的主要介面,並判斷何時需要遠端模型。遠端服務只會收到本地模型所選取的問題或情境,而非理解使用者整體情況所需的每一份檔案、訊息和錢包細節。本地系統因此同時成為資訊守門員與助理。
四月與九月涉及不同的模型世代與不同任務。九月的發文提供了 token 數量與吞吐量,但未說明提示詞內容、量化選擇以及完整的執行環境配置。
由阿里巴巴 Qwen 團隊發布的 Qwen3.8-Flash-Next 是一款開放權重的多模態混合專家模型。其主模型擁有 1,250 億個參數,另有 510 億個參數位於 n-gram 嵌入表中,而每個 token 僅啟用 60 億個參數。開放權重發布意味著該模型可以完全下載並在使用者自己的機器上執行——正是這種安排使本地、私密的推論成為可能。官方儲存庫記載了透過 llama.cpp 使用量化 GGUF 版本進行本地文字與視覺推論。
為每個 token 僅啟用模型的一部分可降低運算負擔。使用者仍需為所選版本和情境準備足夠的記憶體,且官方文件並未提供一個適用於所有量化等級與工作負載的單一硬體最低需求。
能力基準測試未解決錢包授權問題
Qwen 的技術報告針對基礎模型在 14 項基準上進行評估,涵蓋一般知識、數學、科學、推理、程式編寫與多語言理解。Qwen 團隊表示,Flash-Next 在其中八項測試中超越了更大的 Qwen3.7-Plus 基礎模型,同時使用更少的啟用參數與更少的訓練運算量。
該報告涵蓋模型能力、效率與訓練穩定性。提示詞注入攻擊的抵禦能力、政策執行、錢包授權以及自主金融行動的正確性,都不在這組基準測試的範圍內。
助理可以私密地解釋交易、準備 calldata 或建議路徑。簽署者則可能做出不可逆轉的請求,轉移資產或授權另一份合約移動資產。更好的推理能力能減少某些錯誤,但隱藏在網站、訊息或交易描述中的惡意指令,仍可能改變模型的計畫。
以太坊生態系已在測試裝置端版本的助理概念。以太坊基金會在其第二季資金配置更新中列出了 Steward——一款完全本地化的 macOS 智慧帳戶錢包,其輕客戶端與 AI 助理預計在裝置端執行。該披露確立了資金與專案範圍,但生產環境部署、獨立稽核狀態以及自主交易授權均尚未確立。這些未決事項是裝置端錢包助理從資金披露邁向正式軟體發布過程中值得關注的指標。
Buterin 四月的錢包指導原則將此類授權置於語言模型之外。他描述了一個針對高風險行動的人工確認防火牆、對交易金額、calldata 與交易次數確定性限制,以及人與模型共同執行的 2-of-2 規則。模型可能察覺到分心的人所忽略的詐騙模式,而人也可能在模型被惡意內容操縱後拒絕某項行動。要求高風險交易必須獲得雙方批准,可防止任何一方悄然成為唯一的信任錨點。
低風險自動化可以在軟體定義的權限範圍內持續運作。讀取餘額、準備未簽署的交易,或在嚴格的上限內運作,都能讓助理發揮作用,而不會賦予它無限制的支出權力。
錢包信任取決於模型無法改寫的規則
EIP-7906 目前仍為草案,提議以交易後斷言框架檢查交易所產生的最終狀態差異。當這些變更違反特定條件時,斷言可以拒絕應用結果。
錢包可利用該機制要求兌換只改動已核准的餘額、不出現隱藏的代幣授權,或受保護帳戶的狀態保持不變。這些檢查將交易的實際效果與明確規則進行比對。
草案也描述了這種保護的邊界。檢查過少的斷言可能造成虛假的安全感。錢包驗證邏輯必須要求預期的斷言框架,且斷言本身必須涵蓋受保護操作的所有相關狀態變更。
本地推論與交易斷言解決的是錢包代理問題的不同部分。本地模型保護情境並將自然語言意圖轉化為擬議行動;確定性權限限制收款方、合約、金額與頻率;斷言則檢查最終狀態變更。人工確認仍是高風險行動的第二道因素。
九月的筆記型電腦測試結果使第一層更為可信。它顯示私密的本地模型可以有足夠快的回應速度來協調日常工作,並選擇性地運用遠端的智能。其餘層級仍承載著保護資產的權限。
加密錢包可以將模型視為稱職的介面、規劃者與監控者。信任屬於模型無法更改的控管機制,以及讓使用者始終真正掌握主導權的核准流程。
來源:CryptoSlate,經由 CryptoNewsNet。

