OpenAI GPT-6 Astra 以创纪录的低token用量首次在韩国高考中获得满分
要点速览
- •OpenAI 的 GPT-6 Astra 在 2026 年 CSAT LLM Solution Log 中获得满分 450,是首个在所有测试科目上均取得满分的模型。
- •Astra 消耗了 357,000 个 token,为公开可用模型中报告的最低用量,相较竞争对手降低了推理成本。
- •OpenAI 的 GPT-5.6 以 448.5 分排名第二,领先于 GPT-5.4(448 分)、Claude Fable 5.1(447.5 分)和 Gemini 3.1 Pro(445 分)。
- •该模型的高效归功于一种在重复性任务中保留、压缩并复用先前推理步骤上下文的设计。
- •行业专家提醒,AI 能力应根据其解决开放式现实问题的表现来评判,而不仅是标准化考试成绩。
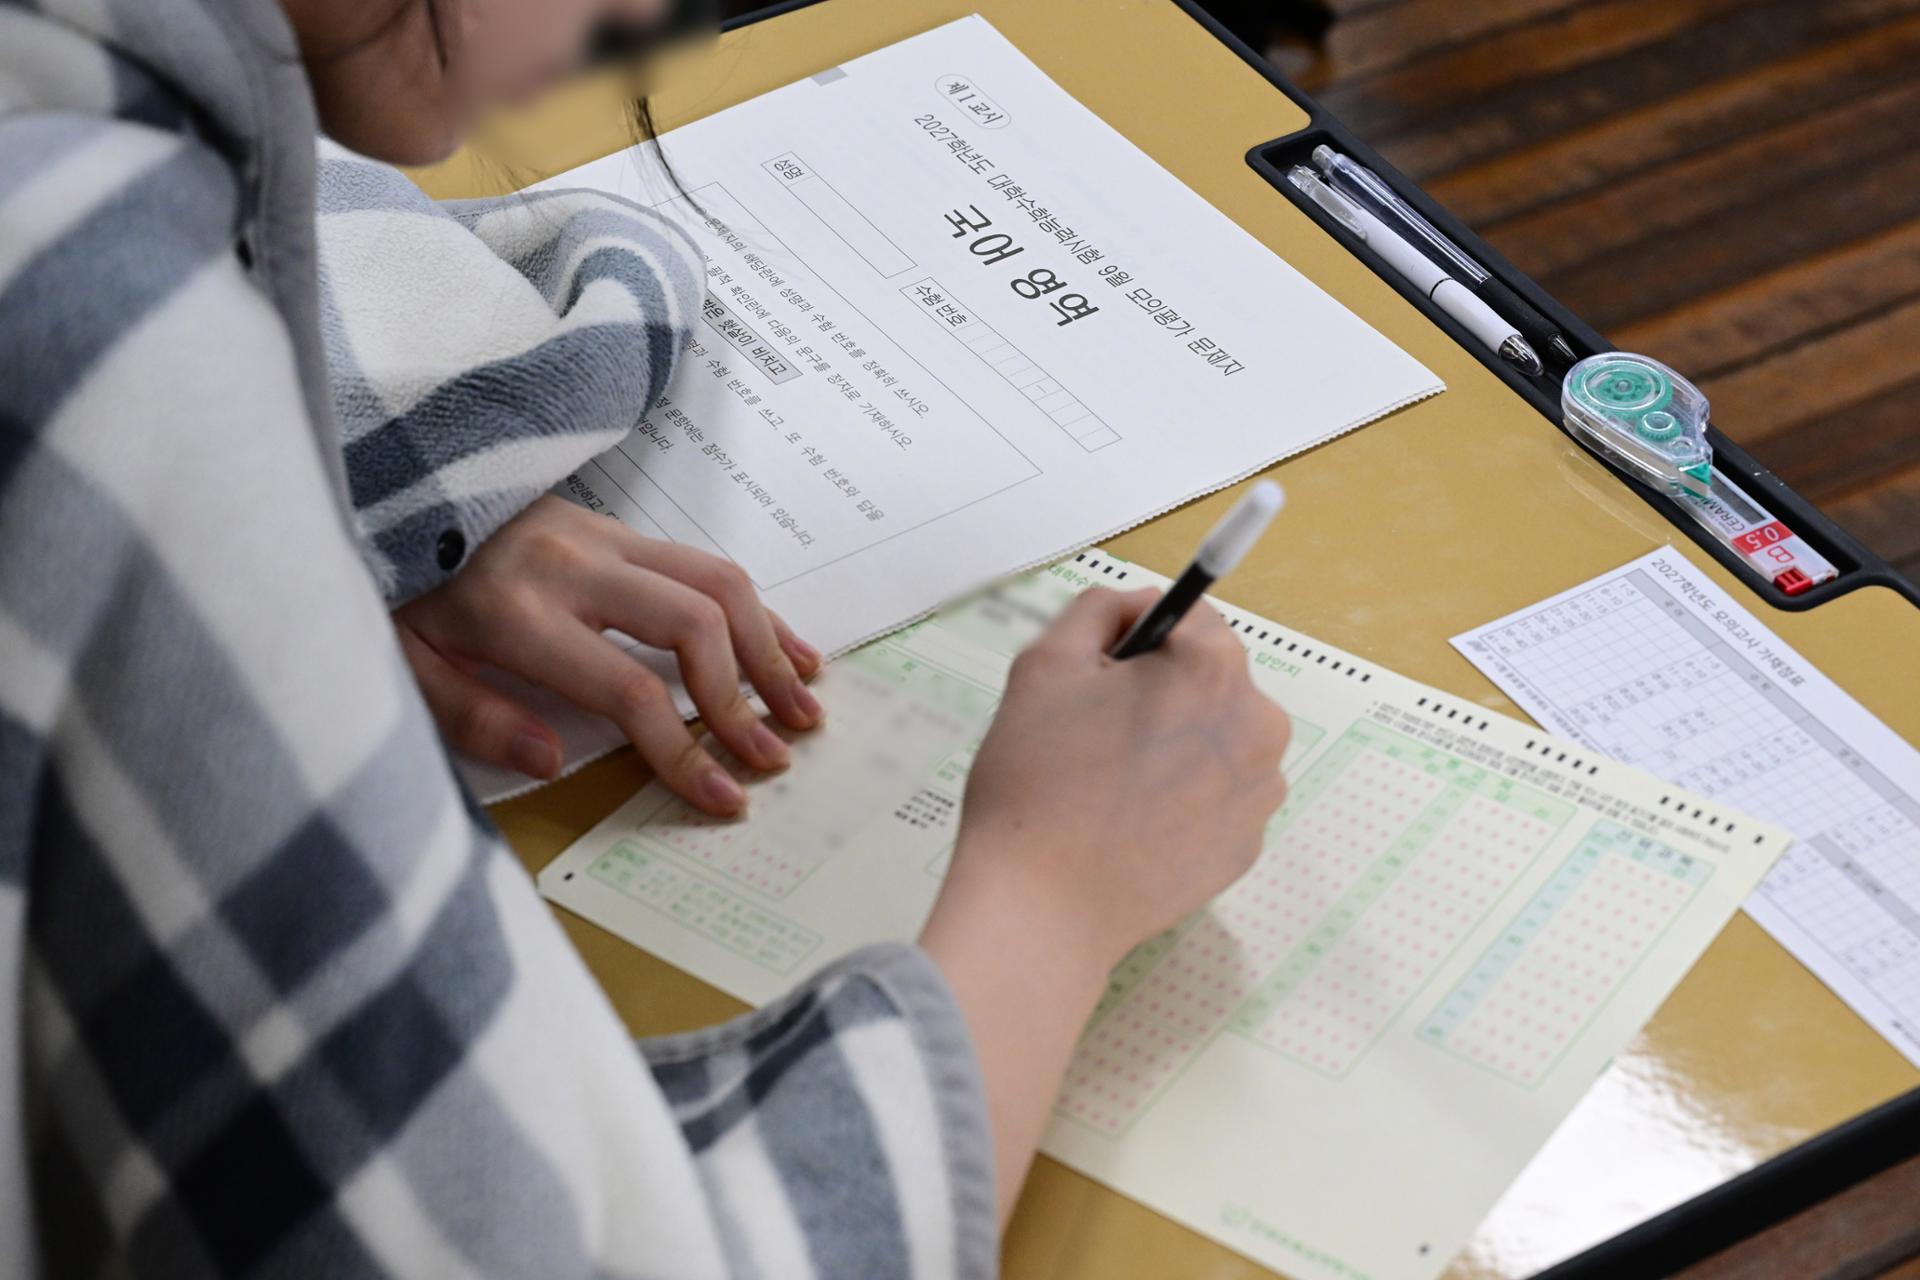
根据最新发布的一项分析,OpenAI 最新的 AI 模型首次在韩国大学学术能力测试(CSAT)中获得满分。虽然此前顶级 AI 模型已取得接近满分的成绩,但这一结果之所以备受关注,是因为该模型在取得满分的同时消耗的 token 少于竞争对手——这一指标在商业上意义重大,因为 token 用量直接决定了大规模运行这些模型的开发者和企业的推理成本。
周日发布在 GitHub 上的结果显示,OpenAI 新推出的 GPT-6 Astra 是 2026 年 CSAT LLM Solution Log 中唯一获得满分 450 的受评测模型。该评测在不联网的条件下,使用 2026 年 CSAT 的试题测试各模型,涵盖韩语、英语、数学、韩国历史以及四门选修科目——物理 I、化学 I、生命科学 I 和社会与文化。CSAT 是每年数十万韩国学生参加的标准化考试,如今已成为比较前沿模型在考试条件下处理多语言、多学科推理能力的一个常用标尺。
Astra 是该评测中首个在所有测试科目上均获得满分的 AI 模型。今年 2 月,谷歌的 Gemini 3.1 Pro 仅选择两门选修科目——化学 I 和生命科学 I——便取得了满分,但在本次评测采用的更广泛科目设置下,它在物理 I 和一门社会学科目中失分。
在周日公布的排名中,OpenAI 的 GPT-5.6 以 448.5 分位居第二,GPT-5.4 以 448 分位列第三。Anthropic 的 Claude Fable 5.1 以 447.5 分排名第四,Gemini 3.1 Pro 以 445 分位列第五。
GPT-6 Astra 使用了 357,000 个 token,为公开可用模型中报告的最低总量。相比之下,GPT-5.6 使用了 429,000 个 token,Claude Fable 5.1 使用了 562,000 个。由于试题和答案均已公开,该结果无法排除通过训练数据预先接触试题的可能,不过 Claude Fable 5.1 和 Gemini 3.1 Pro 等竞争模型也面临同样的条件。
该模型的优异表现与较低 token 用量,归功于一种在重复性任务中保留上下文的推理关联设计。一个提供商适配器框架(provider adapter harness)会对先前推理步骤的信息进行压缩和复用,使 AI 能够像高分考生那样作答。
汉阳大学兼任教授李承贤(Lee Seung-hyun)表示,关键不仅仅在于模型变得更聪明,而在于它能够保留先前的推理步骤、压缩上下文并修正自己的计划。“这意味着它不是每次都更努力地思考,而是继续利用它此前已经弄明白的东西,”李承贤说。
OpenAI 将这一结果描述为令人鼓舞,并指出该模型借助超大规模 AI 计算基础设施实现了高效处理。一位 OpenAI 官员表示,这一里程碑表明模型可以在提升性能、降低成本的同时变得更强大。
然而,行业专家提醒,模型的潜力应通过其解决开放式问题的能力来评判,而不仅仅是标准化考试的成绩。一位韩国 AI 行业内部人士表示,如果 AI 能够应对没有预设答案的现实职场挑战,那将更有意义。领先模型在更广泛的独立基准上的表现——以及竞争对手能否缩小效率差距——将表明这一结果是否标志着成本与性能权衡的持久性转变。
本文基于《韩国日报》(Hankook Ilbo,《韩国时报》的姊妹刊物)的报道,由生成式 AI 系统翻译并经《韩国时报》编辑。原始来源:The Korea Times。
