Прогресс медицинского ИИ опережает доказательства улучшения исходов для пациентов
Ключевые выводы
- •Рандомизированное испытание в 16 учреждениях Penda Health в Кении показало, что поддержка больших языковых моделей улучшила документацию и качество диагностики, но существенно не снизила частоту неудач лечения через 14 дней: 2,2% в группе с ИИ против 2% в контрольной группе.
- •Управление FDA 18 августа выпустило дискуссионный документ о регулировании генеративного ИИ в медицинских устройствах, открытый для комментариев до 19 октября, который охватывает оценку рисков, предпродажную оценку и постмаркетинговый мониторинг.
- •Многострановое испытание показало, что GPT-4o улучшила результаты 249 врачей на клинических виньетках на 7,2–18%, но в исследовании использовались смоделированные случаи и вред не оценивался, поэтому реальная польза для пациентов остается недоказанной.
- •Комментарий в npj Digital Medicine предупреждает, что наличие клинициста «в контуре» не гарантирует эффективного надзора, поскольку предвзятость автоматизации повышает вероятность принятия ошибочных рекомендаций ИИ.
- •По прогнозу MarketsandMarkets, рынок ИИ в здравоохранении вырастет с 36,67 млрд долларов в 2026 году до 194,79 млрд долларов к 2031 году, что соответствует среднегодовому темпу роста 39,7%.
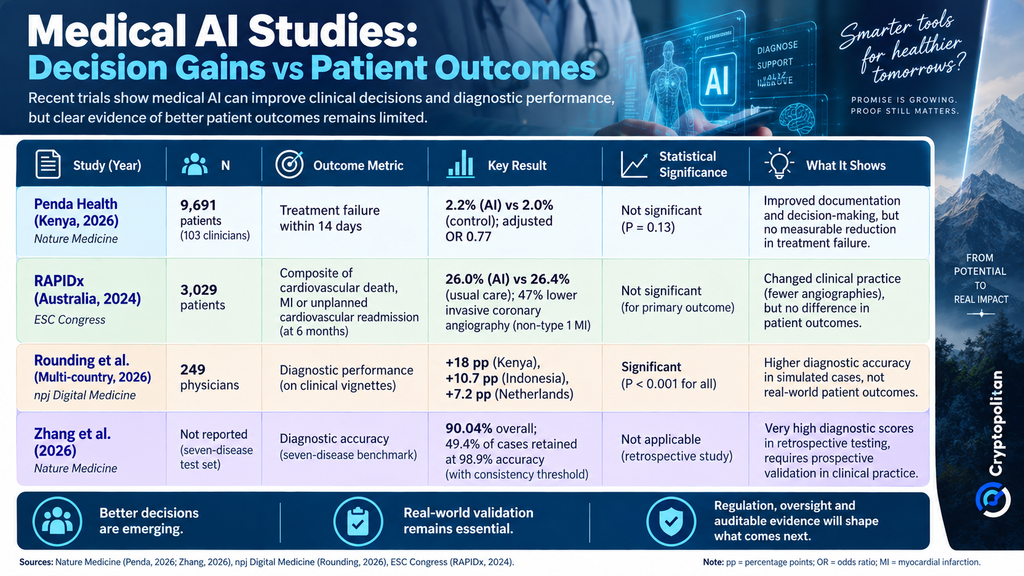
Растущий объем исследований 2026 года подчеркивает устойчивый разрыв в медицинском искусственном интеллекте: эти системы могут влиять на решения врачей и давать впечатляющие диагностические результаты, не показывая, что пациенты в конечном итоге становятся здоровее.
Этот вопрос важен для больниц, оценивающих ИИ-инструменты, компаний, стремящихся продемонстрировать их ценность, и регуляторов, определяющих, какие доказательства должны требоваться после внедрения этих систем в клиническую практику.
Регуляторы изучают проблему доказательств медицинского ИИ
Разрыв между заявленными показателями ИИ и доказанной пользой для пациентов становится все труднее игнорировать. Издание Financial Times подвело итог этой ситуации в заголовке: «У медицинского ИИ проблема с доказательствами».
Этот вопрос вышел за рамки академических дискуссий. Управление по контролю за продуктами и лекарствами США (FDA) рассматривает многие из тех же вопросов, решая, как оценивать медицинские устройства с поддержкой ИИ до и после развертывания. Дискуссионный документ от 18 августа, открытый для общественных комментариев до 19 октября, затрагивает оценку рисков, предпродажную оценку и постмаркетинговый мониторинг.
FDA подчеркнула, что документ является исключительно дискуссионным. Это не проект руководства, не предложение об изменении политики и не указание на будущие регуляторные ожидания. Тем не менее открытый период комментариев дает больницам, производителям устройств и исследователям официальный канал для изложения того, какие доказательства, по их мнению, должны требоваться для клинического внедрения.
Предыдущий запрос FDA на общественные комментарии по измерению и оценке реальной эффективности медицинских устройств с поддержкой ИИ также поднял вопросы о дрейфе моделей и ограничениях статических метрик. Дрейф модели — деградация, которая может возникать, когда реальные пациенты или практика расходятся с обучающими данными модели, — одна из причин, по которой инструмент, валидированный при запуске, может вести себя иначе спустя месяцы. Это оставляет более широкий вопрос: как следует измерять безопасность и эффективность после того, как ИИсистема покидает лабораторию и входит в клиническую помощь?
Поддержка ИИ не снизила частоту неудач лечения в Кении
Исследование, опубликованное в Nature Medicine 26 июня, изучало, улучшает ли LLM, используемая для принятия клинических решений, исходы для пациентов. В исследовании участвовали 103 клинических офицера в 16 учреждениях Penda Health в округах Найроби и Киамбу. Офицеры лечили пациентов с помощью большой языковой модели или без нее.
Из 9 691 зарегистрированного пациента 9 347 были включены в основной анализ. Неудача лечения через 14 дней произошла у 2,2% группы с ИИ и 2% контрольной группы. Скорректированное отношение шансов составило 0,77, но разница не была статистически значимой (P=0,13). Серьезные нежелательные явления с вмешательством связаны не были.
Группа с поддержкой ИИ показала лучшую документацию и более подходящие диагнозы и планы лечения. Однако эти улучшения процессных показателей не привели к улучшению исходов для пациентов. Этот разрыв — суть проблемы доказательств: метрики, такие как качество документации и диагностики, собирать гораздо проще, чем исходы вроде неудач лечения, но результаты Penda показывают, что они могут меняться независимо друг от друга.
Аналогичная картина наблюдалась в испытании RAPIDx AI 2024 года. Среди 3 029 пациентов основного анализа комбинированный исход через шесть месяцев — смерть от сердечно-сосудистых причин, инфаркт миокарда или незапланированная сердечно-сосудистая госпитализация — произошел у 26% пациентов, получавших помощь с поддержкой ИИ, против 26,4% получавших стандартную помощь. Однако в группе с инфарктом миокарда не 1 типа инвазивная коронарная ангиография выполнялась на 47% реже при помощи с поддержкой ИИ.
Растущие баллы тестов не доказали реальную пользу
Многострановое рандомизированное испытание под руководством Николаса Раундинга показало, что GPT-4o улучшила результаты 249 врачей на клинических виньетках на 18% в Кении, 10,7% в Индонезии и 7,2% в Нидерландах (P<0,001). Однако исследование использовало смоделированные случаи, а не реальные клинические ситуации. Участники контрольной группы не могли пользоваться интернетом или клиническими протоколами, а вред не оценивался.
Результаты показывают, что ИИ может повышать эффективность в контролируемых условиях, но не устанавливают влияния на исходы пациентов. Именно это различие между контролируемыми и реальными условиями является предметом предпродажных и постмаркетинговых вопросов FDA.
Другое исследование в Nature Medicine, проведенное Ли Чжаном, Якобом Никласом Катером и коллегами, сообщило о точности 90,04% на бенчмарке из семи заболеваний. Применив порог согласованности, локальный агент удержал 49,4% случаев с точностью 98,9%, тогда как остальные случаи были переданы на проверку специалистам. Авторы заявили, что результаты требуют дальнейшего подтверждения в испытаниях в реальных клинических условиях. Исследование доступно здесь.
Наличие врача «в контуре» — недостаточно
Карта доказательств, составленная Джой Сюй, Джастином Ко и Джозефом Кведаром, показала, что агентный ИИ используется не только в административной работе, но и в диагностике, ведении пациентов и других задачах здравоохранения. В результате способность управлять и аудировать эти системы становится все более важной. Карта доказательств доступна здесь.
Отдельный комментарий в npj Digital Medicine утверждает, что само участие клинициста не гарантирует эффективного надзора или управления. Предвзятость автоматизации может повышать вероятность принятия ошибочной рекомендации. Значимый надзор требует достаточных знаний, времени и полномочий, чтобы оспаривать систему и вмешиваться при необходимости.
Без этих условий, предупреждают авторы, человеческий надзор может превратиться в мало что иное, как страховку от ответственности:
Ответственность может обрушиться на клиницистов, от которых ожидают выявления ошибок, которые они не в состоянии обнаружить или исправить … моральная зона смягчения удара.
Таким образом, дискуссия выходит за рамки того, находится ли человек технически «в контуре». Она также касается того, способен ли этот человек оспаривать, отменять и останавливать систему при необходимости. Комментарий доступен здесь.
Коммерческие ставки повышают важность доказательств
По прогнозу MarketsandMarkets, рынок ИИ в здравоохранении вырастет с 36,67 млрд долларов в 2026 году до 194,79 млрд долларов к 2031 году, что соответствует среднегодовому темпу роста 39,7%. Прогноз рынка появляется в то время, когда больницам предстоит принимать больше решений о покупке ИИ при неравномерных доказательствах улучшения исходов для пациентов.
Такая среда может усилить давление в пользу форм валидации, которые сложнее продвигать на рынке, но которые более ценны для поставщиков: проспективное тестирование, локальный мониторинг производительности и надзор, который можно независимо аудитировать. Одним из ближайших ориентиров станет обратная связь, которую FDA получит на свой дискуссионный документ, открытый для общественных комментариев до 19 октября.

