Исследование ETH Zurich и Anthropic: LLM могут раскрыть анонимные аккаунты всего за несколько долларов
Ключевые выводы
- •Конвейер верно идентифицировал 226 из 338 пользователей Hacker News — около 67% — с точностью 90%, используя только общедоступные публикации.
- •Весь эталонный тест обошёлся менее чем в 2 000 долларов, в среднем около 1–4 долларов на идентифицированный профиль, что показывает, насколько дешёвой стала масштабная деанонимизация.
- •Система работает в четыре этапа — Extract, Search, Reason и Calibrate — и сознательно воздерживается от вывода при неуверенности, снижая число ложных срабатываний.
- •Исследователи не опубликовали код, промпты или какие-либо реальные личности, а исследование прошло проверку этической комиссии ETH Zurich до публикации.
- •Авторы заключают, что практическая неузнаваемость, защищающая псевдонимные аккаунты, больше не работает, указывая на риски для журналистов, активистов, целей рекламодателей и пользователей криптовалют.
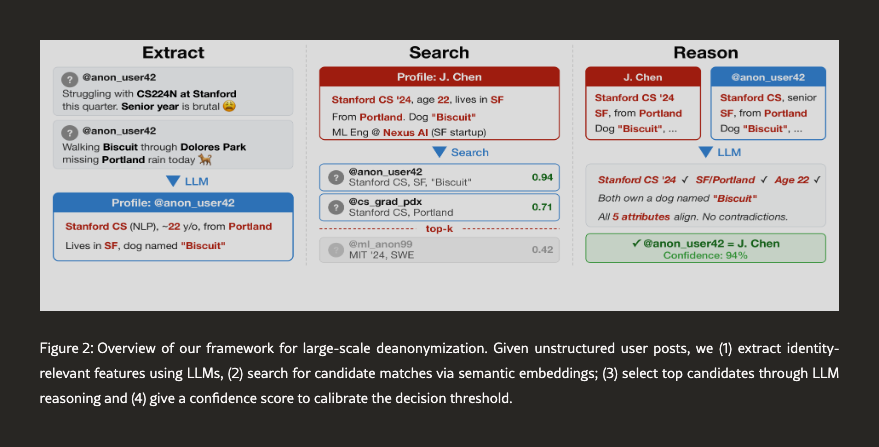
Исследователи ETH Zurich, группы по безопасности ИИ MATS и компании Anthropic создали автоматизированный LLM-конвейер, способный связывать псевдонимные публикации в интернете с реальными личностями. В ходе тестирования система идентифицировала сотни пользователей Hacker News с точностью 90% при затратах от 1 доллара на пользователя.
Исследование "Large-scale online deanonymization with LLMs" впервые было размещено на arXiv 18 февраля, а затем опубликовано в трудах 35-го симпозиума USENIX Security — ведущей академической площадки в области исследований безопасности. На этой неделе оно вновь привлекло внимание после распространения на X и Reddit.
Авторы статьи — Симон Лермен, Даниэль Палека, Джошуа Свонсон, Михаэль Аэрни, Николас Карлини и Флориан Трамер. Карлини является сотрудником Anthropic, компании, создавшей модели Claude, остальные связаны с ETH Zurich и MATS.
Четыре этапа сужают пул из 89 000 кандидатов
Для атаки не требуются украденные данные или взломанные серверы. Агент работает только с информацией, которая и так доступна каждому публично, выполняя работу терпеливого исследователя дешевле и быстрее.
Исследователи разделили процесс на четыре этапа: Extract, Search, Reason и Calibrate. Сначала языковая модель извлекает признаки личности из необработанных публикаций — упоминания профессии, местоположения или характерной манеры формулировок. Затем семантические эмбеддинги сужают пул из 89 000 кандидатов до краткого списка. Модель рассуждения оценивает наиболее вероятные совпадения и решает, принадлежат ли два аккаунта одному человеку. Этап Calibrate заставляет конвейер воздерживаться от вывода при неуверенности, снижая количество ложных срабатываний.
Конвейер работает на готовых инструментах: веб-поиске, эмбеддингах и моделях, таких как GPT-5.2. Более ранние атаки по деанонимизации, например повторная идентификация анонимизированных оценок Netflix в 2008 году, опирались на структурированные данные. Тот случай показал, как якобы анонимные записи могут быть раскрыты путём сопоставления со внешней информацией — предшественник описанного здесь автоматизированного малозатратного подхода, требовавший больших объёмов данных.
226 из 338 пользователей Hacker News идентифицированы с точностью 90%
Чтобы оценить метод без риска для реальных людей, команда сформировала эталонный набор из 338 пользователей Hacker News — технологического форума, управляемого стартап-акселератором Y Combinator, — чьи профили ссылались на страницу LinkedIn, что давало известную истинную личность для каждого. Получив только комментарии и публикации каждого пользователя, агент верно идентифицировал 226 около 67% — с точностью 90%. Он допустил 25 ошибок и воздержался по 86 аккаунтам. Классические не-LLM базовые методы в масштабных тестах на сопоставление показали результат, близкий к нулю.
Эксперименты в целом обошлись менее чем в 2 000 долларов, то есть примерно в 1–4 доллара на профиль.
Два дополнительных набора данных прошли дальнейшую проверку: один сопоставлял пользователей Reddit между двумя различными кином сообществами, а другой реконструировал единую историю Reddit, разделив её на два временных периода. В обоих случаях методы на основе LLM значительно превзошли старые техники.
Предупреждения и меры предосторожности
Авторы указывают на целый ряд возможных злоупотреблений: государства, преследующие журналистов или активистов, компании, формирующие всё более точные рекламные профили, и мошенники, составляющие досье для схем социальной инженерии.
"Сочетание таких данных часто образует уникальный отпечаток", — написал Лермен в блоге 24 февраля. Он добавил, что если команда умных следователей может идентифицировать человека по его публикациям, то, вероятно, это могут и LLM-агенты — и стоимость продолжает снижаться.
Исследователи не опубликовали код, промпты или какие-либо реальные личности, выявленные системой. Перед публикацией исследование прошло проверку этической комиссии ETH Zurich.
"Практическая неузнаваемость, защищающая псевдонимных пользователей в сети, больше не работает", — говорится в заключении статьи. Именно на такую неузнаваемость до сих пор полагалось большинство псевдонимных аккаунтов — распространённых как на форумах разработчиков, так и в криптосообществах.
Новое внимание к исследованию возникло через день после того, как комиссар SEC Хестер Пирс предостерегла от массового сбора KYC-данных — «know your customer», проверки личности, которые финансовые компании обязаны проводить в отношении своих пользователей, — заявив, что такой подход означает «построение всё больших и больших стогов сена из данных». Недавние утечки в Revolut и у поставщиков, связанных с производителем аппаратных кошельков Trezor, усилили опасения по поводу «wrench attacks» — атак гаечным ключом, когда узнавший о владении криптовалютой человек приходит к жертве лично.

