Współzałożyciel Ethereum Vitalik Buterin: lokalne AI może chronić prywatność bez utraty szybkości, ale portfele wciąż wymagają twardych zabezpieczeń
Najważniejsze informacje
- •Post Buterina oznacza zmianę względem jego kwietniowego stanowiska: lokalne modele laptopowe mogą już pełnić rolę głównego interfejsu dla większej części zadań, a nie tylko pracy ściśle ograniczonej.
- •Benchmarki na jego laptopie Strix Halo wykazały szybkość przetwarzania wejścia od 109,82 do 373,22 tokenów na sekundę i generowania wyjścia od 18,42 do 33,37 tokenów na sekundę w 10 obciążeniach.
- •Otwarty model Qwen3.8-Flash-Next od Alibaba to model mixture-of-experts o 125 miliardach parametrów, który aktywuje tylko 6 miliardów na token, i pokonał większy Qwen3.7-Plus w 8 z 14 benchmarków.
- •Standardowe benchmarki możliwości nie mierzą odporności na wstrzykiwanie promptów, autoryzacji portfela ani poprawności autonomicznych działań finansowych, co pozostawia kwestię kontroli AI nad aktywami krypto nierozstrzygniętą.
- •Proponowane zabezpieczenia obejmują regułę zatwierdzania 2 z 2 łączącą człowieka i model dla ryzykownych transakcji, limity wydawania zdefiniowane programowo, finansowany przez Ethereum Foundation lokalny portfel Steward oraz projekt standardu EIP-7906 dotyczący asercji stanu po transakcji.
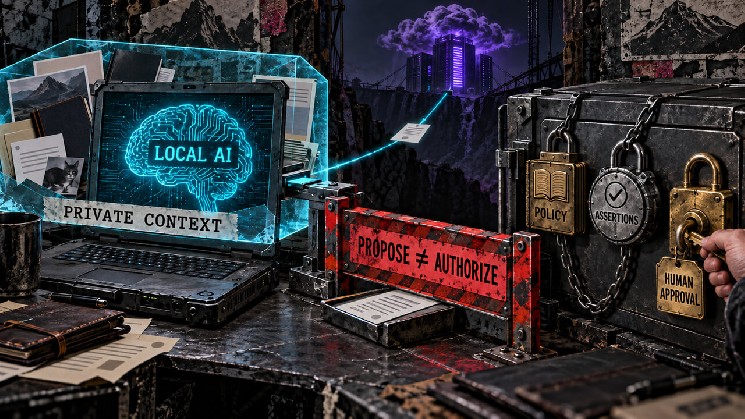
Współzałożyciel Ethereum Vitalik Buterin uważa, że sztuczna inteligencja działająca na laptopie zbliża się do praktycznego punktu zwrotnego — choć oprogramowanie portfela musi jeszcze pokonać znacznie wyższy próg, zanim AI będzie można zaufać w zakresie kontroli nad aktywami krypto.
W poście z 17 września Buterin stwierdził, że Qwen 3.8 Flash i ostatnie usprawnienia llama.cpp — otwartego projektu do uruchamiania dużych modeli językowych bezpośrednio na lokalnym sprzęcie — zbliżyły lokalne modele do obsługi „dużej części” zadań na jego laptopie Strix Halo. W przypadku bardziej zaawansowanej pracy opisał lokalny model koordynujący zapytania do silniejszych systemów zdalnych przy jednoczesnym ukrywaniu pełnego osobistego kontekstu użytkownika.
Zamieszczony w poście obraz benchmarku pokazywał 10 obciążeń. Zgłaszane szybkości przetwarzania wejścia mieściły się w zakresie od 109,82 do 373,22 tokenów na sekundę, a generowanie wyjścia od 18,42 do 33,37 tokenów na sekundę. Te dane potwierdzają praktyczne twierdzenie o responsywności na jednym wysokowydajnym laptopie, ale pozostawiają bez odpowiedzi kwestie osądu modelu, odporności na złośliwe instrukcje i autoryzacji transakcji.
Lokalna inferencja może poprawić prywatność, podczas gdy uprawnienie do przemieszczania środków pozostaje za oddzielnymi, wymuszalnymi kontrolami.
Co zmieniło się między kwietniem a wrześniem
W kwietniowym opisie swojego lokalnego zestawu AI Buterin przypisał modelom laptopowym węższą rolę. Napisał, że Qwen3.5:35B mógł obsługi ograniczone zadania i znajomą pracę programistyczną, podczas gdy zaawansowane, niezależne agenty zdolne do kontynuowania pracy nad bazą kodu pozostawały poza praktycznymi możliwościami laptopów. Trudniejsze zadania programistyczne i intelektualne nadal wymagały silniejszych modeli zdalnych.
Wrześniowy post przesuwa jego ocenę położenia praktycznej granicy. Lokalny model nie wydaje się już ograniczony do transkrypcji, streszczania ani innej ściśle ograniczonej pracy. W nowszym opisie może on stanowić główny interfejs dla większej części aktywności i decydować, kiedy potrzebny jest model zdalny. Usługa zdalna otrzymuje jedynie pytanie lub kontekst wybrany przez model lokalny — a nie każdy plik, wiadomość i szczegół portfela potrzebny do zrozumienia szerszej sytuacji użytkownika. System lokalny staje się zarówno strażnikiem informacji, jak i asystentem.
Kwiecień i wrzesień obejmowały różne generacje modeli i różne zadania. Wrześniowy podaje liczbę tokenów i przepustowość, ale pomija treść promptów, wybór kwantyzacji i pełną konfigurację środowiska uruchomieniowego.
Qwen3.8-Flash-Next, wydany przez zespół Qwen należący do Alibaba, to wielomodalny model typu mixture-of-experts o otwartych wagach. Jego główny model ma 125 miliardów parametrów, plus kolejne 51 miliardów w tabelach osadzeń n-gram, przy czym na token aktywuje się 6 miliardów parametrów. Dystrybucja z otwartymi wagami oznacza, że model można pobrać i uruchomić w całości na własnej maszynie użytkownika — to właśnie ten układ umożliwia lokalną, prywatną inferencję. Oficjalne repozytorium dokumentuje lokalną inferencję tekstu i obrazu przez llama.cpp przy użyciu skwantyzowanych buildów GGUF.
Aktywowanie części modelu dla każdego tokena obniża obciążenie obliczeniowe. Użytkownik nadal potrzebuje wystarczającej pamięci dla wybranego builda i kontekstu, a oficjalne materiały nie podają jednego minimalnego wymagania sprzętowego obowiązującego dla wszystkich poziomów kwantyzacji i obciążeń.
Benchmarki możliwości nie rozstrzygają kwestii autorytetu portfela
Raport techniczny Qwen ocenia model bazowy w 14 benchmarkach obejmujących wiedzę ogólną, matematykę, nauki ścisłe, rozumowanie, programowanie i rozumienie wielu języków. Zespół Qwen poinformował, że Flash-Next pokonał większy model bazowy Qwen3.7-Plus w ośmiu z tych testów, używając mniej aktywowanych parametrów i mniej mocy obliczeniowej treningu.
Raport obejmuje możliwości modelu, wydajność i stabilność treningu. Odporność na wstrzykiwanie promptów, egzekwowanie polityk, autoryzacja portfela i poprawność autonomicznych działań finansowych znajdują się poza tym zestawem benchmarków.
Asystent może prywatnie wyjaśnić transakcję, przygotować calldata lub zaproponować trasę. Podpisujący może wykonać nieodwracalne żądanie przenienia aktywów lub udzielenia innemu kontraktowi uprawnienia do ich przemieszczania. Lepsze rozumowanie ogranicza część błędów, ale złośliwa instrukcja ukryta w stronie internetowej, wiadomości lub opisie transakcji może nadal przekierować plan modelu.
Ekosystem Ethereum już testuje wersję koncepcji asystenta działającą na urządzeniu. W kwartalnym raporcie alokacji za drugi kwartał Ethereum Foundation wymieniła Steward — w pełni lokalny portfel smart-account na macOS, którego lekki klient i asystent AI mają działać na urządzeniu. Ujawnienie potwierdza finansowanie i zakres projektu, ale nie przesądza o wdrożeniu produkcyjnym, statusie niezależnego audytu ani o autorytecie do transakcji autonomicznych. Te otwarte kwestie są wskaźnikami, na które warto patrzeć, gdy portfelowe asystenty na urządzeniu przechodzą od ujawnień finansowania do wydawanego oprogramowania.
Kwietniowe wytyczne Buterina dotyczące portfeli umieszczały ten autorytet poza modelem językowym. Opisał on zaporę potwierdzeń ludzkich dla ryzykownych działań, deterministyczne limity kwot transakcji, calldata i liczby transakcji oraz regułę 2 z 2 łączącą człowieka i model. Model może rozpoznać schemat oszustwa, którego spostreczna osoba nie zauważy, podczas gdy człowiek może odrzucić działanie po tym, jak złośliwa treść zmanipuluje model. Wymaganie obu zgód dla ryzykownych transakcji zapobiega temu, by którykolwiek z uczestników po cichu stał się jedynym punktem zaufania.
Automatyzacja niskiego ryzyka może pozostać dostępna w ramach uprawnień zdefiniowanych programowo. Odczytywanie sald, przygotowywanie niepodpisanych transakcji czy działanie w ściśle ograniczonych limitach mogą czynić asystenta użytecznym bez dawania mu nieograniczonej władzy wydawania środków.
Zaufanie do portfela zależy od reguł, których model nie może przepisać
EIP-7906, który pozostaje projektem, proponuje ramy asercji po transakcji badające końcowe różnice stanu wywołane przez transakcję. Asercja może odrzucić wynik aplikacji, gdy te zmiany naruszają określony warunek.
Portfel mógłby użyć tego mechanizmu, aby wymagać, by wymiana zmieniła wyłącznie zatwierdzone salda, by nigdy nie pojawiło się ukryte zezwolenie na token albo by stan chronionego konta pozostał nietknięty. Te sprawdzenia porównują rzeczywiste skutki transakcji z jawnymi regułami.
Projekt opisuje też granice ochrony. Asercja sprawdzająca za mało może stworzyć fałszywe poczucie pewności. Logika walidacji portfela musi wymagać właściwej ramy asercji, a sama asercja musi obejmować każdą istotną zmianę stanu dla chronionej operacji.
Lokal inferencja i asercje transakcyjne rozwiązują różne części problemu agenta portfelowego. Model lokalny chroni kontekst i zamiera intencję w języku naturalnym na proponowane działanie; deterministyczne uprawnienia ograniczają odbiorców, kontrakty, wartość i częstotliwość; asercje badają końcowe zmiany stanu. Potwierdzenie przez człowieka pozostaje drugim czynnikiem dla ryzykownych działań.
Wrześniowy wynik na laptopie wzmacnia wiarygodność pierwszej warstwy. Sugeruje, że prywatny model lokalny może reagować wystarczająco szybko, by koordynować codzienną pracę i selektywnie korzystać z zdalnej inteligencji. Pozostałe warstwy nadal niosą autorytet chroniący aktywa.
Portfel krypto może traktować model jako sprawny interfejs, planistę i monitor. Zaufanie należy do kontroli, których model nie może zmienić, oraz do ścieżki zatwierdzania, która utrzymuje użytkownika w rzeczywistym rozstrzygającym wpływie.
Źródło: CryptoSlate za pośrednictwem CryptoNewsNet.

