Postęp medycznego AI wyprzedza dowody na lepsze wyniki leczenia pacjentów
Najważniejsze informacje
- •Badanie z randomizacją w 16 placówkach Penda Health w Kenii wykazało, że wsparcie dużych modeli językowych poprawiło dokumentację i jakość diagnoz, ale nie zmniejszyło istotnie częstości niepowodzeń leczenia po 14 dniach, które wystąpiło u 2,2% grupy z AI wobec 2% grupy kontrolnej.
- •Amerykańska FDA opublikowała 18 sierpnia dokument dyskusyjny dotyczący regulacji urządzeń medycznych opartych na generatywnym AI, otwarty na komentarze publiczne do 19 października, obejmujący ocenę ryzyka, ocenę przedwpuszczającą i monitorowanie powymarketowe.
- •Wielokrajowe badanie wykazało, że GPT-4o poprawił wyniki 249 lekarzy w winietach klinicznych o 7,2–18%, ale badanie wykorzystało przypadki symulowane i nie oceniało szkód, więc rzeczywiste korzyści dla pacjentów pozostają niepotwierdzone.
- •Komentarz w npj Digital Medicine ostrzega, że obecność klinicysty w pętli decyzyjnej nie gwarantuje skutecznego nadzoru, ponieważ bias automatyzacji może zwiększać skłonność do akceptacji wadliwych rekomendacji AI.
- •MarketsandMarkets prognozuje wzrost rynku AI w opiece zdrowotnej z 36,67 miliarda dolarów w 2026 roku do 194,79 miliarda dolarów do 2031 roku, przy rocznej stopie wzrostu złożonego 39,7%.
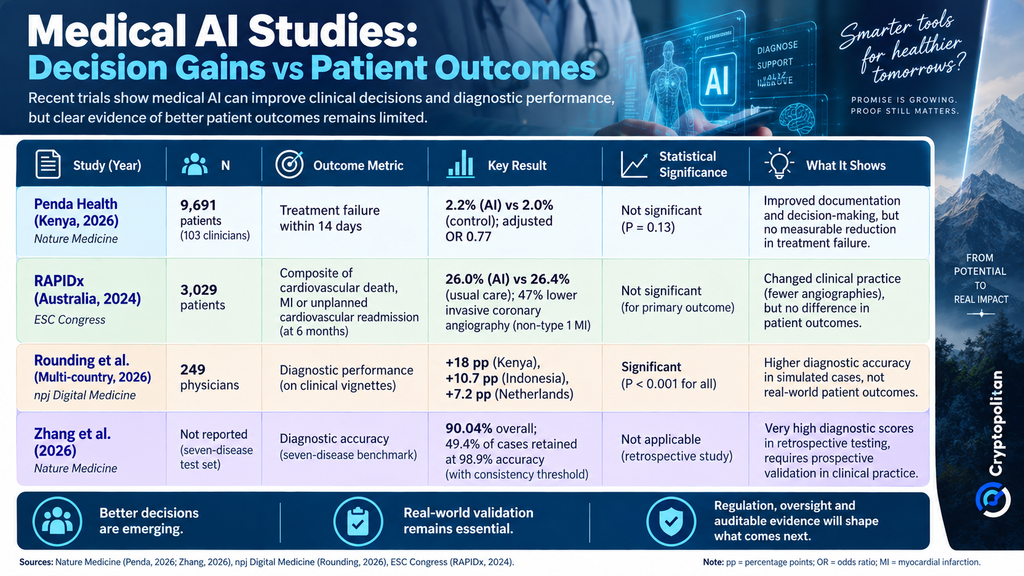
Rosnąca liczba badań w 2026 roku uwypukla utrzymującą się lukę w medycznej sztucznej inteligencji: systemy te mogą wpływać na decyzje lekarzy i przynosić imponujące wyniki diagnostyczne, nie wykazując przy tym, że pacjenci ostatecznie lepiej się czują.
Kwestia ta ma znaczenie dla szpitali oceniających narzędzia AI, firm starających się udowodnić ich wartość oraz regulatorów decydujących, jakie dowody powinny być wymagane po wprowadzeniu tych systemów do praktyki klinicznej.
Regulatorzy przyglądają się problemowi z dowodami w medycznym AI
Rozbieżność między raportowaną skutecznością AI a udowodnionymi korzyściami dla pacjentów staje się coraz trudniejsza do zignorowania. Financial Times podsumował problem w nagłówku: „Medical AI has a proof problem.”
Pytanie wykraczające poza debatę akademicką. Amerykańska Agencja ds. Żywności i Leków (FDA) bada wiele z tych samych kwestii, rozważając, jak oceniać urządzenia medyczne oparte na AI przed wdrożeniem i po nim. Dokument dyskusyjny z 18 sierpnia, otwarty na komentarze publiczne do 19 października, obejmuje ocenę ryzyka, ocenę przedwpuszczającą oraz monitorowanie po wprowadzeniu na rynek.
FDA podkreśliła, że dokument jest wyłącznie dokumentem dyskusyjnym. Nie jest projektem wytycznych, proponowaną zmianą polityki ani wskazówką co do przyszłych oczekiwań regulacyjnych. M to otwarty okres komentarzy daje szpitalom, producentom urządzeń i badaczom formalny kanał przedstawienia, jakiego rodzaju dowody ich zdaniem powinno wymagać wdrożenie kliniczne.
Poprzednie wezwanie FDA do komentarzy publicznych dotyczące mierzenia i oceny rzeczywistej skuteczności urządzeń medycznych opartych na AI podniosło również kwestię dryfu modelu oraz ograniczeń polegania na statycznych metrykach. Dryf modelu — degradacja, która może wystąpić, gdy rzeczywści pacjenci lub wzorce praktyki klinicznej odbiegają od danych treningowych modelu — to jeden z powodów, dla których narzędzie zwalidowane w momencie wprowadzenia może działać inaczej kilka miesięcy później. Pozostaje szersze pytanie: jak mierzyć bezpieczeństwo i skuteczność po tym, jak system AI opuści laboratorium i trafi do opieki klinicznej?
Wsparcie AI nie zmniejszyło liczby niepowodzeń leczenia w Kenii
Badanie opublikowane w Nature Medicine 26 czerwca sprawdziło, czy LLM wykorzystywany do podejmowania decyzji klinicznych poprawia wyniki leczenia pacjentów. W badaniu wzięło udział 103 oficerów klinicznych w 16 placówkach Penda Health w hrabstwach Nairobi i Kiambu. Oficerowie lecili pacjentów z pomocą dużego modelu językowego lub bez niej.
Z 9 691 zarejestrowanych pacjentów 9 347 włączono do analizy głównej. Niepowodzenie leczenia po 14 dniach wystąpiło u 2,2% grupy z AI i u 2% grupy kontrolnej. Skorygowany iloraz szans wyniósł 0,77, ale różnica nie była statystycznie istotna (P=0,13). Nie odnotowano poważnych zdarzeń niepożądanych związanych z interwencją.
Grupa wspierana przez AI wykazała lepszą dokumentację oraz bardziej odpowiednie diagnozy i plany leczenia. Jednak te poprawki w metrykach procesu nie przełożyły się na poprawę wyników leczenia pacjentów. Ta luka stanowi sedno problemu z dowodami: metryki takie jak jakość dokumentacji i diagnozy są znacznie łatwiejsze do zebrania niż wyniki takie jak niepowodzenie leczenia, ale wyniki z Penda sugerują, że mogą one zmieniać się niezależnie.
Podobny wzorzec pojawił się w badaniu RAPIDx AI z 2024 roku. Wśród 3 029 pacjentów w analizie głównej złożony sześciomiesięczny wynik — śmierć sercowo-naczyniowa, zawał mięśnia sercowego lub niezaplanowana rehospitalizacja kardiologiczna — wystąpił u 26% pacjentów otrzymujących opiekę wspieraną przez AI wobec 26,4% leczonych standardowo. W grupie z zawałem innym niż typu 1 inwazyjna koronarografia była jednak wykonywana o 47% rzadziej przy opiece wspieranej przez AI.
Wyższe wyniki testów nie potwierdziły korzyści w świecie rzeczywistym
Wielokrajowe badanie z randomizacją pod kierownictwem Nicholasa Roundinga wykazało, że GPT4o poprawił wyniki 249 lekarzy w testach na winietach klinicznych o 18% w Kenii, 10,7% w Indonezji i 7,2% w Holandii (P<0,001). Badanie wykorzystało jednak przypadki symulowane, a nie rzeczywiste sytuacje kliniczne. Uczestnicy grupy kontrolnej nie mogli korzystać z internetu ani protokołów klinicznych, a badanie nie oceniało szkód.
Wyniki pokazują, że AI może poprawiać wydajność w warunkach kontrolowanych, ale nie potwierdzają wpływu na wyniki leczenia pacjentów. Rozróżnienie między warunkami kontrolowanymi a światem rzeczywistym to dokładnie ten obszar, na który celują pytania FDA dotyczące oceny przedwpuszczającej i powymarketowej.
Inne badanie w Nature Medicine autorstwa Li Zhanga, Jakoba Nikolasa Kathera i współpracowników wykazało dokładność 90,04% na test porównawczym obejmującym siedem chorób. Dzięki zastosowaniu progu spójności agent na miejscu zatrzymał 49,4% przypadków z dokładnością 98,9%, podczas gdy pozostałe przypadki trafiły do przeglądu przez specjalistów. Autorzy stwierdzili, że wyniki wymagają dalszego potwierdzenia w badaniach prowadzonych w rzeczywistych warunkach klinicznych. Badanie jest dostępne tutaj.
Lekarz w pętli decyzyjnej to za mało
Mapa dowodowa opracowana przez Joy Xu, Justina Ko i Josepha Kvedara wykazała, że agentowe AI jest wykorzystywane nie tylko do pracy administracyjnej, ale także do diagnostyki, zarządzania i innych zadań opieki zdrowotnej. W konsekwencji coraz większego znaczenia nabiera zdolność zarządzania i audytowania tych systemów. Mapa dowodowa jest dostępna tutaj.
Osobny komentarz w npj Digital Medicine argumentował, że sam udział klinicysty nie gwarantuje skutecznego nadzoru ani ładu. Autoumatyzacja błędu (bias automatyzacji) może sprawiać, że ludzie chętniej akceptują wadliwe rekomendacje. Sensowny nadzór wymaga wystarczającej wiedzy, czasu i uprawnień do kwestionowania systemu i interwencji w razie potrzeby.
Bez tych warunków, ostrzegają autorzy, nadzór ludzki może stać się niewiele więcej niż zabezpieczeniem przed odpowiedzialnością:
Odpowiedzialność może spaść na klinicystów, od których oczekuje się wychwytywania błędów, których nie są w stanie dobrze wykryć ani skorygować … moralna strefa zgniotu.
Debata wykracza zatem poza kwestię, czy człowiek jest technicznie „w pętli”. Dotyczy również tego, czy dana osoba jest wyposażona w to, by kwestionować, nadpisywać i zatrzymywać system w razie potrzeby. Komentarz jest dostępny tutaj.
Stawki komercyjne zwiększają znaczenie dowodów
MarketsandMarkets prognozuje, że rynek AI w opieceotnej wzrośnie z 36,67 miliarda dolarów w 2026 roku do 194,79 miliarda dolarów do 2031 roku, co stanowi roczną stopę wzrostu złożonego na poziomie 39,7%. Prognoza rynkowa pojawia się w momencie, gdy szpitale przygotowują się do coraz większej liczby decyzji zakupowych dotyczących AI, podczas gdy dowody na poprawę wyników leczenia pacjentów pozostają nierówne.
Taka sytuacja może zwiększyć presję na formy walidacji trudniejsze do marketingu, ale cenniejsze dla dostawców: badania prospektywne, lokalny monitoring wydajności i nadzór, który można niezależnie audytować. Jednym z bliskich wskaźników będą uwagi, jakie FDA otrzyma do dokumentu dyskusyjnego, który pozostaje otwarty na komentarze publiczne do 19 października.

