Badanie ETH Zurich i Anthropic: LLM może zdemaskować anonimowe konta za kilka dolarów
Najważniejsze informacje
- •Potok poprawnie zidentyfikował 226 z 338 użytkowników Hacker News, około 67%, z dokładnością 90%, korzystając wyłącznie z publicznie dostępnych wpisów.
- •Cały benchmark kosztował mniej niż 2000 dolarów, średnio około 1–4 dolary na zidentyfikowany profil, co pokazuje, jak tania stała się deanonimizacja na dużą skalę.
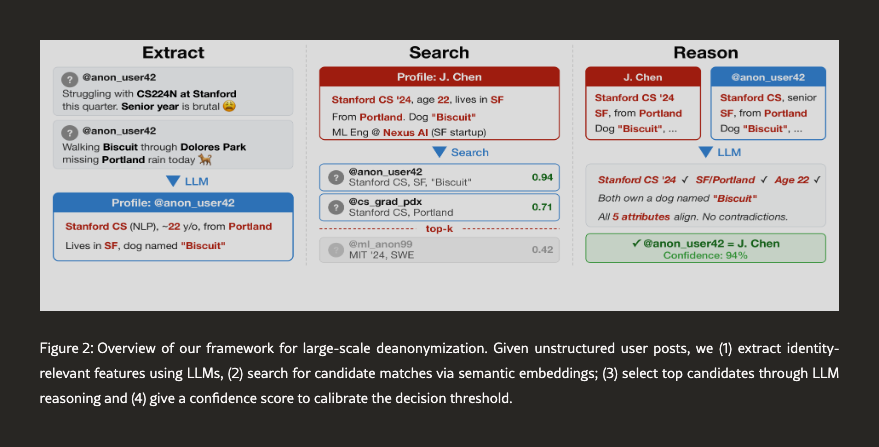
- •System działa w czterech etapach — Extract, Search, Reason i Calibrate — i celowo wstrzymuje się w razie niepewności, aby ograniczyć fałszywe trafienia.
- •Badacze nie opublikowali kodu, promptów ani żadnych rzeczywistych tożsamości, a badanie przeszło kontrolę komisji etyki ETH Zurich przed publikacją.
- •Autorzy konkludują, że praktyczna niepozorność chroniąca pseudonimowe konta już nie obowiązuje, wskazując na ryzyka dla dziennikarzy, aktywistów, celów reklamodawców i użytkowników kryptowalut.
Badacze z ETH Zurich, grupy ds. bezpieczeństwa AI MATS oraz Anthropic zbudowali zautomatyzowany potok oparty na LLM, zdolny do łączenia pseudonimowych wpisów w internecie z tożsamościami w świecie rzeczywistym. W testach system zidentyfikował setki użytkowników Hacker News z dokładnością 90%, przy koszcie zaledwie 1 dolara na użytkownika.
Badanie, "Large-scale online deanonymization with LLMs", zostało po raz pierwszy opublikowane na arXiv 18 lutego, a później ukazało się w materiałach 35. sympozjum USENIX Security, wiodącej akademickiej platformy poświęconej badaniom nad bezpieczeństwem. W tym tygodniu ponownie przyciągnęło uwagę po tym, jak krążyło na X i Reddicie.
Autorami artykułu są Simon Lermen, Daniel Paleka, Joshua Swanson, Michael Aerni, Nicholas Carlini i Florian Tramèr. Carlini jest pracownikiem Anthropic, firmy stojącej za modelami Claude, a pozostali są związani z ETH Zurich i MATS.
Cztery etapy zawężają pulę 89 000 kandydatów
Atak nie wymaga skradzionych danych ani zhakowanych serwerów. Agent korzysta wyłącznie z informacji, które każdy może już zobaczyć publicznie, wykonując pracę cierpliwego śledczego taniej i szybciej.
Badacze podzielili proces na cztery etapy: Extract, Search, Reason i Calibrate. Najpierw model językowy wyodrębnia z surowych wpisów wskazówki dotyczące tożsamości — wzmianki o zawodzie, lokalizacji czy charakterystycznym sposobie formułowania myśli. Następnie osadzenia semantyczne zawężają pulę do 89 000 kandydatów do krótkiej listy. Modelumujący ocenia najlepsze dopasowania i decyduje, czy dwa konta należą do tej samej osoby. Etap Calibrate sprawia, że potok wstrzymuje się od decyzji, gdy nie jest pewny, co ogranicza fałszywe trafienia.
Potok działa na gotowych narzędziach: wyszukiwarce internetowej, osadzeniach i modelach takich jak GPT-5.2. Wcześniejsze ataki deanonimizacyjne, takie jak reidentyfikacja zanonimizowanych ocen Netflixa w 2008 roku, opierały się na danych ustrukturyzowanych. Tamto wydarzenie pokazało, jak rzekomo anonimowe zapisy można zdemaskować przez skrośne odniesienie do informacji zewnętrznych — to данne-оbciażony poprzednik opisanego tutaj zautomatyzowanego, taniego podejścia.
226 z 338 użytkowników Hacker News zidentyfikowanych z dokładnością 90%
Aby ocenić metodę bez narażania prawdziwych osób, zespół zebrał benchmark 338 użytkowników Hacker News — forum technologicznego prowadzonego przez akcelerator startupów Y Combinator — których biografie wskazywały na stronę LinkedIn, co dawało każdemu znaną tożsamość wzorcową. Mając do dyspozycji tylko komentarze i wpisy każdego użytkownika, agent poprawnie zidentyfikował 226 osób — około 67% — z dokładnością 90%. Popełnił 25 błędnych ocen i wstrzymał się w przypadku 86 kont. Klasyczne bazy odniesienia bez LLM uzyskały w większych testach dopasowania wyniki bliskie zeru.
Eksperymenty kosztowały łącznie mniej niż 2000 dolarów, czyli około 1–4 dolary na profil.
Dwa dodatkowe zestawy danych dalej testowały podejście: jeden dopasował użytkowników Reddita między dwoma różnymi społecznościami filmowymi, a drugi odtworzył pojedynczą historię Reddita, dzieląc ją na dwa okresy. W obu przypadkach metody LLM znacznie przewyższyły starsze techniki.
Ostrzeżenia i zabezpieczenia
Autorzy wskazują na szereg potencjalnych nadużyć: rządy wymierzone w dziennikarzy lub aktywistów, firmy tworzące coraz precyzyjniejsze profile reklamowe oraz oszuści sporządzający teczki do ataków inżynierii społecznej.
"Połączenie tych elementów często stanowi unikalny odcisk palca", napisał Lermen w poście na blogu z 24 lutego. Dodał, że jeśli zespół sprytnych śledczych mógłby zidentyfikować kogoś na podstawie jego wpisów, agenci LLM prawdopodobnie też potrafią — a koszty tylko spadają.
Badacze nie opublikow kodu, promptów ani żadnych rzeczywistych tożsamości ujawnionych przez system. Badanie zostało sprawdzone przez komisję etyki ETH Zurich przed publikacją.
"Praktyczna niepozorność chroniąca pseudonimowych użytkowników w internecie już nie obowiązuje" — konkluduje artykuł. To właśnie na takiej niepozorności opierały się do tej pory większość pseudonimowych kont — powszechnych zarówno na forach deweloperskich, jak i w społecznościach kryptowalutowych.
Odnowione zainteresowanie badaniem pojawiło się dzień po tym, jak komisarz SEC Hester Peirce przestrzegła przed masowym zbieraniem danych KYC — know-your-customer, czyli weryfikacją tożsamości, którą firmy finansowe muszą przeprowadzać wobec swoich użytkowników — mówiąc, że takie podejście sprowadza się do "budowania coraz większych stosów danych". Ostatnie naruszenia danych w Revolut oraz u dostawców związanych z producentem portfeli sprzętowych Trezor wzmogły obawy przed "atakami kluczem" (wrench attacks), w których osoba, która dowiedziała się, że ktoś posiada kryptowaluty, zjawia się osobiście.

