Medische AI gaat sneller vooruit dan het bewijs van betere patiëntuitkomsten
Belangrijkste punten
- •Een gerandomiseerde trial op 16 Penda Health-locaties in Kenia toonde aan dat ondersteuning door grote taalmodellen de documentatie en diagnostische kwaliteit verbeterde, maar het aantal behandelingsfalen na 14 dagen niet significant verlaagde: 2,2% in de AI-groep tegen 2% in de controlegroep.
- •De Amerikaanse Food and Drug Administration publiceerde op 18 augustus een discussiepapier over de regulering van generatieve AI-gestuurde medische hulpmiddelen, open voor publieke commentaar tot 19 oktober, waarin risicobeoordeling, evaluatie voorafgaand aan marktintroductie en monitoring na marktintroductie worden behandeld.
- •Een multi-country trial vond dat GPT-4o de prestaties van 249 artsen op klinische vignetten met 7,2% tot 18% verbeterde, maar de studie gebruikte gesimuleerde gevallen en beoordeelde geen schade, dus voordelen voor patiënten in de praktijk blijven onbewezen.
- •Een commentaar in npj Digital Medicine waarschuwde dat een clinicus in de lus geen garantie voor effectief toezicht biedt, omdat automatiseringsbias ertoe kan leiden dat gebrekkige AI-aanbevelingen eerder worden geaccepteerd.
- •MarketsandMarkets voorspelt dat de AI-markt in de gezondheidszorg zal groeien van $36,67 miljard in 2026 naar $194,79 miljard in 2031, een samengestelde jaarlijkse groei van 39,7%.
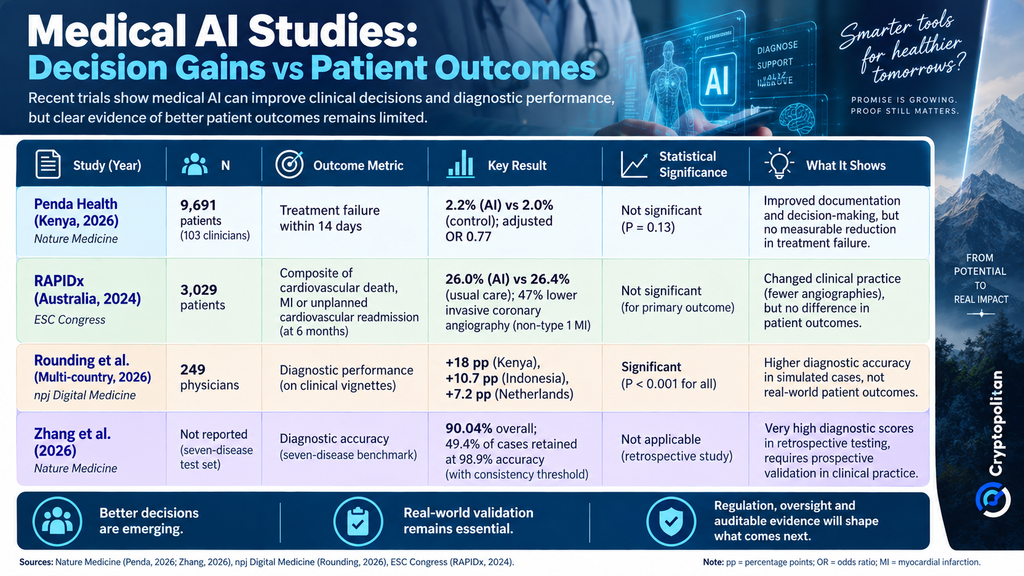
Een groeiende hoeveelheid onderzoek in 2026 benadrukt een aanhoudend gat in medische kunstmatige intelligentie: deze systemen kunnen de beslissingen van artsen beïnvloeden en indrukwekkende diagnostische resultaten opleveren, zonder te tonen dat patiënten er uiteindelijk gezonder van worden.
Het onderwerp is relevant voor ziekenhuizen die AI-tools evalueren, bedrijven die hun waarde willen aantonen en toezichthouders die beslissen welk bewijs vereist moet worden zodra deze systemen in de klinische praktijk worden ingezet.
Toezichthouders prikken in het bewijsprobleem van medische AI
Het gat tussen de gerapporteerde prestaties van AI en aangetoonde voordelen voor patiënten wordt steeds moeilijker te negeren. De Financial Times vatte het probleem samen in een kop: "Medical AI has a proof problem."
De vraag is verder gekomen dan academisch debat. De Amerikaanse Food and Drug Administration onderzoekt veel dezelfde kwesties bij de overweging hoe AI-gestuurde medische hulpmiddelen vóór en na de inzet beoordeeld moeten worden. Een discussiepapier van 18 augustus, open voor publieke input tot 19 oktober, behandelt risicobeoordeling, evaluatie vóór marktintroductie en monitoring ná marktintroductie.
De FDA benadrukte dat het document uitsluitend een discussiepapier is. Het is geen conceptrichtlijn, geen voorgestelde beleidswijing en geen indicatie van toekomstige regulatoire verwachtingen. Desondanks geeft het openstaande reactievindster ziekenhuizen, fabrikanten en onderzoekers een formeel kanaal om uiteen te zetten welk bewijs zij denken dat klinische inzet zou moeten vereisen.
Een eerdere oproep van de FDA voor publieke commentaar over het meten en evalueren van de prestaties in de praktijk van AI-gestuurde medische hulpmiddelen bracht ook zorgen naar voren over modeldrift en de beperkingen van statische meetwaarden. Modeldrift — de verslechtering die kan optreden wanneer patiënten of praktijkpatronen in de echte wereld afwijken van de trainingsdata van een model — is een reden waarom een tool die bij introductie gevalideerd werd, zich maanden later anders kan gedragen. Dat laat een bredere vraag over: hoe moeten veiligheid en effectiviteit worden gemeten nadat een AI-systeem het laboratorium heeft verlaten en de klinische zorg is ingegaan?
AI-ondersteuning verlaagde behandelingsfalen in Kenia niet
Een studie gepubliceerd in Nature Medicine op 26 juni onderzocht of een LLM die voor klinische besluitvorming wordt gebruikt, de uitkomsten voor patiënten verbeterde. De studie betrof 103 clinical officers op 16 Penda Health-locaties in de county's Nairobi en Kiambu. De officers behandelden patiënten met of zonder hulp van een groot taalmodel.
Van de 9.691 geregistreerde patiënten werden 9.347 opgenomen in de primaire analyse. Behandelingsfalen na 14 dagen trad op bij 2,2% van de AI-groep en 2% van de controlegroep. De gecorrigeerde odds ratio was 0,77, maar het verschil was niet statistisch significant (P=0,13). Er waren geen ernstige bijwerkingen gekoppeld aan de interventie.
De AI-ondersteunde groep toonde betere documentatie en passendere diagnoses en behandelplannen. Deze verbeteringen in procesmaatstaven leidden echter niet tot een verbetering van de uitkomsten voor patiënten. Dat gat is de kern van het bewijsprobleem: meetwaarden zoals documentatie en diagnosekwaliteit zijn veel makkelijker te verzamelen dan uitkomsten zoals behandelingsfalen, maar de Penda-resultaten suggereren dat de twee onafhankelijk van elkaar kunnen bewegen.
Een vergelijkbaar patroon verscheen in de RAPIDx AI-trial van 2024. Onder 3.029 patiënten in de primaire analyse trad het samengestelde zesmaanden-resultaat van cardiovasculaire dood, myocardinfarct of ongeplande cardiovasculaire heropname op bij 26% van de patiënten met AI-ondersteunde zorg, tegen 26,4% bij standaardzorg. Binnen de groep met een niet-type 1-myocardinfarct werd invasieve coronaire angiografie echter 47% minder vaak uitgevoerd met AI-ondersteunde zorg.
Hogere testscores hebben geen voordelen in de praktijk aangetoond
Een gerandomiseerde trial in meerdere landen onder leiding van Nicholas Rounding vond dat GPT-4o de prestaties van 249 artsen op klinische vignetten met 18% in Kenia, 10,7% in Indonesië en 7,2% in Nederland verbeterde (P<0,001). Het onderzoek gebruikte echter gesimuleerde gevallen in plaats van echte klinische situaties. Deelnemers in de controlegroep konden geen internet of klinische protocollen gebruiken, en de studie beoordeelde geen schade.
De resultaten tonen aan dat AI prestaties kan verbeteren in gecontroleerde omstandigheden, maar ze bewijzen geen effect op uitkomsten voor patiënten. Precies dat onderscheid tussen gecontroleerd en praktijk is het terrein waarop de FDA-vragen over premarket en postmarket gericht zijn.
Een andere studie in Nature Medicine door Li Zhang, Jakob Nikolas Kather en collega's rapporteerde 90,04% nauwkeurigheid op een benchmark met zeven ziekten. Door een consistentiedrempel toe te passen behield de on-site agent 49,4% van de gevallen met 98,9% nauwkeurigheid, terwijl de overige gevallen door menselijke professionals werden beoordeeld. De auteurs zeiden dat de bevindingen verdere bevestiging vereisen in trials in echte klinische omgevingen. De studie is hier beschikbaar.
Een arts in de lus is niet genoeg
Een evidence map opgesteld door Joy Xu, Justin Ko en Joseph Kvedar toonde aan dat agentic AI niet alleen voor administratief werk wordt gebruikt, maar ook voor diagnose, management en andere taken in de gezondheidszorg. Daardoor wordt het vermogen om deze systemen te besturen en te auditen steeds belangrijker. De evidence map is hier beschikbaar.
Een afzonderlijk commentaar in npj Digital Medicine betoogde dat het loutere feit dat een clinicus betrokken is, geen garantie biedt voor effectief toezicht of goed bestuur. Automatiseringsbias kan mensen ontvankelijker maken voor een gebrekkige aanbeveling. Betekenisvol toezicht vereist voldoende kennis, tijd en autoriteit om het systeem uit te dagen en in te grijpen wanneer nodig.
Zonder die voorwaarden kan menselijk toezicht, waarschuwen de auteurs, niet veel meer zijn dan een aansprakelijkheidsbuffer:
Verantwoordelijkheid kan neerkomen op clinici die verwacht worden fouten op te sporen die zij niet goed kunnen detecteren of corrigeren … een morele crumple zone.
Het debat reikt daarom verder dan of een mens technisch "in de lus" zit. Het gaat er ook om of die persoon in staat is het systeem waar nodig te bevragen, te overrulen en te stoppen. Het commentaar is hier beschikbaar.
Commerciële belangen vergroten belang van bewijs
MarketsandMarkets voorspelt dat de AI-markt in de gezondheidszorg zal groeien van $36,67 miljard in 2026 naar $194,79 miljard in 2031, een samengestelde jaarlijkse groei van 39,7%. De marktprognose komt op een moment dat ziekenhuizen meer AI-aankoopbeslissingen moeten nemen terwijl het bewijs van verbeterde patiëntuitkomsten nog wisselend is.
Die omgeving zou de druk kunnen vergroten voor vormen van validatie die moeilijker te vermarkten zijn maar waardevoller voor zorgverleners: prospectieve tests, lokale prestatiemonitoring en toezicht dat onafhankelijk kan worden geaudite. Een indicatie op korte termijn zal de input zijn die de FDA ontvangt op het discussiepapier, dat openstaat voor publieke commentaar tot 19 oktober.

