ETH Zürich en Anthropic-studie: LLM's kunnen anonieme accounts ontmaskeren voor een paar dollar per stuk
Belangrijkste punten
- •De pijplijn identificeerde correct 226 van 338 Hacker News-gebruikers, ongeveer 67%, met 90% precisie, uitsluitend op basis van publiek toegankelijke berichten.
- •De volledige benchmark kostte minder dan $2.000, gemiddeld ongeveer $1 tot $4 per geïdentificeerd profiel, wat laat zien hoe goedkoop grootschalige de-anonymisatie is geworden.
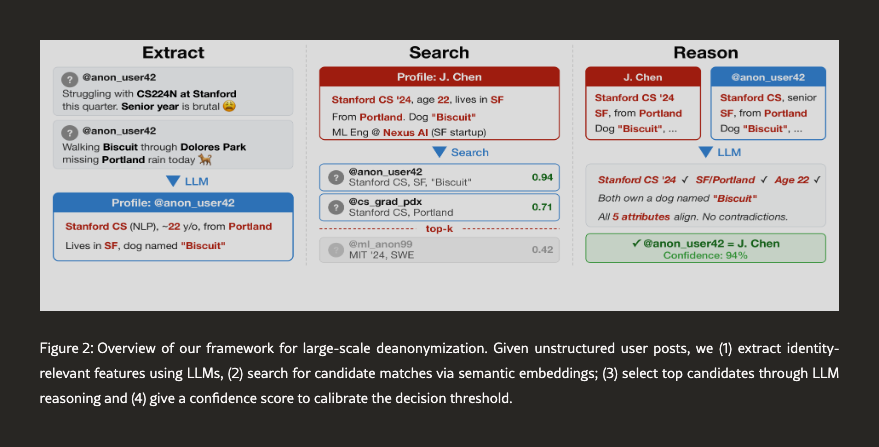
- •Het systeem werkt in vier stappen — Extract, Search, Reason en Calibrate — en onthoudt zich bewust bij onzekerheid om vals-positieve resultaten te verminderen.
- •De onderzoekers hebben de code, prompts of enige echte identiteit niet vrijgegeven, en de studie werd vó publicatie goedgekeurd door de ethische commissie van ETH Zürich.
- •De auteurs concluderen dat de praktische anonimiteit die pseudonieme accounts beschermt niet langer bestaat, met risico's voor journalisten, activisten, doelwitten van adverteerders en cryptogebruikers.
Onderzoekers van ETH Zürich, de AI-veiligheidsgroep MATS en Anthropic hebben een geautomatiseerde LLM-pijplijn gebouwd die pseudonieme onlineberichten kan koppelen aan identiteiten in de echte wereld. Bij tests identificeerde het systeem honderden Hacker News-gebruikers met 90% precisie, tegen kosten van slechts $1 per gebruiker.
De studie, "Large-scale online deanonymization with LLMs", werd op 18 februari voor het eerst op arXiv geplaatst en verscheen later in de proceedings van het 35e USENIX Security Symposium, een toonaangevend academisch platform voor beveiligingsonderzoek. Deze week kreeg het opnieuw aandacht nadat het circuleerde op X en Reddit.
De auteurs van het artikel zijn Simon Lermen, Daniel Paleka, Joshua Swanson, Michael Aerni, Nicholas Carlini en Florian Tramèr. Carlini is medewerker van Anthropic, het bedrijf achter de Claude-modellen, terwijl de anderen verbonden zijn aan ETH Zürich en MATS.
Vier stappen verkleinen een pool van 89.000 kandidaten
De aanval vereist geen gestolen data of gehackte servers. De agent werkt alleen met informatie die iedereen al publiek kan inzien, en verricht het werk van een geduldige onderzoeker — goedkoper en sneller.
De onderzoekers verdeelden het proces in vier stappen: Extract, Search, Reason en Calibrate. Eerst haalt een taalmodel identiteitsaanwijzingen uit ruwe berichten — hints over een baan, een locatie of een kenmerkende schrijfstijl. Vervolgens verkleinen semantische embeddings een pool van maximaal 89.000 kandidaten tot een shortlist. Een redeneermodel beoordeelt de sterkste matches en bepaalt of twee accounts bij dezelfde persoon horen. De Calibrate-stap zorgt ervoor dat de pijplijn zich onthoudt wanneer ze niet zeker is, wat vals-positieve resultaten vermindert.
De pijplijn draait op kant-en-klare tools: webzoekopdrachten, embeddings en modellen zoals GPT-5.2. Eerdere de-anonymisatieraanvallen, zoals de her-identificatie van de geanonimiseerde Netflix-beoordelingen in 2008, waren afhankelijk van gestructureerde data. Dat voorval liet zien hoe zogenaamd anonieme gegevens konden worden ontmaskerd door kruisverwijzingen met externe informatie — een datarijke voorloper van de geautomatiseerde, goedkope aanpak die hier wordt beschreven.
226 van 338 Hacker News-gebruikers geïdentificeerd met 90% precisie
Om de methode te evalueren zonder echte mensen in gevaar te brengen, stelde het team een benchmark samen van 338 Hacker News-gebruikers — het technologieforum van startup-incubator Y Combinator — wiens bio's naar een LinkedIn-pagina verwezen, waardoor elk een bekende geverifieerde identiteit had. Op basis van alleen de reacties en inzendingen van elke gebruiker identificeerde de agent er correct 226 — ongeveer 67% — met 90% precisie. Het systeem deed 25 foutieve oordelen en onthield zich bij 86 accounts. Klassieke niet-LLM-baselines scoorden dicht bij nul in de grotere matchingtests van het artikel.
De experimenten kostten in totaal minder dan $2.000, of ongeveer $1 tot $4 per profiel.
Twee extra datasets testten de aanpak verder: de ene matchte Reddit-gebruikers over twee verschillende filmcommunities heen, en de andere reconstrueerde één Reddit-geschiedenis door deze in twee tijdsperiodes te splitsen. In beide gevallen presteerden de LLM-methoden aanzienlijk beter dan oudere technieken.
Waarschuwingen en waarborgen
De auteurs wijzen op een reeks mogelijke misbruiken: overheden die journalisten of activisten opsporen, bedrijven die steeds scherpere advertentieprofielen opbouwen, en oplichters die dossier samenstellen voor social-engineering.
"De combinatie is vaak een unieke vingerprint", schreef Lermen op 24 februari in een blogpost. Hij voegde eraan toe dat als een team van slimme onderzoekers iemand uit diens berichten kan identificeren, LLM-agents dat waarschijnlijk ook kunnen — en de kosten dalen alleen maar.
De onderzoekers hebben de code, de prompts of enige echte identiteit die door het systeem werd opgespoord niet vrijgegeven. De studie werd vóór publicatie beoordeeld door de ethische commissie van ETH Zürich.
"De praktische anonimiteit die pseudonieme gebruikers online beschermt, bestaat niet langer", concludeert het artikel. Op dat soort anonimiteit hebben de meeste pseudonieme accounts — net zo gewoon op developerforums als in crypto-communities — tot nu toe gesteund.
De hernieuwde aandacht voor de studie kwam één dag nadat SEC-commissaris Hester Peirce had gewaarschuwd tegen bulksgewijze KYC-gegevensverzameling — know-your-customer, de identiteitscontroles die financiële instellingen verplicht zijn uit te voeren op hun gebruikers — en zei dat deze aanpak neerkomt op "steeds grotere databergen bouwen." Recente datalekken bij Revolut en bij leveranciers verbonden aan hardware-portemonnee-maker Trezor hebben de vrees voor "wrench-aanvallen" aangewakkerd, waarbij iemand die erachter komt dat een persoon crypto bezit, fysiek opduikt.

