医療AIの精度向上が進む一方、患者アウトカム改善の証拠は追いつかず
重要ポイント
- •ケニアのPenda Health16施設で実施されたランダム化比較試験では、大規模言語モデルの支援により記録と診断の質は向上したものの、14日以内の治療失敗(AI群2.2%対対照群2%)を有意に減少させることはできなかった。
- •米国食品医薬品局(FDA)は、生成AI搭載医療機器の規制に関する8月18日付ディスカッションペーパーを公表し、リスク評価、上市前評価、上市後モニタリングを扱う内容で、10月19日までパブリックコメントを受け付けている。
- •多国間試験では、GPT-4oが249人の医師の臨床ビネットのパフォーマンスを7.2%〜18%改善したが、研究はシミュレーション症例を使用し有害性の評価も行わなかったため、実世界での患者への便益は未確証のままである。
- •npj Digital Medicine誌の論評は、臨床医がループ内にいても効果的な監督は保証されないと警告した。自動化バイアスにより、欠陥のあるAI推奨が受け入れられやすくなる可能性があるためである。
- •MarketsandMarketsは、ヘルスケアAI市場が2026年の366.7億ドルから2031年までに1,947.9億ドルへ、年平均成長率39.7%で成長すると予測している。
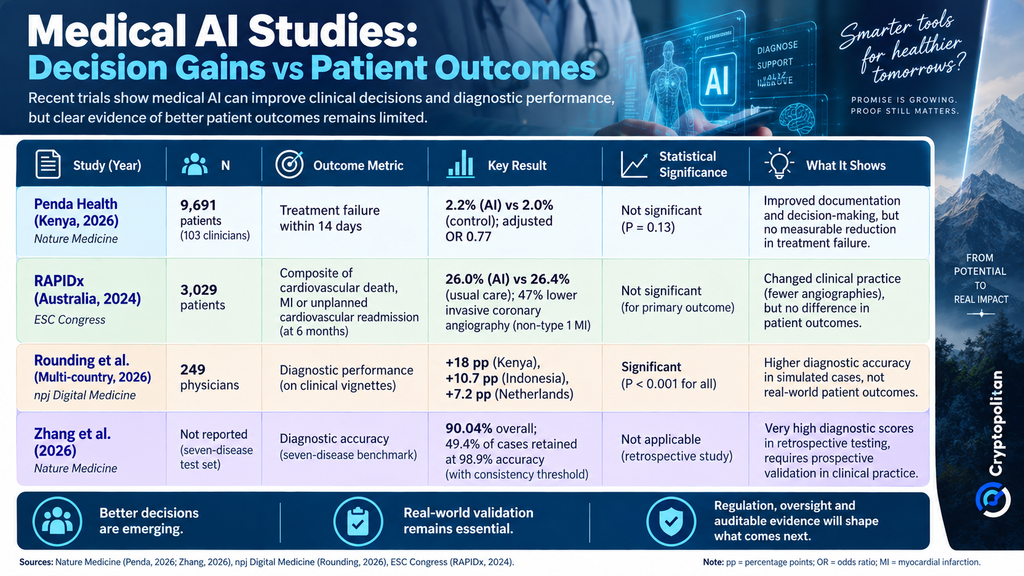
2026年に発表された数多くの研究が、医療人工知能における一貫したギャップを浮き彫りにしている。これらのシステムは医師の意思決定に影響を与え、印象的な診断結果を生み出すことができる一方で、患者が最終的に健康になることを示せていないのだ。
この問題は、AIツールを評価する病院、自社製品の価値を証明しようとする企業、そしてこれらのシステムが臨床現場に導入された後にどのような証拠が求められるべきかを判断する規制当局にとって重要な意味を持つ。
規制当局が注目する医療AIの「証明の問題」
AIの報告された性能と、患者への実証済みの便益との間のギャップは、見過ごすことがますます難しくなっている。英フィナンシャル・タイムズはこの問題をある見出しで要約した:「医療AIには証明の問題がある。」
この問題はもはや学術的な議論の域を超えている。米国食品医薬品局(FDA)は、AI搭載医療機器を導入前と導入後にどのように評価すべきかを検討する中で、同様の多くの問題に目を向けている。10月19日までパブリックコメントを受け付けている8月18日付のディスカッションペーパーは、リスク評価、上市前評価、上市後モニタリングといった論点を扱っている。
FDAは、この文書が単なるディスカッションペーパーであることを強調している。草案段階のガイダンスでも、政策変更の提案でも、将来の規制上の期待を示すものでもない。それでも、コメント受付期間は、臨床での導入にどのような証拠が求められるべきかについて、病院、機器メーカー、研究者が意見を述べる公式の窓口を提供している。
以前にFDAが実施した、AI搭載医療機器の実世界での性能の測定・評価に関するパブリックコメントの募集では、モデルドリフトや静的な指標に依存することの限界について懸念が示された。モデルドリフトとは、実世界の患者や診療パターンがモデルの学習データから乖離した際に生じうる性能低下のことであり、公開時に検証済みのツールが数ヶ月後には異なる挙動を示しうる一つの理由である。ここからより大きな疑問が残る。AIシステムが研究室を離れて臨床現場に入った後、安全性と有効性をどのように測定すべきなのか。
ケニアではAI支援によって治療失敗は減少せず
6月26日にNature Medicine誌に掲載された研究は、臨床意思決定に使用されるLLMが患者アウトカムを改善するかどうかを検証した。この研究では、ナイロビおよびキアンブ郡のPenda Health16施設に勤務する103名の臨床士が参加し、大規模言語モデルの支援あり・なしで患者を診療した。
登録された9,691人の患者のうち、9,347人が主要解析の対象となった。14日後の治療失敗はAI群で2.2%、対照群で2%に発生した。調整後オッズ比は0.77だったが、差は統計的に有意ではなかった(P=0.13)。介入に関連する重篤な有害事象は認められなかった。
AI支援を受けた群では、記録の質が向上し、より適切な診断と治療計画が示された。しかし、こうしたプロセス指標の改善は、患者アウトカムの改善にはつながらなかった。このギャップこそが証明の問題の核心である。記録や診断の質といった指標は治療失敗のようなアウトカムよりもはるかに収集しやすいが、Pendaの結果は、この二者が独立して動きうることを示唆している。
2024年のRAPIDx AI試験でも同様のパターンがみられた。主要解析の3,029人の患者のうち、心血管死、心筋梗塞、または計画外の心血管再入院という6ヶ月の複合アウトカムは、AI支援ケアを受けた患者で26%、標準ケアを受けた患者で26.4%に発生した。ただし、非1型心筋梗塞群では、AI支援ケア下で侵襲的冠動脈造影が47%少ない頻度で実施された。
テストスコアの上昇は実世界での便益を証明していない
Nicholas Rounding氏が主導した多国間ランダム化比較試験では、GPT-4oが249人の医師の臨床ビネット(症例課題)のパフォーマンスを、ケニアで18%、インドネシアで10.7%、オランダで7.2%改善したことが示された(P<0.001)。しかし、この研究では、実世界の臨床状況ではなくシミュレーション症例が使用された。対照群の参加者はインターネットや臨床プロトコルを使用できず、有害性の評価も行われなかった。
この結果は、AIが管理された環境でパフォーマンスを向上させうることを示しているが、患者アウトカムへの影響を証明するものではない。この「管理環境対実世界」という区別こそ、FDAの上市前・上市後の問いが狙いを定めている領域である。
Li Zhang氏、Jakob Nikolas Kather氏らによる別のNature Medicine研究では、7疾患のベンチマークで90.04%の精度が報告された整合性の閾値を適用することで、オンサイトエージェントは49.4%の症例を98.9%の精度で処理し、残りの症例は人間の専門家がレビューした。著者らは、これらの知見には実際の臨床現場での試験によるさらなる検証が必要であると述べている。研究はこちらから閲覧できる。
医師が「ループ内」にいるだけでは不十分
Joy Xu氏、Justin Ko氏、Joseph Kvedar氏らがまとめたエビデンスマップによれば、エージェント型AIは管理業務だけでなく、診断、疾患管理、その他のヘルスケア業務にも使用されつつあり、その結果、こうしたシステムを統制・監査する能力がますます重要になっている。エビデンスマップはこちらから閲覧できる。
npj Digital Medicine誌の別の論評は、臨床医が関与しているだけで効果的な監督やガバナンスが保証されるわけではないと主張した。自動化バイアスにより、欠陥のある推奨が受け入れられやすくなる可能性がある。実質的な監督には、システムに異議を唱え、必要に応じて介入するための十分な知識、時間、権限が求められる。
これらの条件が整わなければ、人間による監督は責任回避の最後の砦にすぎないものになりかねない、と著者らは警告する:
責任は、検出や修正が困難な誤りを捉えることが期待される臨床医に崩れ落ちる可能性がある……いわば「モラル・クランプル・ゾーン(道徳的衝突吸収帯)」である。
したがって、この議論は、人間が技術的に「ループ内」にいるかどうかにとどまらず、その人物がシステムに疑問を呈し、上書きし、必要に応じて停止する能力を備えているかどうかにも及ぶ。論評はこちらから閲覧できる。
商業的利害が証拠の重要性を高める
MarketsandMarketsは、ヘルスケアAI市場が2026年の366.7億ドルから2031年までに1,947.9億ドルへ成長し、年平均成長率39.7%を記録すると予測している。この市場予測が示される中、病院は患者アウトカム改善の証拠がまだら模様である状況で、より多くのAI調達の意思決定を行おうとしている。
こうした環境は、市場での訴求が難しいものの、医療機関にとってより価値のある検証形態、すなわち前向きなテスト、現地での性能モニタリング、そして実際に監査可能な監督体制への圧力を高める可能性がある。近い将来の指標となるのは、10月19日までパブリックコメントを受け付けているFDAのディスカッションペーパーに対して寄せられる意見であろう。

