Vitalik Buterin, cofondatore di Ethereum: l'AI locale può proteggere la privacy senza perdere velocità, ma i wallet necessitano ancora di controlli stringenti
Punti chiave
- •Il post di Buterin segna una svolta rispetto alla sua visione di aprile: i modelli locali su laptop possono ora fungere da interfaccia principale per una quota maggiore di attività, invece che solo per lavori strettamente delimitati.
- •I benchmark sul suo laptop Strix Halo hanno mostrato velocità di elaborazione dell'input da 109,82 a 373,22 token al secondo e generazione dell'output da 18,42 a 33,37 token al secondo su 10 carichi di lavoro.
- •Qwen3.8-Flash-Next di Alibaba, open-weight, è un modello mixture-of-experts con 125 miliardi di parametri che ne attiva solo 6 miliardi per token, e ha superato il più grande Qwen3.7-Plus su 8 dei 14 benchmark.
- •I benchmark standard di capacità non misurano la resistenza al prompt injection, l'autorizzazione del wallet o la correttezza delle azioni finanziarie autonome, lasciando irrisolta la questione del controllo AI degli asset crittografici.
- •Le salvaguardie proposte includono la regola di approvazione 2-of-2 umano più modello di Buterin per le transazioni rischiose, i limiti di spesa definiti dal software, il wallet on-device Steward finanziato dall'Ethereum Foundation e la bozza dello standard EIP-7906 per le asserzioni di stato post-transazione.
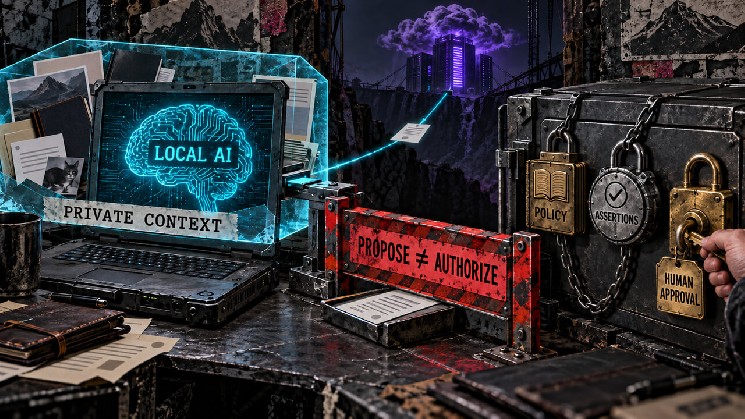
Il cofondatore di Ethereum Vitalik Buterin afferma che l'intelligenza artificiale basata su laptop si avvicina a un punto di svolta pratico — sebbene il software dei wallet debba ancora superare una soglia molto più alta prima che un'AI possa essere ritenuta affidabile per il controllo degli asset crittografici.
In un post del 17 settembre, Buterin ha detto che Qwen 3.8 Flash e i recenti miglioramenti a llama.cpp — il progetto open source per eseguire grandi modelli linguistici direttamente su hardware locale — hanno avvicinato i modelli locali alla capacità di gestire una "larga quota" delle attività sul suo laptop Strix Halo. Per lavori più avanzati, ha descritto un modello locale che coordina le richieste verso sistemi remoti più potenti, nascondendo il contesto personale completo dell'utente.
Un'immagine di benchmark allegata al post mostrava 10 carichi di lavoro. Le velocità di elaborazione dell'input riportate variavano da 109,82 a 373,22 token al secondo, mentre la generazione dell'output variava da 18,42 a 33,37 token al secondo. Questi dati supportano un'affermazione pratica sulla reattività di un singolo laptop di fascia alta, ma lasciano senza risposta il giudizio del modello, la resistenza alle istruzioni dannose e l'autorizzazione delle transazioni.
L'inferenza locale può migliorare la privacy mentre il potere di spostare fondi rimane dietro controlli separati e applicabili.
Cosa è cambiato tra aprile e settembre
In una descrizione di aprile della sua configurazione di AI locale, Buterin descriveva un ruolo più limitato per i modelli su laptop. Scrisse che Qwen3.5:35B poteva gestire attività delimitate e lavoro di programmazione familiare, mentre agenti indipendenti avanzati capaci di proseguire il lavoro su una codebase restavano oltre la portata pratica dei laptop. Il lavoro di programmazione e intellettuale più impegnativo richiedeva ancora modelli remoti più potenti.
Il post di settembre sposta la sua valutazione di dove si collochi il confine pratico. Un modello locale appare più limitato a trascrizione, riassunto o altro lavoro strettamente delimitato. Nella descrizione più recente, può fungere da interfaccia principale per una quota maggiore delle attività e decidere quando è necessario un modello remoto. Un servizio remoto riceve solo la domanda o il contesto che il modello locale seleziona — non ogni file, messaggio e dettaglio del wallet necessari per comprendere la situazione più ampia dell'utente. Il sistema locale diventa insieme gatekeeper delle informazioni e assistente.
Aprile e settembre riguardavano generazioni di modelli e attività diverse. Il post di settembre fornisce conteggi di token e throughput, ma omette i contenuti dei prompt, le scelte di quantizzazione e la configurazione completa del runtime.
Qwen3.8-Flash-Next, rilasciato dal team Qwen di Alibaba, è un modello multimodale open-weight a mixture-of-experts. Il suo modello principale ha 125 miliardi di parametri, più altri 51 miliardi in tabelle di embedding n-gram, mentre vengono attivati 6 miliardi di parametri per token. La distribuzione open-weight significa che il modello può essere scaricato ed eseguito interamente sulla macchina dell'utente — l'assetto che rende possibile l'inferenza locale e privata. Il repository ufficiale documenta l'inferenza locale di testo e visione tramite llama.cpp utilizzando build GGUF quantizzate.
Attivare una frazione del modello per ogni token riduce il carico computazionale. L'utente ha comunque bisogno di memoria sufficiente per la build e il contesto scelti, e i materiali ufficiali non forniscono un singolo minimo hardware applicabile a tutti i livelli di quantizzazione e ai carichi di lavoro.
I benchmark di capacità lasciano irrisolta l'autorità sul wallet
La relazione tecnica di Qwen valuta il modello di base su 14 benchmark che coprono conoscenza generale, matematica, scienze, ragionamento, programmazione e comprensione multilingue. Il team Qwen ha riferito che Flash-Next ha superato il più grande modello di base Qwen3.7-Plus su otto di questi test, utilizzando meno parametri attivati e meno calcolo di addestramento.
La relazione copre capacità, efficienza e stabilità dell'addestramento del modello. La resistenza al prompt injection, l'applicazione delle policy, l'autorizzazione del wallet e la correttezza delle azioni finanziarie autonome restano fuori da quel insieme di benchmark.
Un assistente può spiegare privatamente una transazione, preparare calldata o suggerire un percorso. Un firmatario può effettuare una richiesta irreversibile che trasferisce asset o concede a un altro contratto il permesso di spostarli. Un ragionamento migliore riduce alcuni errori, eppure un'istruzione dannosa nascosta in un sito web, in un messaggio o nella descrizione di una transazione può comunque deviare il piano del modello.
L'ecosistema Ethereum sta già testando una versione on-device del concetto di assistente. Nel suo aggiornamento di allocazione del secondo trimestre, l'Ethereum Foundation ha elencato Steward, un wallet smart-account macOS completamente locale il cui light client e assistente AI sono pensati per girare sul dispositivo. La divulgazione stabilisce finanziamenti e ambito del progetto, ma non chiarisce il rilascio in produzione, lo stato dell'audit indipendente e l'autorità per le transazioni autonome. Questi punti aperti sono gli indicatori da seguire mentre gli assistenti wallet on-device passano dalle divulgazioni di finanziamento al software distribuito.
Le indicazioni di aprile di Buterin sui wallet collocavano quell'autor al di fuori del modello linguistico. Ha descritto un firewall di conferma umana per le azioni rischiose, limiti deterministici sugli importi delle transazioni, il calldata e il numero di transazioni, e una regola 2-of-2 umano più modello. Il modello può riconoscere uno schema di truffa che una persona distratta non nota, mentre una persona può respingere un'azione dopo che contenuti dannosi hanno manipolato il modello. Richiedere entrambe le approvazioni per le transazioni rischiose impedisce a uno dei due partecipanti di diventare silenziosamente l'unico punto di fiducia.
L'automazione a basso rischio può rimanere disponibile entro permessi definiti dal software. Leggere i saldi, preparare transazioni non firmate o operare entro limiti strettamente vincolati può rendere un assistente utile senza concedergli un potere di spesa illimitato.
La fiducia nei wallet dipende da regole che il modello non può riscrivere
EIP-7906, che resta una bozza, propone frame di asserzione post-transazione che ispezionano le differenze di stato finali prodotte da una transazione. Un'asserzione può respingere l'esito dell'applicazione quando tali modifiche violano una condizione specificata.
Un wallet potrebbe usare tale meccanismo per richiedere che uno swap abbia modificato solo saldi approvati, che non sia mai comparsa un'approvazione di token nascosta o che lo stato di un account protetto sia rimasto intatto. Questi controlli confrontano gli effetti effettivi di una transazione con regole esplicite.
La bozza descrive anche i limiti della protezione. Un'asserzione che verifica troppo poco può creare falsa fiducia. La logica di validazione del wallet deve richiedere il frame di asserzione previsto, e l'asserzione stessa deve coprire ogni modifica di stato rilevante per l'operazione protetta.
L'inferenza locale e le asserzioni sulle transazioni risolvono parti diverse del problema wallet-agent. Il modello locale protegge il contesto e trasforma l'intento in linguaggio naturale in un'azione proposta; i permessi deterministici limitano destinatari, contratti, valore e frequenza; le asserzioni ispezionano le modifiche finali di stato. La conferma umana resta il secondo fattore per le azioni rischiose.
Il risultato di settembre sul laptop rende il primo livello più credibile. Suggerisce che un modello locale privato possa rispondere abbastanza rapidamente da coordinare il lavoro quotidiano e usare selettivamente l'intelligenza remota. I livelli rimanenti conservano ancora l'autorità che protegge gli asset.
Un wallet crittografico può trattare il modello come un'interfaccia, un pianificatore e un monitor capaci. La fiducia appartiene ai controlli che il modello non può alterare e a un percorso di approvazione che mantiene l'utente concretamente al comando.
Fonte: CryptoSlate via CryptoNewsNet.

