I progressi dell'AI medica superano le evidenze di migliori risultati per i pazienti
Punti chiave
- •Uno studio randomizzato in 16 strutture Penda Health in Kenya ha rilevato che il supporto dei large language model ha migliorato documentazione e qualità diagnostica, ma non ha ridotto in modo significativo i fallimenti terapeutici a 14 giorni, verificatisi nel 2,2% del gruppo AI contro il 2% dei controlli.
- •La Food and Drug Administration statunitense ha pubblicato un discussion paper il 18 agosto sulla regolamentazione dei dispositivi medici basati su AI generativa, aperto ai commenti pubblici fino al 19 ottobre, che affronta valutazione del rischio, valutazione pre-commercializzazione e monitoraggio post-commercializzazione.
- •Uno studio multicentrico ha rilevato che GPT-4o ha migliorato le prestazioni di 249 medici su vignette cliniche del 7,2% al 18%, ma lo studio ha utilizzato casi simulati e non ha valutato i danni, quindi i benefici reali per i pazienti restano non dimostrati.
- •Un commento su npj Digital Medicine ha avvertito che la presenza di un clinico nel loop non garantisce una supervisione efficace, poiché l'automation bias può rendere più probabile l'accettazione di raccomandazioni AI difettose.
- •MarketsandMarkets prevede che il mercato dell'AI sanitaria crescerà da 36,67 miliardi di dollari nel 2026 a 194,79 miliardi di dollari entro il 2031, con un tasso di crescita annuo composto del 39,7%.
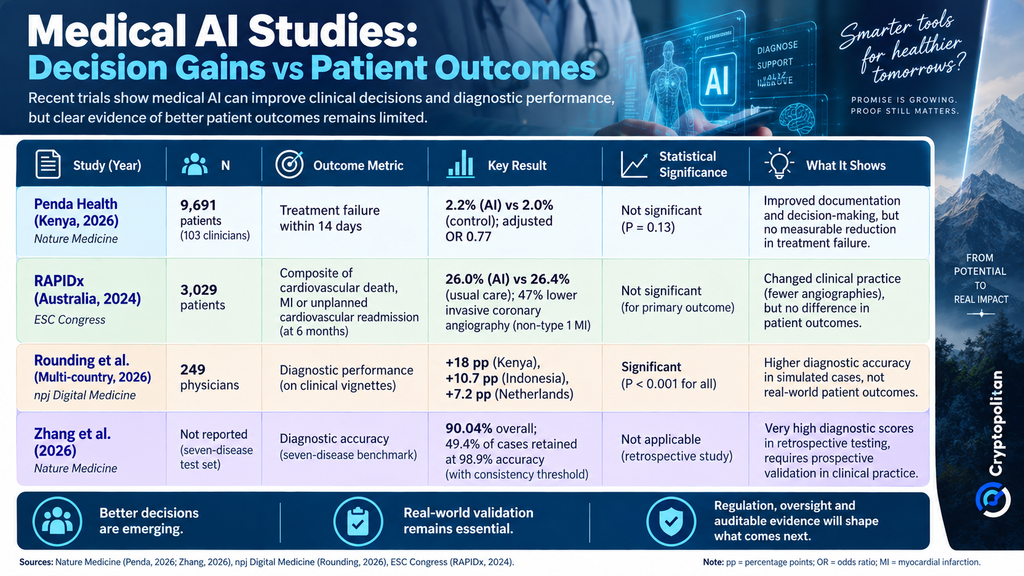
Un corpus crescente di ricerche nel 2026 sta evidenziando un divario persistente nell'intelligenza artificiale medica: questi sistemi possono influenzare le decisioni dei medici e produrre risultati diagnostici impressionanti senza dimostrare che i pazienti alla fine diventino più sani.
La questione è rilevante per gli ospedali che valutano gli strumenti di AI, le aziende che cercano di dimostrarne il valore e i regolatori che decidono quali evidenze dovrebbero essere richieste dopo l'ingresso di questi sistemi nella pratica clinica.
I regolatori esaminano il problema delle prove dell'AI medica
Il divario tra le prestazioni dichiarate dell'AI e i benefici dimostrati per i pazienti sta diventando sempre più difficile da ignorare. Il Financial Times ha riassunto la questione in un titolo: "L'AI medica ha un problema di prove."
La questione ha superato il dibattito accademico. La Food and Drug Administration statunitense sta esaminando molte delle stesse problematiche mentre valuta come analizzare i dispositivi medici basati su AI prima e dopo il loro impiego. Un discussion paper del 18 agosto, aperto ai contributi pubblici fino al 19 ottobre, affronta la valutazione del rischio, la valutazione pre-commercializzazione e il monitoraggio post-commercializzazione.
La FDA ha sottolineato che il documento è esclusivamente un discussion paper. Non è una bozza di linea guida, una proposta di modifica normativa o un'indicazione delle future aspettative regolatorie. Tuttavia, la finestra aperta ai commenti offre a ospedali, produttori di dispositivi e ricercatori un canale formale per esporre quali tipi di evidenze ritengono dovrebbero essere richieste per l'impiego clinico.
Una precedente richiesta di commenti pubblici della FDA sulla misurazione e valutazione delle prestazioni reali dei dispositivi medici basati su AI aveva sollevato anche preoccupazioni sul model drift e sui limiti dell'uso di metriche statiche. Il model drift — il degrado che può verificarsi quando i pazienti reali o i modelli di pratica si discostano dai dati di addestramento di un modello — è una delle ragioni per cui uno strumento validato al lancio può comportarsi in modo diverso mesi dopo. Resta dunque una domanda più ampia: come dovrebbero essere misurati sicurezza ed efficacia dopo che un sistema di AI esce dal laboratorio ed entra nella cura clinica?
Il supporto dell'AI non ha ridotto i fallimenti terapeutici in Kenya
Uno studio pubblicato su Nature Medicine il 26 giugno ha esaminato se un LLM utilizzato per il processo decisionale clinico migliorasse i risultati dei pazienti. Lo studio ha coinvolto 101—corretto: 103—ufficiali clinici in 16 strutture Penda Health nelle contee di Nairobi e Kiambu. Gli ufficiali trattavano i pazienti con o senza l'assistenza di un large language model.
Dei 9.691 pazienti registrati, 9.347 sono stati inclusi nell'analisi primaria. Il fallimento terapeutico dopo 14 giorni si è verificato nel 2,2% del gruppo AI e nel 2% del gruppo di controllo. L'odds ratio aggiustato era 0,77, ma la differenza non era statisticamente significativa (P=0,13). Nessun evento avverso grave è stato associato all'intervento.
Il gruppo supportato dall'AI ha mostrato una documentazione migliore e diagnosi e piani terapeutici più appropriati. Tuttavia, questi miglioramenti nelle metriche di processo non hanno prodotto un miglioramento dei risultati per i pazienti. Questo divario è il cuore del problema delle prove: metriche come la qualità della documentazione e della diagnosi sono molto più facili da raccogliere rispetto a esiti come il fallimento terapeutico, ma i risultati di Penda suggeriscono che le due possono muoversi indipendentemente.
Un quadro simile è emerso nello studio RAPIDx AI del 2024. Tra i 3.029 pazienti dell'analisi primaria, l'esito composito a sei mesi di morte cardiovascolare, infarto miocardico o riospedalizzazione cardiovascolare non programmata si è verificato nel 26% dei pazienti che ricevevano cure supportate dall'AI, contro il 26,4% di quelli sottoposti a cure standard. Nel gruppo con infarto miocardico non di tipo 1, tuttavia, l'angiografia coronarica invasiva è stata eseguita con una frequenza inferiore del 47% con le cure supportate dall'AI.
Punteggi più alti nei test non hanno stabilito benefici reali
Uno studio randomizzato multicentrico guidato da Nicholas Rounding ha rilevato che GPT-4o ha migliorato le prestazioni di 249 medici su vignette cliniche del 18% in Kenya, del 10,7% in Indonesia e del 7,2% nei Paesi Bassi (P<0,001). La ricerca, tuttavia, ha utilizzato casi simulati anziché situazioni cliniche reali. I partecipanti del gruppo di controllo non potevano usare internet o i protocolli clinici, e lo studio non ha valutato i danni.
I risultati mostrano che l'AI può migliorare le prestazioni in contesti controllati, ma non stabiliscono un effetto sui risultati dei pazienti. Questa distinzione tra contesto controllato e mondo reale è esattamente il terreno su cui puntano le domande pre e post-commercializzazione della FDA.
Un altro studio su Nature Medicine di Li Zhang, Jakob Nikolas Kather e colleghi ha riportato una accuratezza del 90,04% su un benchmark di sette malattie. Applicando una soglia di coerenza, l'agente locale ha trattenuto il 49,4% dei casi con un'accuratezza del 98,9%, mentre i restanti casi sono stati esaminati da professionisti umani. Gli autori hanno dichiarato che i risultati richiedono ulteriore conferma through studi condotti in contesti clinici reali. Lo studio è disponibile qui.
Un medico nel loop non basta
Una mappa delle evidenze redatta da Joy Xu, Justin Ko e Joseph Kvedar ha rilevato che l'AI agentica viene utilizzata non solo per il lavoro amministrativo, ma anche per diagnosi, gestione e altri compiti sanitari. Di conseguenza, la capacità di governare e verificare questi sistemi sta diventando sempre più importante. La mappa delle evidenze è disponibile qui.
Un commento separato su npj Digital Medicine sostiene che la semplice presenza di un clinico non garantisce una supervisione o una governance efficace. L'automation bias può rendere le persone più propense ad accettare una raccomandazione difettosa. Una supervisione significativa richiede conoscenze, tempo e autorità sufficienti per contestare il sistema e intervenire quando necessario.
Senza queste condizioni, avvertono gli autori, la supervisione umana può ridursi a poco più che una garanzia di responsabilità:
La responsabilità può ricadere sui clinici, ai quali ci si aspetta che individuino errori che non sono in una buona posizione per rilevare o correggere … una zona di crumpling morale.
Il dibattito si estende quindi oltre la questione se un essere umano sia tecnicamente "nel loop". Riguarda anche se quella persona sia effettivamente in grado di mettere in discussione, superare e fermare il sistema quando necessario. Il commento è disponibile qui.
Gli interessi commerciali aumentano l'importanza delle evidenze
MarketsandMarkets prevede che il mercato dell'AI sanitaria crescerà da 36,67 miliardi di dollari nel 2026 a 194,79 miliardi di dollari entro il 2031, con un tasso di crescita annuo composto del 39,7%. La previsione di mercato arriva mentre gli ospedali si preparano ad assumere un numero crescente di decisioni d'acquisto sull'AI, in un contesto in cui le evidenze di miglioramento dei risultati per i pazienti restano disomogenee.
Questo contesto potrebbe aumentare la pressione verso forme di validazione più difficili da commercializzare ma più preziose per i fornitori: test prospettici, monitoraggio locale delle prestazioni e supervisione verificabile in modo indipendente. Un indicatore a breve termine sarà il contributo che la FDAverà sul suo discussion paper, che resta aperto ai commenti pubblici fino al 19 ottobre.

