Lo studio di ETH Zurich e Anthropic rivela che gli LLM possono smascherare account anonimi per pochi dollari ciascuno
Punti chiave
- •La pipeline ha identificato correttamente 226 su 338 utenti di Hacker News, circa il 67%, con una precisione del 90% utilizzando solo post pubblicamente accessibili.
- •L'intero benchmark è costato meno di 2.000 dollari, con una media di circa 1-4 dollari per profilo identificato, evidenziando quanto sia diventata economica la deanonimizzazione su larga scala.
- •Il sistema opera in quattro fasi—Extract, Search, Reason e Calibrate—e si astiene deliberatamente in caso di incertezza per ridurre i falsi positivi.
- •I ricercatori non hanno rilasciato il codice, i prompt né alcuna identità reale, e lo studio ha superato la revisione del comitato etico di ETH Zurich prima della pubblicazione.
- •Gli autori concludono che l'oscurità pratica che protegge gli account pseudonimi non regge più, citando rischi per giornalisti, attivisti, bersagli pubblicitari e utenti crypto.
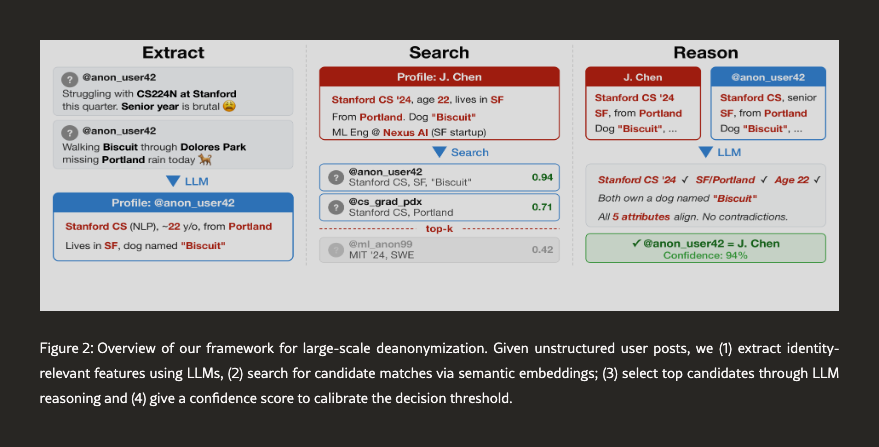
Ricercatori di ETH Zurich, del gruppo per la sicurezza dell'IA MATS e di Anthropic hanno sviluppato una pipeline LLM automatizzata in grado di collegare post pseudonimi online a identità reali. Nei test, il sistema ha identificato centinaia di utenti di Hacker News con una precisione del 90%, a un costo pari ad appena 1 dollaro per utente.
Lo studio, "Large-scale online deanonymization with LLMs", è stato pubblicato per la prima volta su arXiv il 18 febbraio e poi è apparso negli atti del 35° USENIX Security Symposium, un importante sede accademica per la ricerca sulla sicurezza. Ha attirato rinnovata attenzione questa settimana dopo essere circolato su X e Reddit.
Gli autori dell'articolo sono Simon Lermen, Daniel Paleka, Joshua Swanson, Michael Aerni, Nicholas Carlini e Florian Tramèr. Carlini è un dipendente di Anthropic, l'azienda dietro i modelli Claude, mentre gli altri sono affiliati a ETH Zurich e MATS.
Quattro fasi restringono un pool di 89.000 candidati
L'attacco non richiede dati rubati né server violati. L'agente lavora solo con informazioni che chiunque può già visualizzare pubblicamente, svolgendo il lavoro di un investigatore paziente in modo più economico e rapido.
I ricercatori hanno suddiviso il processo in quattro fasi: Extract, Search, Reason e Calibrate. In primo luogo, un linguistico estrae indizi sull'identità dai post grezzi — accenni a un lavoro, a una località o a uno stile di scrittura caratteristico. Le embedding semantiche restringono poi un pool di fino a 89.000 candidati a una shortlist. Un modello di ragionamento valuta le corrispondenze più forti e decide se due account appartengono alla stessa persona. La fase Calibrate fa sì che la pipeline si astenga quando non è certa, riducendo i falsi positivi.
La pipeline si basa su strumenti standard: ricerca web, embedding e modelli come GPT-5.2. Precedenti attacchi di deanonimizzazione, come la reidentificazione del 2008 delle valutazioni anonimizzate di Netflix, si basavano su dati strutturati. Quell'episodio dimostrò come presunti record anonimi potessero essere smascherati incrociando informazioni esterne — un precedente ricco di dati rispetto all'approccio automatizzato e a basso costo qui descritto.
226 su 338 utenti di Hacker News identificati con precisione del 90%
Per valutare il metodo senza rischiare persone reali, il team ha assemblato un benchmark di 338 utenti di Hacker News — il forum tecnologico gestito dall'acceleratore di startup Y Combinator — le cui biografie rimandavano a una pagina LinkedIn, attribuendo a ciascuno un'identità reale nota. Ricevendo solo i commenti e i contributi di ciascun utente, l'agente ne ha identificati correttamente 226 — circa il 67% — con una precisione del 90%. Ha commesso 25 errori e si è astenuto su 86 account. Le basi classiche senza LLM hanno ottenuto punteggi vicini a zero nei test di corrispondenza più ampi dell'articolo.
Gli esperimenti sono costati in totale meno di 2.000 dollari, ovvero circa 1-4 dollari per profilo.
Due ulteriori dataset hanno messo ulteriormente alla prova l'approccio: uno ha abbinato utenti di Reddit attraverso due diverse community di film, l'altro ha ricostruito una singola cronologia Reddit dividendola in due periodi temporali. In entrambi i casi, i metodi basati su LLM hanno superato di gran lunga le tecniche precedenti.
Avvertenze e salvaguardie
Gli autori indicano una serie di potenziali abusi: governi che prendono di mira giornalisti o attivisti, aziende che costruiscono profili pubblicitari sempre più precisi e truffatori che compilano dossier per tentativi di ingegneria sociale.
"La combinazione è spesso un'impronta digitale un", ha scritto Lermen in un post sul blog del 24 febbraio. Ha aggiunto che se un team di investigatori brillanti potesse identificare qualcuno dai suoi post, anche gli agenti LLM probabilmente possono farlo — e il costo continuerà a scendere.
I ricercatori non hanno rilasciato il codice, i prompt né alcuna identità reale emersa dal sistema. Lo studio è stato esaminato dal comitato etico di ETH Zurich prima della pubblicazione.
"L'oscurità pratica che protegge gli utenti pseudonimi online non regge più", conclude l'articolo. È su questo tipo di oscurità che si sono basati finora la maggior parte degli account pseudonimi — comuni sia nei forum di sviluppatori sia nelle community crypto.
Il rinnovato interesse per lo studio è arrivato un giorno dopo che la Commissaria SEC Hester Peirce aveva messo in guardia contro la raccolta massiva di dati KYC — know-your-customer, i controlli di identità che le società finanziarie sono tenute a effettuare sui propri utenti — affermando che tale approccio equivale a "costruire cumuli di dati sempre più grandi". Le recenti violazioni subite da Revolut e da fornitori legati al produttore di hardware wallet Trezor hanno alimentato i timori di "wrench attack", in cui chi scopre che una persona possiede crypto si presenta di persona.

