Les progrès de l'IA médicale dépassent les preuves d'un meilleur devenir des patients
Points clés
- •Un essai randomisé mené dans 16 établissements Penda Health au Kenya a montré que l'assistance par grand modèle de langage améliorait la documentation et la qualité diagnostique, mais ne réduisait pas significativement l'échec thérapeutique à 14 jours, survenu chez 2,2 % du groupe IA contre 2 % des témoins.
- •La Food and Drug Administration américaine a publié un document de discussion le 18 août sur la régulation des dispositifs médicaux reposant sur l'IA générative, ouvert aux commentaires du public jusqu'au 19 octobre, qui aborde l'évaluation des risques, l'évaluation précommercialisation et la surveillance post-commercialisation.
- •Un essai multicentre a révélé que GPT-4o améliorait les performances de 249 médecins sur des vignettes cliniques de 7,2 % à 18 %, mais l'étude portait sur des cas simulés et n'a pas évalué les effets indésirables, de sorte que les bénéfices réels pour les patients restent non établis.
- •Un commentaire publié dans npj Digital Medicine avertit que la présence d'un clinicien dans la boucle ne garantit pas une supervision efficace, car le biais d'automatisation peut favoriser l'acceptation de recommandations erronées de l'IA.
- •MarketsandMarkets prévoit que le marché de l'IA santé passera de 36,67 milliards de dollars en 2026 à 194,79 milliards de dollars d'ici 2031, soit un taux de croissance annuel composé de 39,7 %.
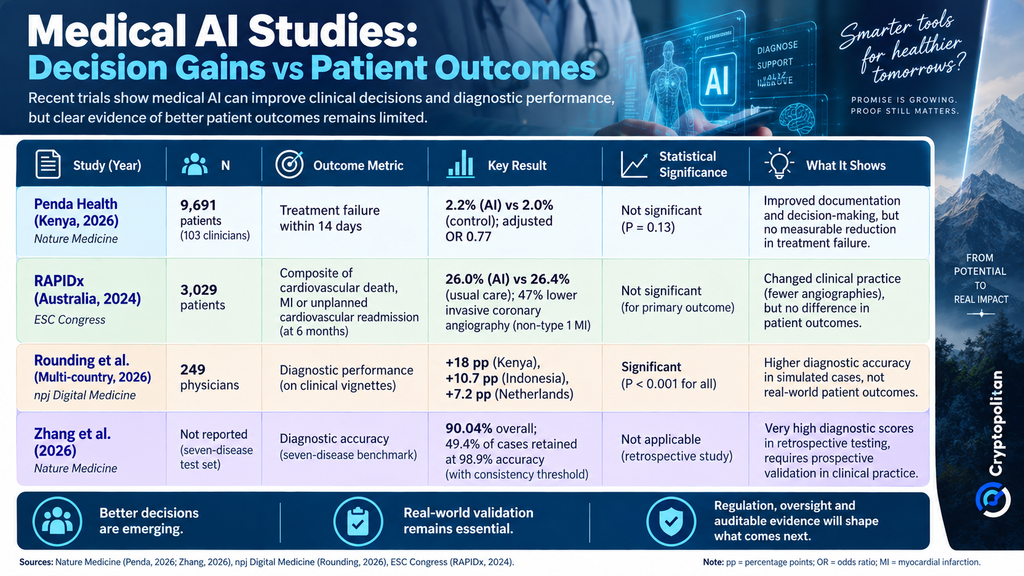
Un nombre croissant d'études en 2026 met en évidence un fossé persistant dans l'intelligence artificielle médicale : ces systèmes peuvent influencer les décisions des médecins et produire des résultats diagnostiques impressionnants sans démontrer que les patients deviennent réellement en meilleure santé.
La question importe aux hôpitaux qui évaluent les outils d'IA, aux entreprises cherchant à démontrer leur valeur et aux régulateurs décidant quelles preuves devraient être exigées une fois ces systèmes entrés dans la pratique clinique.
Les régulateurs scrutent le problème de preuve de l'IA médicale
L'écart entre les performances revendiquées par l'IA et les bénéfices démontrés pour les patients devient de plus en plus difficile à ignorer. Le Financial Times a résumé le problème dans un titre : « L'IA médicale a un problème de preuve. »
La question a dépassé le stade du débat académique. La Food and Drug Administration américaine examine bon nombre des mêmes problématiques alors qu'elle réfléchit à la manière d'évaluer les dispositifs médicaux dotés d'IA avant et après leur déploiement. Un document de discussion du 18 août, ouvert aux contributions du public jusqu'au 19 octobre, aborde l'évaluation des risques, l'évaluation précommercialisation et la surveillance post-commercialisation.
La FDA a souligné que ce document est uniquement un document de discussion. Il ne s'agit ni d'un projet de ligne directrice, ni d'une proposition de changement de politique, ni d'une indication des attentes réglementaires futures. La période de consultation ouverte offre néanmoins aux hôpitaux, aux fabricants de dispositifs et aux chercheurs un canal formel pour exposer les types de preuves qu'ils estiment nécessaires au déploiement clinique.
Une précédente demande de commentaires publics de la FDA sur la mesure et l'évaluation des performances réelles des dispositifs médicaux dotés d'IA a également soulevé des préoccupations concernant la dérive des modèles et les limites des métriques statiques. La dérive des modèles — la dégradation qui peut survenir lorsque les patients réels ou les pratiques divergent des données d'entraînement d'un modèle — qu'un outil validé au lancement puisse se comporter différemment des mois plus tard. Une question plus large demeure : comment mesurer la sécurité et l'efficacité une fois qu'un système d'IA quitte le laboratoire et entre dans les soins cliniques ?
L'assistance par IA n'a pas réduit les échecs thérapeutiques au Kenya
Une étude publiée dans Nature Medicine le 26 juin a examiné si un LLM utilisé pour la prise de décision clinique améliorait les résultats pour les patients. L'étude a impliqué 1003 agents cliniques — plus précisément 103 — répartis dans 16 établissements de Penda Health dans les comtés de Nairobi et de Kiambu. Les agents traitaient les patients avec ou sans l'assistance d'un grand modèle de langage.
Sur les 9 691 patients enregistrés, 9 347 ont été inclus dans l'analyse principale. Un échec thérapeutique après 14 jours est survenu chez 2,2 % du groupe IA et 2 % du groupe témoin. Le rapport des cotes ajusté était de 0,77, mais la différence n'était pas statistiquement significative (P=0,13). Aucun événement indésirable grave n'a été associé à l'intervention.
Le groupe assisté par IA a montré une meilleure documentation ainsi que des diagnostics et des plans de traitement plus appropriés. Cependant, ces améliorations des indicateurs de processus ne se sont pas traduites par une amélioration des résultats pour les patients. C'est là le cœur du problème de preuve : des indicateurs tels que la documentation et la qualité diagnostique sont bien plus faciles à collecter que des résultats comme l'échec thérapeutique, mais les résultats de Penda suggèrent que les deux peuvent évoluer indépendamment.
Un schéma similaire est apparu dans l'essai RAPIDx AI de 2024. Parmi les 3 029 patients de l'analyse principale, le critère composite à six mois — décès cardiovasculaire, infarctus du myocarde ou réadmission cardiovasculaire non programmée — est survenu chez 26 % des patients bénéficiant d'une prise en charge assistée par IA, contre 26,4 % de ceux recevant des soins standards. Toutefois, au sein du groupe sans infarctus de type 1, la coronarographie invasive a été réalisée 47 % moins souvent avec l'assistance par IA.
De meilleurs scores aux tests n'ont pas établi de bénéfices réels
Un essai randomisé multicentre dirigé par Nicholas Rounding a révélé que GPT-4o améliorait les performances de 249 médecins sur des vignettes cliniques de 18 % au Kenya, de 10,7 % en Indonésie et de 7,2 % aux Pays-Bas (P<0,001). La recherche, cependant, portait sur des cas simulés plutôt que sur des situations cliniques réelles. Les participants du groupe témoin ne pouvaient pas utiliser Internet ni les protocoles cliniques, et l'étude n'a pas évalué les effets indésirables.
Les résultats montrent que l'IA peut améliorer les performances en conditions contrôlées, mais ils n'établissent aucun effet sur les résultats pour les patients. Cette distinction entre conditions contrôlées et monde réel est précisément le terrain visé par les questions de la FDA sur l'évaluation pré- et post-commercialisation.
Une autre étude de Nature Medicine, menée par Li Zhang, Jakob Nikolas Kather et leurs collègues, a rapporté une précision de 90,04 % sur un benchmark de sept maladies. En appliquant un seuil de cohérence, l'agent sur site a conservé 49,4 % des cas avec une précision de 98,9 %, les cas restants étant examinés par des professionnels de santé. Les auteurs ont indiqué que ces résultats nécessitent une confirmation supplémentaire par des essais menés en contexte clinique réel. L'étude est disponible ici.
Un médecin « dans la boucle » ne suffit pas
Une cartographie des preuves compilée par Joy Xu, Justin Ko et Joseph Kvedar a révélé que l'IA agentique est utilisée non seulement pour les tâches administratives, mais pour le diagnostic, la gestion et d'autres tâches de santé. La capacité à gouverner et à auditer ces systèmes devient donc de plus en plus importante. La cartographie des preuves est disponible ici.
Un commentaire distinct publié dans npj Digital Medicine soutenait que la simple présence d'un clinicien ne garantit pas une supervision ni une gouvernance adéquates. Le biais d'automatisation peut rendre plus probable l'acceptation d'une recommandation erronée. Une supervision efficace exige des connaissances, du temps et une autorité suffisants pour contester le système et intervenir si nécessaire.
Sans ces conditions, préviennent les auteurs, la supervision humaine peut se réduire à un simple amortisseur de responsabilité :
La responsabilité peut retomber sur des cliniciens censés détecter des erreurs qu'ils ne sont pas bien placés pour détecter ou corriger… une zone de déformation morale.
Le débat s'étend donc au-delà de la question de savoir si un humain est techniquement « dans la boucle » : il porte aussi sur la capacité de cette personne à contester, passer outre et arrêter le système lorsque cela est nécessaire. Le commentaire est disponible ici.
Les enjeux commerciaux accroissent l'importance des preuves
MarketsandMarkets prévoit que le marché de l'IA santé passera de 36,67 milliards de dollars en 2026 à 194,79 milliards de dollars d'ici 2031, soit un taux de croissance annuel composé de 39,7 %. Cette prévision de marché intervient alors que les hôpitaux s'apprêtent à prendre davantage de décisions d'achat d'IA alors que les preuves d'amélioration des résultats pour les patients restent inégales.
Cet environnement pourrait accentuer la pression en faveur de formes de validation plus difficiles à commercialiser mais plus précieuses pour les prestataires : tests prospectifs, surveillance locale des performances et supervision pouvant être auditée de manière indépendante. Un indicateur à court terme sera constitué par les contributions reçues par la FDA sur son document de discussion, qui reste ouvert aux commentaires du public jusqu'au 19 octobre.

