Le GPT-6 Astra d'OpenAI obtient la première note parfaite au CSAT coréen avec un nombre record de tokens
Points clés
- •Le GPT-6 Astra d'OpenAI a obtenu la note parfaite de 450 dans le 2026 CSAT LLM Solution Log, premier modèle à y parvenir dans tous les sujets testés.
- •Astra a consommé 357 000 tokens, le total le plus bas rapporté parmi les modèles disponibles publiquement, ce qui réduit les coûts d'inférence par rapport aux rivaux.
- •Le GPT-5.6 d'OpenAI s'est classé deuxième avec 448,5 points, devant GPT-5.4 à 448, Claude Fable 5.1 à 447,5 et Gemini 3.1 Pro à 445.
- •L'efficacité du modèle est attribuée à une conception qui conserve, compresse et réutilise le contexte des étapes de raisonnement précédentes lors de tâches répétitives.
- •Les experts du secteur rappellent que la capacité de l'IA devrait être évaluée sur la résolution de problèmes ouverts et concrets plutôt que sur les seuls résultats d'examens standardisés.
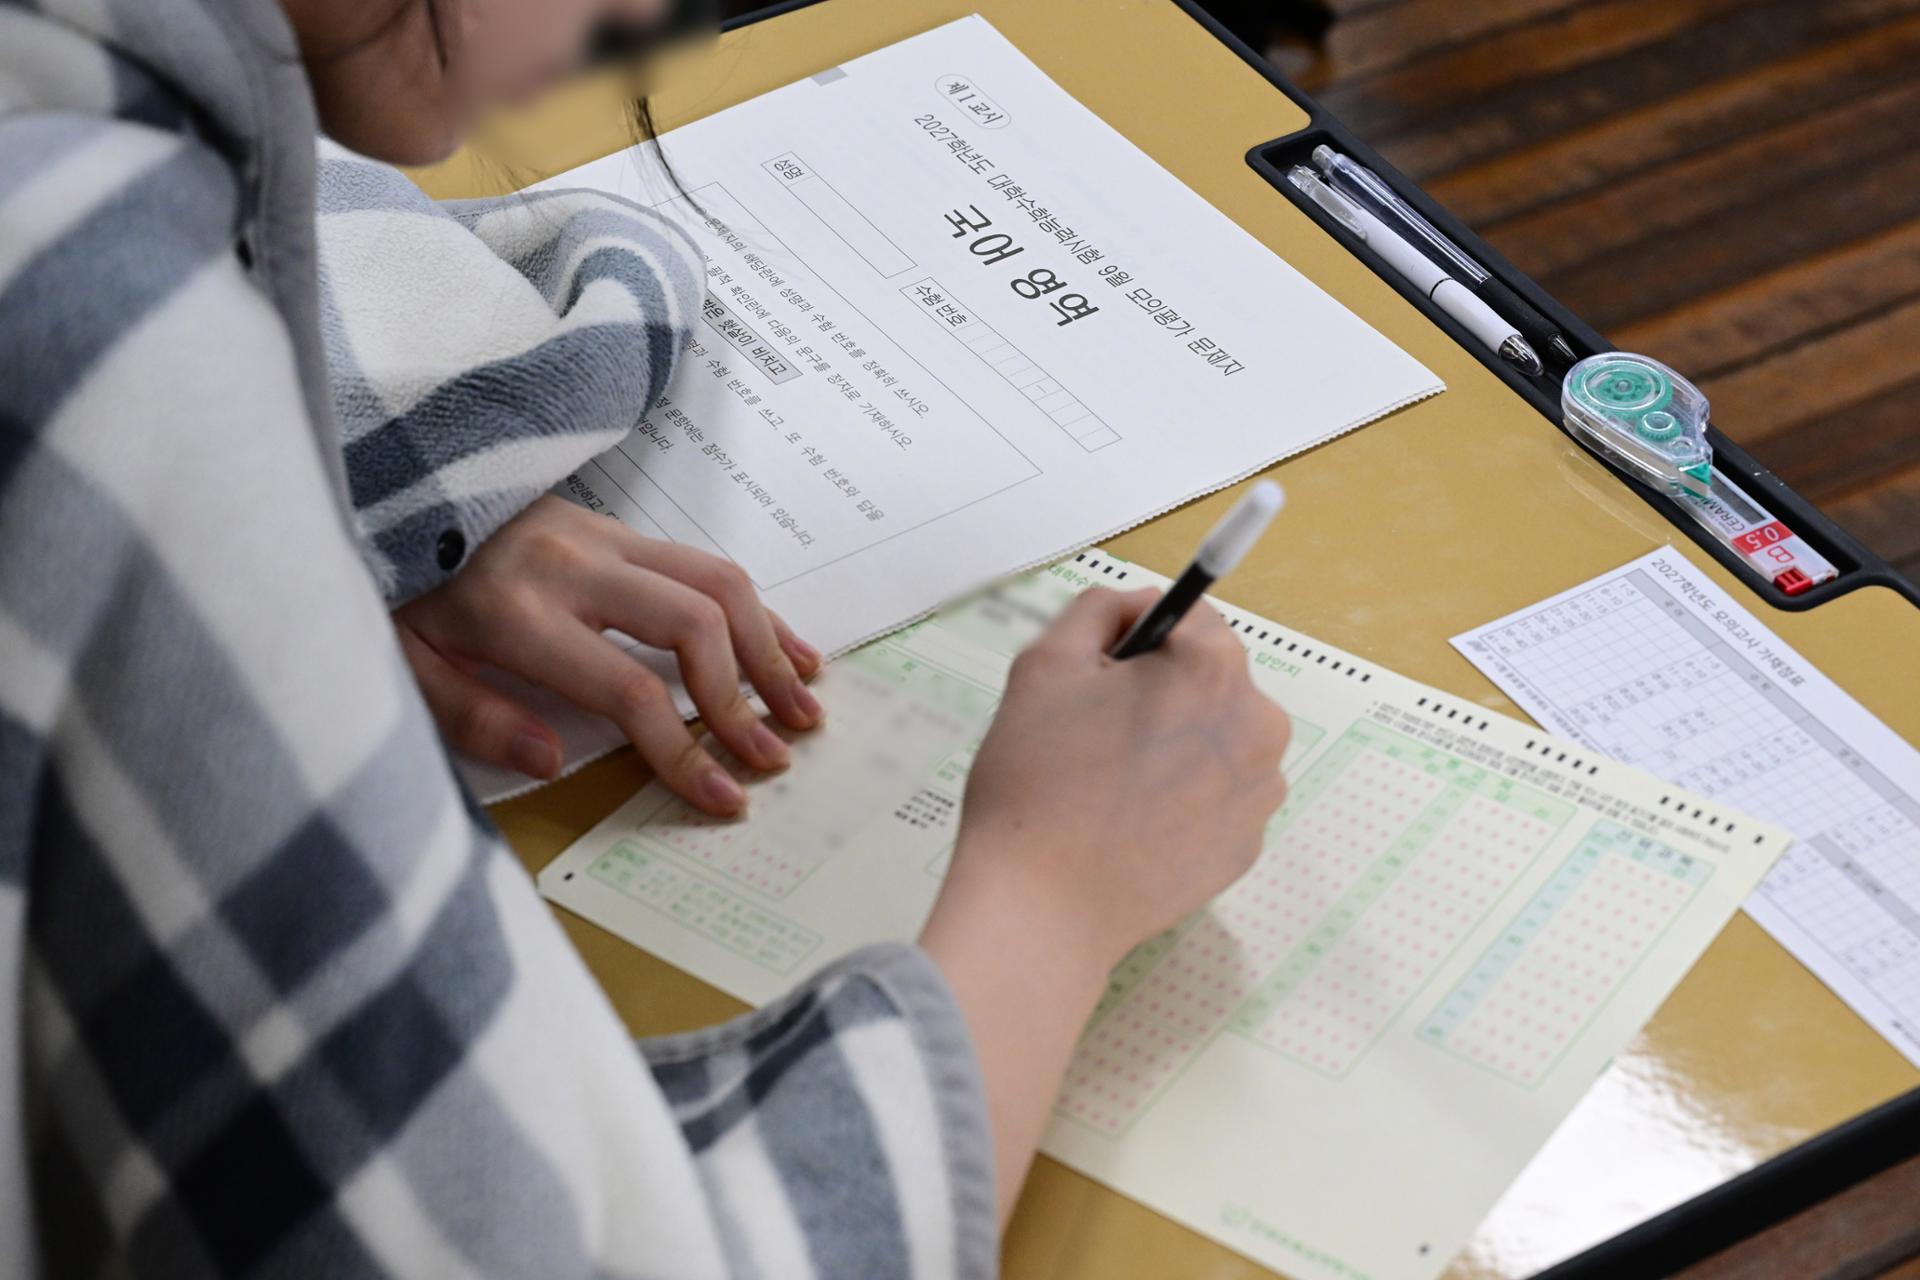
Le dernier modèle d'intelligence artificielle d'OpenAI a obtenu une note parfaite au College Scholastic Ability Test (CSAT), l'examen d'entrée à l'université sud-coréen, pour la première fois, selon une analyse récemment publiée. Si des modèles d'IA de pointe avaient déjà atteint des résultats quasi parfaits, ce résultat retient particulièrement l'attention car le modèle y est parvenu en consommant moins de tokens que ses rivaux — un indicateur important sur le plan commercial, car l'utilisation de tokens se traduit directement par des coûts d'inférence pour les développeurs et les entreprises qui exploitent ces modèles à grande échelle.
Les résultats publiés dimanche sur GitHub montrent que le nouveau GPT-6 Astra d'OpenAI a été le seul modèle évalué à obtenir la note parfaite de 450 dans le 2026 CSAT LLM Solution Log. L'évaluation a testé les modèles sur des questions du CSAT 2026 couvrant le coréen, l'anglais, les mathématiques, l'histoire de la Corée et quatre matières optionnelles — Physique I, Chimie I, Sciences de la vie I et Société et culture — sans accès à Internet. Le CSAT, un examen standardisé passé chaque année par des centaines de milliers d'étudiants coréens, est devenu un étalon récurrent pour comparer la capacité des modèles de pointe à gérer un raisonnement multilingue et multi-matières en conditions d'examen.
Astra a été le premier modèle d'IA à obtenir une note parfaite dans tous les sujets testés de cette évaluation. En février, le Gemini 3.1 Pro de Google avait obtenu une note parfaite en ne choisissant que deux matières optionnelles — Chimie I et Sciences de la vie I — mais avait échoué sur des questions de Physique I et d'une matière d'études sociales dans le format plus large utilisé lors de cette évaluation.
Dans le classement publié dimanche, le GPT-5.6 d'OpenAI arrive deuxième avec 448,5 points, suivi du GPT-5.4 en troisième position avec 448. Le Claude Fable 5.1 d'Anthropic se classe quatrième avec 447,5, et le Gemini 3.1 Pro cinquième avec 445.
Le GPT-6 Astra a utilisé 357 000 tokens, le total le plus bas rapporté parmi les modèles disponibles publiquement. À titre de comparaison, le GPT-5.6 a utilisé 429 000 tokens et le Claude Fable 5.1 en a utilisé 562 000. Comme les questions et les réponses de l'examen étaient accessibles au public, le résultat ne permet pas d'exclure une exposition préalable via les données d'entraînement, même si les modèles concurrents comme Claude Fable 5.1 et Gemini 3.1 Pro étaient soumis aux mêmes conditions.
La forte performance du modèle, associée à une consommation de tokens plus faible, est attribuée à une conception liée au raisonnement qui conserve le contexte lors de tâches répétitives. Un harnais d'adaptation de fournisseur (provider adapter harness) compresse et réutilise les informations issues des étapes de raisonnement précédentes, permettant à l'IA de passer l'examen d'une manière qui imite l'approche d'un étudiant obtenant les meilleures notes.
Lee Seung-hyun, professeur adjoint à l'université Hanyang, a déclaré que la clé n'est pas simplement que le modèle est devenu plus intelligent, mais qu'il peut conserver les étapes de raisonnement précédentes, compresser le contexte et réviser son plan. « Cela signifie qu'au lieu de réfléchir plus intensément à chaque fois, il a poursuivi sur la base de ce qu'il avait déjà compris auparavant », a-t-il expliqué.
OpenAI a décrit ce résultat comme encourageant, notant que le modèle a atteint un traitement efficace grâce à une infrastructure de calcul d'IA à très grande échelle. Un responsable d'OpenAI a déclaré que ce jalon démontre que les modèles peuvent devenir plus puissants tout en améliorant leurs performances et en réduisant les coûts.
Des experts du secteur ont toutefois averti que le potentiel d'un modèle devrait être jugé sur sa capacité à résoudre des problèmes ouverts plutôt que sur les seules notes d'examens standardisés. Une source de l'industrie coréenne de l'IA a indiqué qu'il serait plus significatif que l'IA s'attaque à des défis professionnels du monde réel où il n'existe pas de réponses prédéterminées. La performance des modèles de pointe sur des benchmarks indépendants plus larges — et la question de savoir si les rivaux combleront l'écart d'efficacité — montreront si ce résultat marque un changement durable dans l'arbitrage coût-performance.
Cet article est fondé sur un reportage du Hankook Ilbo, publication sœur de The Korea Times, traduit par un système d'IA générative et édité par The Korea Times. Source originale : The Korea Times.
