Vitalik Buterin, cofundador de Ethereum, dice que la IA local puede proteger la privacidad sin perder velocidad, pero las wallets aún necesitan controles estrictos
Puntos clave
- •La publicación de Buterin marca un cambio respecto a su visión de abril, con modelos locales de laptop que ahora pueden servir como interfaz principal de una mayor parte de las tareas en lugar de solo trabajo estrechamente acotado.
- •Los benchmarks en su laptop Strix Halo mostraron tasas de procesamiento de entrada de 109,82 a 373,22 tokens por segundo y generación de salida de 18,42 a 33,37 tokens por segundo en 10 cargas de trabajo.
- •Qwen3.8-Flash-Next, de pesos abiertos y de Alibaba, es un modelo de mezcla de expertos con 125 mil millones de parámetros que activa solo 6 mil millones por token, y superó al más grande Qwen3.7-Plus en 8 de 14 benchmarks.
- •Los benchmarks estándar de capacidad no miden la resistencia a la inyección de prompts, la autorización de wallets ni la corrección de acciones financieras autónomas, dejando sin resolver el control de la IA sobre activos cripto.
- •Las salvaguardas propuestas incluyen la regla de aprobación 2-de-2 humano-más-modelo de Buterin para transacciones riesgosas, límites de gasto definidos por software, la wallet Steward en el dispositivo financiada por la Ethereum Foundation y el borrador del estándar EIP-7906 para aserciones de estado posteriores a la transacción.
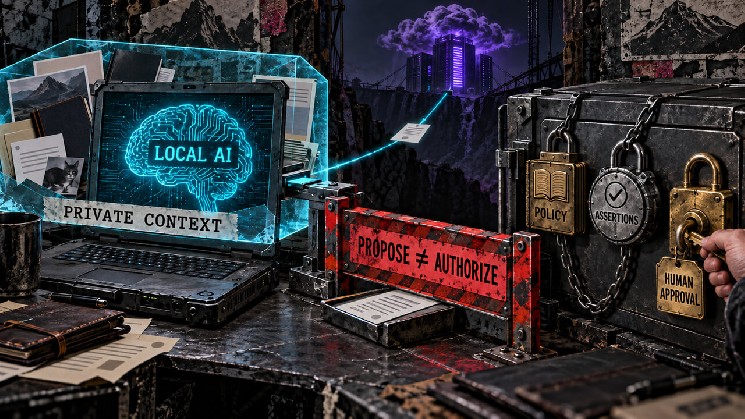
Vitalik Buterin, cofundador de Ethereum, afirma que la inteligencia artificial basada en laptops está llegando a un punto de inflexión práctico, aunque el software de wallets aún necesita superar una barrera mucho más alta antes de que se pueda confiar a una IA el control sobre activos cripto.
En una publicación del 17 de septiembre, Buterin dijo que Qwen 3.8 Flash y las mejoras recientes en llama.cpp —el proyecto de código abierto para ejecutar modelos de lenguaje grandes directamente en hardware local— han acercado a los modelos locales a manejar una "gran parte" de las tareas en su laptop Strix Halo. Para trabajos más avanzados, describió un modelo local que coordina solicitudes hacia sistemas remotos más potentes mientras retiene el contexto personal completo del usuario.
Una imagen de benchmark adjunta a la publicación mostró 10 cargas de trabajo. Las tasas reportadas de procesamiento de entrada oscilaron entre 109,82 y 373,22 tokens por segundo, mientras que la generación de salida osciló entre 18,42 y 33,37 tokens por segundo. Esas cifras respaldan una afirmación práctica sobre la capacidad de respuesta en una laptop de gama alta, pero dejan sin responder el juicio del modelo, la resistencia a instrucciones maliciosas y la autorización de transacciones.
La inferencia local puede mejorar la privacidad mientras el poder de mover fondos permanece detrás de controles separados y exigibles.
Qué cambió entre abril y septiembre
En un relato de abril sobre su configuración de IA local, Buterin describió un papel más limitado para los modelos de laptop. Escribió que Qwen3.5:35B podía manejar tareas acotadas y trabajo de programación familiar, mientras que los agentes independientes avanzados capaces de continuar el trabajo sobre un código base seguían fuera del alcance práctico de las laptops. El trabajo de programación e intelectual más difícil aún requería modelos remotos más potentes.
La publicación de septiembre desplaza su evaluación sobre dónde se ubica el límite práctico. Un modelo local ya no parece limitado a la transcripción, el resumen u otro trabajo estrechamente acotado. En la descripción más reciente, puede servir como la interfaz principal de una mayor parte de la actividad y decidir cuándo es necesario un modelo remoto. Un servicio remoto recibe solo la pregunta o el contexto que el modelo local selecciona, no cada archivo, mensaje y detalle de wallet necesarios para entender la situación más amplia del usuario. El sistema local se convierte tanto en un guardián de la información como en un asistente.
Abril y septiembre implicaron diferentes generaciones de modelos y diferentes tareas. La publicación de septiembre proporciona conteos de tokens y rendimiento, pero omite el contenido de los prompts, las elecciones de cuantización y la configuración completa del entorno de ejecución.
Qwen3.8-Flash-Next, lanzado por el equipo Qwen de Alibaba, es un modelo multimodal de mezcla de expertos de pesos abiertos. Su modelo principal tiene 125 mil millones de parámetros, más otros 51 mil en tablas de embeddings n-gram, mientras que se activan 6 mil millones de parámetros por token. La distribución de pesos abiertos significa que el modelo puede descargarse y ejecutarse por completo en la máquina del propio usuario, la disposición que hace posible la inferencia local y privada. El repositorio oficial documenta la inferencia local de texto y visión a través de llama.cpp usando builds cuantizados en GGUF.
Activar una fracción del modelo por cada token reduce la carga computacional. El usuario aún necesita suficiente memoria para el build y el contexto elegidos, y los materiales oficiales no proporcionan un único mínimo de hardware que aplique a través de los niveles de cuantización y las cargas de trabajo.
Los benchmarks de capacidad dejan sin resolver la autoridad de las wallets
El informe técnico de Qwen evalúa el modelo base en 14 benchmarks que cubren conocimiento general, matemáticas, ciencias, razonamiento, programación y comprensión multilingüe. El equipo Qwen reportó que Flash-Next superó al modelo base más grande Qwen3.7-Plus en ocho de esas pruebas utilizando menos parámetros activados y menos cómputo de entrenamiento.
El informe cubre la capacidad del modelo, la eficiencia y la estabilidad del entrenamiento. La resistencia a la inyección de prompts, la aplicación de políticas, la autorización de wallets y la corrección de acciones financieras autónomas quedan fuera de ese conjunto de benchmarks.
Un asistente puede explicar una transacción de forma privada, preparar calldata o sugerir una ruta. Un firmante puede realizar una solicitud irreversible que transfiera activos o otorgue a otro contrato permiso para moverlos. Un mejor razonamiento reduce algunos errores, pero una instrucción maliciosa oculta en un sitio web, un mensaje o una descripción de transacción aún puede desviar el plan del modelo.
El ecosistema de Ethereum ya está probando una versión en el dispositivo del concepto de asistente. En su actualización de asignaciones del segundo trimestre, la Ethereum Foundation incluyó a Steward, una wallet de cuentas inteligentes totalmente local para macOS cuyo cliente ligero y asistente de IA están diseñados para ejecutarse en el dispositivo. La divulgación establece el financiamiento y el alcance del proyecto, pero deja sin establecer el despliegue en producción, el estado de auditoría independiente y la autoridad de transacciones autónomas. Esos puntos abiertos son los indicadores a observar a medida que los asistentes de wallet en el dispositivo pasan de divulgaciones de financiamiento a software en producción.
La guía de wallets de abril de Buterin colocaba esa autoridad fuera del modelo de lenguaje. Describió un firewall de confirmación humana para acciones riesgosas, límites deterministas sobre montos de transacción, calldata y conteos de transacciones, y una regla humano-más-modelo 2-de-2. El modelo puede reconocer un patrón de estafa que una persona distraída pasa por alto, mientras que una persona puede rechazar una acción después de que contenido malicioso manipule al modelo. Exigir ambas aprobaciones para transacciones riesgosas impide que cualquiera de los participantes se convierta silenciosamente en el único ancla de confianza.
La automatización de bajo riesgo puede seguir disponible dentro de permisos definidos por software. Leer saldos, preparar transacciones sin firmar u operar bajo límites estrictamente acotados puede hacer útil a un asistente sin darle un poder de gasto ilimitado.
La confianza en las wallets depende de reglas que el modelo no puede reescribir
EIP-7906, que sigue siendo un borrador, propone marcos de aserción posteriores a la transacción que inspeccionan las diferencias finales de estado producidas por una transacción. Una aserción puede rechazar el resultado de la aplicación cuando esos cambios violen una condición especificada.
Una wallet podría usar ese mecanismo para exigir que un swap haya cambiado solo saldos aprobados, que nunca haya aparecido una aprobación de token oculta o que el estado de una cuenta protegida haya permanecido intacto. Esas verificaciones comparan los efectos reales de una transacción con reglas explícitas.
El borr también describe los límites de la protección. Una aserción que verifica demasiado poco puede crear falsa confianza. La lógica de validación de la wallet debe exigir el marco de aserción previsto, y la propia aserción debe cubrir cada cambio de estado relevante para la operación protegida.
La inferencia local y las aserciones de transacciones resuelven diferentes partes del problema del agente de wallet. El modelo local protege el contexto y convierte la intención en lenguaje natural en una acción propuesta; los permisos deterministas restringen destinatarios, contratos, valor y frecuencia; las aserciones inspeccionan los cambios finales de estado. La confirmación humana sigue siendo el segundo factor para las acciones riesgosas.
El resultado de septiembre con la laptop hace más creíble la primera capa. Sugiere que un modelo local privado puede responder con la suficiente rapidez para coordinar el trabajo diario y usar de forma selectiva la inteligencia remota. Las capas restantes aún concentran la autoridad que protege los activos.
Una wallet cripto puede tratar al modelo como una interfaz, un planificador y un monitor capaces. La confianza pertenece a los controles que el modelo no puede alterar y a una ruta de aprobación que mantiene al usuario con el control efectivo.
Fuente: CryptoSlate vía CryptoNewsNet.

