Estudio de ETH Zurich y Anthropic concluye que los LLM pueden desenmascarar cuentas anónimas por unos pocos dólares cada una
Puntos clave
- •El pipeline identificó correctamente a 226 de 338 usuarios de Hacker News, alrededor del 67%, con una precisión del 90% utilizando únicamente publicaciones de acceso público.
- •La evaluación completa costó menos de 2,000 dólares, con un promedio de 1 a 4 dólares por perfil identificado, lo que destaca lo barato que se ha vuelto la desanonimización a gran escala.
- •El sistema funciona en cuatro etapas, Extract, Search, Reason y Calibrate, y se abstiene deliberadamente cuando tiene dudas para reducir los falsos positivos.
- •Los investigadores no publicaron el código, los prompts ni ninguna identidad real, y el estudio pasó la revisión del comité de ética de ETH Zurich antes de su publicación.
- •Los autores concluyen que la oscuridad práctica que protege a las cuentasudónimas ya no se sostiene, y citan riesgos para periodistas, activistas, objetivos de anunciantes y usuarios de criptomonedas.
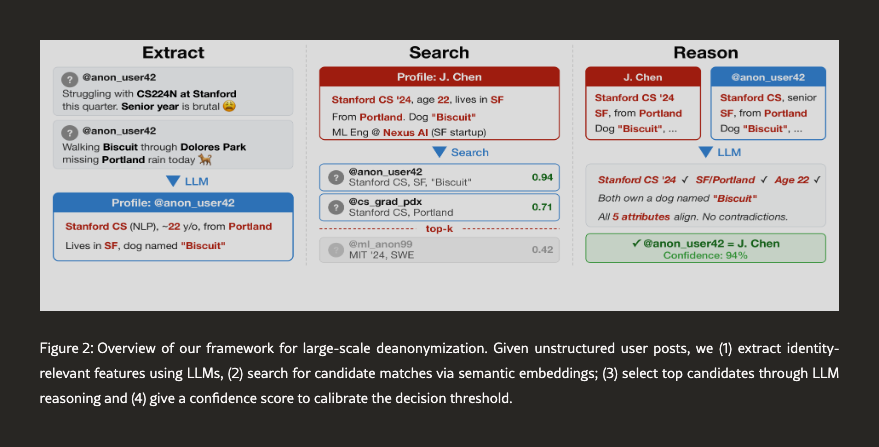
Investigadores de ETH Zurich, el grupo de seguridad de IA MATS y Anthropic han construido un pipeline automatizado de LLM capaz de conectar publicaciones seudónimas en línea con identidades del mundo real. En pruebas, el sistema identificó a cientos de usuarios de Hacker News con una precisión del 90%, a un costo tan bajo como 1 dólar por usuario.
El estudio, "Large-scale online deanonymization with LLMs", fue publicado por primera vez en arXiv el 18 de febrero y luego apareció en las actas del 35.º USENIX Security Symposium, un foro académico líder en investigación de seguridad. Volvió a llamar la atención esta semana tras circular en X y Reddit.
Los autores del artículo son Simon Lermen, Daniel Paleka, Joshua Swanson, Michael Aerni, Nicholas Carlini y Florian Tramèr. Carlini es empleado de Anthropic, la empresa detrás de los modelos Claude, mientras que los demás están afiliados a ETH Zurich y MATS.
Cuatro etapas reducen un grupo de 89,000 candidatos
El ataque no requiere datos robados ni servidores pirateados. El agente trabaja únicamente con información que cualquiera ya puede ver públicamente, realizando el trabajo de un investigador paciente de manera más barata y rápida.
Los investigadores dividieron el proceso en cuatro etapas: Extract, Search, Reason y Calibrate. Primero, un modelo de lenguaje extrae pistas de identidad de las publicaciones en bruto: indicios de un trabajo, una ubicación o una forma característica de redactar. Luego, los embeddings semánticos reducen un grupo de hasta 89,000 candidatos a una lista corta. Un modelo de razonamiento evalúa las mejores coincidencias y decide si dos cuentas pertenecen a la misma persona. La etapa Calibrate hace que el pipeline se abstenga cuando no está seguro, reduciendo los falsos positivos.
El pipeline funciona con herramientas estándar: búsqueda web, embeddings y modelos como GPT-5.2. Ataques previos de desanonimización, como la reidentificación de 2008 de las valoraciones anonimizadas de Netflix, se basaban en datos estructurados. Ese episodio demostró cómo supuestos registros anónimos podían ser desenmascarados mediante referencias cruzadas con información externa, un precursor intensivo en datos del enfoque automatizado y de bajo costo descrito.
226 de 338 usuarios de Hacker News identificados con una precisión del 90%
Para evaluar el método sin arriesgar a personas reales, el equipo conformó un grupo de prueba de 338 usuarios de Hacker News, el foro de tecnología operado por la aceleradora de startups Y Combinator, cuyas biografías apuntaban a una página de LinkedIn, lo que daba a cada uno una identidad real conocida. Recibiendo únicamente los comentarios y envíos de cada usuario, el agente identificó correctamente a 226, alrededor del 67%, con una precisión del 90%. Cometió 25 errores y se abstuvo en 86 cuentas. Las líneas base clásicas sin LLM obtuvieron resultados cercanos a cero en las pruebas de emparejamiento más amplias del artículo.
Los experimentos costaron menos de 2,000 dólares en total, es decir, entre 1 y 4 dólares por perfil aproximadamente.
Otros dos conjuntos de datos pusieron a prueba aún más el enfoque: uno emparejó a usuarios de Reddit en dos comunidades de cine distintas, y otro reconstruyó un solo historial de Reddit dividiéndolo en dos períodos de tiempo. En ambos, los métodos con LLM superaron por un amplio margen a las técnicas más antiguas.
Advertencias y salvaguardas
Los autores señalan una gama de posibles abusos: gobiernos que persiguen a periodistas o activistas, empresas que construyen perfiles publicitarios cada vez más precisos y estafadores que recopilan expedientes para ataques de ingeniería social.
"La combinación es a menudo una huella digital única", escribió Lermen en una publicación de blog del 24 de febrero. Añadió que si un equipo de investigadores inteligentes pudiera identificar a alguien a partir de sus publicaciones, los agentes LLM probablemente también pueden, y el costo solo va a la baja.
Los investigadores no publicaron el código, los prompts ni ninguna identidad real detectada por el sistema. El estudio fue revisado por el comité de ética de ETH Zurich antes de su publicación.
"La oscuridad práctica que protege a los usuarios seudónimos en línea ya no se sostiene", concluye el artículo. Ese tipo de oscuridad es en lo que se han apoyado hasta ahora la mayoría de las cuentas seudónimas, comunes tanto en foros de desarrolladores como en comunidades de criptomonedas.
La renovada atención sobre el estudio se produjo un día después de que la comisionada de la SEC, Hester Peirce, advirtiera contra la recopilación masiva de datos KYC, know your customer, las verificaciones de identidad que las empresas financieras deben realizar a sus usuarios, afirmando que el enfoque equivale a "construir pajas de datos cada vez más grandes". Las recientes brechas en Revolut y en proveedores vinculados al fabricante de hardware wallets Trezor han alimentado los temores a los "wrench attacks", en los que alguien que descubre que una persona posee criptomonedas se presenta en persona.

