Ethereum-Mitgründer Vitalik Buterin: Lokale KI kann die Privatsphäre schützen, ohne an Geschwindigkeit einzubüßen – Wallets benötigen jedoch weiterhin strenge Kontrollen
Wichtige Erkenntnisse
- •Buterins Beitrag markiert eine Abkehr von seiner Einschätzung im April: Lokale Laptop-Modelle können nun als zentrale Schnittstelle für einen größeren Teil der Aufgaben dienen, statt nur eng begrenzte Arbeiten zu erledigen.
- •Benchmarks auf seinem Strix-Halo-Laptop zeigten bei 10 Workloads Eingabeverarbeitungsraten von 109.82 bis 373.22 Tokens pro Sekunde und eine Ausgabeerzeugung von 18.42 bis 33.37 Tokens pro Sekunde.
- •Qwen3.8-Flash-Next von Alibaba ist ein Mixture-of-Experts-Modell mit offenen Gewichten und 125 Milliarden Parametern, von denen pro Token nur 6 Milliarden aktiviert werden. Es übertraf Qwen3.7-Plus in 8 von 14 Benchmarks.
- •Standard-Benchmarks zur Leistungsfähigkeit messen weder die Widerstandsfähigkeit gegen Prompt-Injection noch Wallet-Autorisierung oder die Korrektheit autonomer Finanzaktionen. Damit bleibt die Kontrolle von Krypto-Assets durch KI ungeklärt.
- •Zu den vorgeschlagenen Schutzmaßnahmen gehören Buterins 2-aus-2-Genehmigungsregel durch Mensch und Modell für riskante Transaktionen, softwaredefinierte Ausgabenlimits, das von der Ethereum Foundation finanzierte On-Device-Wallet Steward und der Entwurf des Standards EIP-7906 für Zustands-Assertions nach Transaktionen.
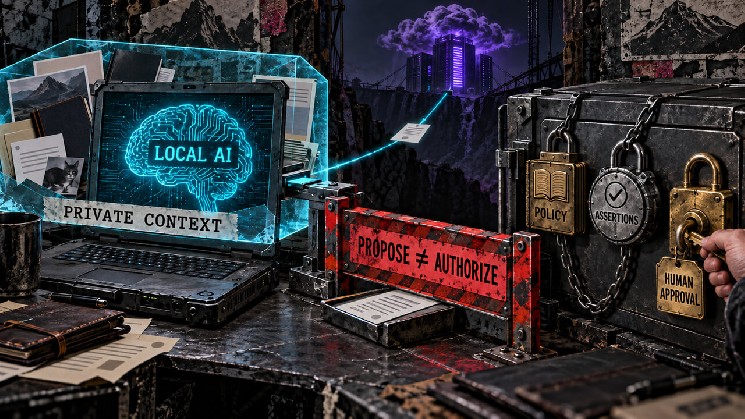
Ethereum-Mitgründer Vitalik Buterin sagt, dass künstliche Intelligenz auf Laptops einen praktischen Wendepunkt erreicht – Wallet-Software muss jedoch weiterhin eine deutlich höhere Hürde überwinden, bevor einer KI die Kontrolle über Krypto-Assets anvertraut werden kann.
In einem Beitrag vom 17. September erklärte Buterin, Qwen 3.8 Flash und jüngste Verbesserungen an llama.cpp – dem Open-Source-Projekt zum direkten Ausführen großer Sprachmodelle auf lokaler Hardware – hätten lokale Modelle auf seinem Strix-Halo-Laptop nahe an die Bewältigung eines „großen Teils“ der Aufgaben gebracht. Für anspruchsvollere Arbeiten beschrieb er ein lokales Modell, das Anfragen an leistungsfähigere Remote-Systeme koordiniert und dabei den vollständigen persönlichen Kontext des Nutzers zurückhält.
Ein dem Beitrag beigefügtes Benchmark-Bild zeigte 10 Workloads. Die gemeldeten Raten für die Eingabeverarbeitung lagen zwischen 109.82 und 373.22 Tokens pro Sekunde, während die Ausgabeerzeugung zwischen 18.42 und 33.37 Tokens pro Sekunde lag. Diese Werte stützen die praktische Aussage, dass ein einzelner leistungsstarker Laptop schnell reagieren kann. Sie lassen jedoch die Urteilsfähigkeit des Modells, seine Widerstandsfähigkeit gegen bösartige Anweisungen und die Autorisierung von Transaktionen offen.
Lokale Inferenz kann die Privatsphäre verbessern, während die Befugnis zum Transfer von Geldern durch separate, durchsetzbare Kontrollen abgesichert bleibt.
Was sich zwischen April und September geändert hat
In einer Darstellung seines lokalen KI-Setups vom April beschrieb Buterin eine begrenztere Rolle für Laptop-Modelle. Er schrieb, dass Qwen3.5:35B klar abgegrenzte Aufgaben und vertraute Programmierarbeiten bewältigen könne, während fortgeschrittene unabhängige Agenten, die selbstständig an einer Codebasis weiterarbeiten können, weiterhin außerhalb der praktischen Reichweite von Laptops lägen. Anspruchsvollere Programmier- und geistige Arbeiten erforderten nach wie vor leistungsfähigere Remote-Modelle.
Der Beitrag vom September verschiebt seine Einschätzung davon, wo die praktische Grenze liegt. Ein lokales Modell scheint nun nicht mehr auf Transkription, Zusammenfassungen oder andere eng begrenzte Arbeiten beschränkt zu sein. In der neueren Beschreibung kann es als zentrale Schnittstelle für einen größeren Teil der Aktivitäten dienen und entscheiden, wann ein Remote-Modell erforderlich ist. Ein Remote-Dienst erhält nur die Frage oder den Kontext, den das lokale Modell auswählt – nicht jede Datei, Nachricht und jedes Wallet-Detail, die zum Verständnis der umfassenderen Situation des Nutzers erforderlich wären. Das lokale System wird damit zugleich zum Informations-Gatekeeper und zum Assistenten.
Im April und September kamen unterschiedliche Modellgenerationen und unterschiedliche Aufgaben zum Einsatz. Der September-Beitrag enthält Token-Zahlen und Angaben zum Durchsatz, nennt jedoch weder die Inhalte der Prompts noch die Quantisierungsentscheidungen oder die vollständige Laufzeitkonfiguration.
Qwen3.8-Flash-Next, das vom Qwen-Team von Alibaba veröffentlicht wurde, ist ein multimodales Mixture-of-Experts-Modell mit offenen Gewichten. Sein Hauptmodell verfügt über 125 Milliarden Parameter sowie weitere 51 Milliarden Parameter in N-Gramm-Embedding-Tabellen, wobei pro Token 6 Milliarden Parameter aktiviert werden. Die Verteilung mit offenen Gewichten bedeutet, dass das Modell vollständig auf dem eigenen Rechner des Nutzers heruntergeladen und ausgeführt werden kann – eine Voraussetzung für lokale, private Inferenz. Das offizielle Repository dokumentiert lokale Text- und Bildinferenz über llama.cpp unter Verwendung quantisierter GGUF-Builds.
Die Aktivierung eines Teils des Modells für jedes Token verringert den Rechenaufwand. Der Nutzer benötigt dennoch ausreichend Arbeitsspeicher für den ausgewählten Build und Kontext. Die offiziellen Materialien nennen kein einheitliches Hardware-Minimum, das für alle Quantisierungsstufen und Workloads gilt.
Leistungs-Benchmarks klären die Wallet-Autorität nicht
Der technische Bericht von Qwen bewertet das Basismodell anhand von 14 Benchmarks zu Allgemeinwissen, Mathematik, Naturwissenschaften, Schlussfolgerungen, Programmierung und mehrsprachigem Verständnis. Das Qwen-Team berichtete, dass Flash-Next das größere Basismodell Qwen3.7-Plus in acht dieser Tests übertraf und dabei weniger aktivierte Parameter sowie weniger Trainingsaufwand benötigte.
Der Bericht behandelt die Fähigkeiten, Effizienz und Trainingsstabilität des Modells. Die Widerstandsfähigkeit gegen Prompt-Injection, die Durchsetzung von Richtlinien, die Wallet-Autorisierung und die Korrektheit autonomer Finanzaktionen gehören nicht zu diesem Benchmark-Set.
Ein Assistent kann eine Transaktion privat erklären, Calldata vorbereiten oder eine Route vorschlagen. Ein Signierer kann eine unumkehrbare Anfrage auslösen, die Assets überträgt oder einem anderen Contract die Erlaubnis erteilt, sie zu bewegen. Besseres Schlussfolgern reduziert einige Fehler, doch eine bösartige Anweisung, die in einer Website, Nachricht oder Transaktionsbeschreibung verborgen ist, kann den Plan des Modells weiterhin umleiten.
Das Ethereum-Ökosystem testet bereits eine On-Device-Version dieses Assistentenkonzepts. In ihrem Update zur Mittelverwendung im zweiten Quartal führte die Ethereum Foundation Steward auf, ein vollständig lokales Smart-Account-Wallet für macOS, dessen Light Client und KI-Assistent auf dem Gerät ausgeführt werden sollen. Die Veröffentlichung bestätigt die Finanzierung und den Projektumfang, lässt jedoch den Einsatz in der Produktion, den Status unabhängiger Audits und die Autorität für autonome Transaktionen offen. Diese offenen Punkte sind entscheidend, wenn On-Device-Wallet-Assistenten von Finanzierungsbekanntmachungen zu veröffentlichter Software übergehen.
Buterins Wallet-Leitlinien vom April verorteten diese Autorität außerhalb des Sprachmodells. Er beschrieb eine menschliche Bestätigungsschranke für riskante Aktionen, deterministische Begrenzungen für Transaktionsbeträge, Calldata und die Anzahl der Transaktionen sowie eine 2-aus-2-Regel zwischen Mensch und Modell. Das Modell kann ein Betrugsmuster erkennen, das eine abgelenkte Person übersieht, während eine Person eine Aktion ablehnen kann, nachdem bösartige Inhalte das Modell manipuliert haben. Die Anforderung beider Genehmigungen bei riskanten Transaktionen verhindert, dass einer der beiden Beteiligten unbemerkt zum alleinigen Vertrauensanker wird.
Automatisierung mit geringem Risiko kann innerhalb softwaredefinierter Berechtigungen verfügbar bleiben. Das Abrufen von Kontoständen, das Vorbereiten nicht signierter Transaktionen oder der Betrieb unter strengen Obergrenzen kann einen Assistenten nützlich machen, ohne ihm uneingeschränkte Ausgabebefugnisse zu geben.
Wallet-Vertrauen hängt von Regeln ab, die das Modell nicht umschreiben kann
EIP-7906, der weiterhin ein Entwurf ist, schlägt Assertion-Frames nach Transaktionen vor, die die durch eine Transaktion erzeugten endgültigen Zustandsänderungen prüfen. Eine Assertion kann das Ergebnis der Ausführung ablehnen, wenn diese Änderungen eine festgelegte Bedingung verletzen.
Ein Wallet könnte diesen Mechanismus nutzen, um sicherzustellen, dass ein Swap nur genehmigte Salden verändert, dass keine versteckte Token-Genehmigung hinzugefügt wurde oder dass der Zustand eines geschützten Kontos unangetastet blieb. Diese Prüfungen vergleichen die tatsächlichen Auswirkungen einer Transaktion mit ausdrücklichen Regeln.
Der Entwurf beschreibt auch die Grenzen des Schutzes. Eine Assertion, die zu wenig prüft, kann falsches Vertrauen schaffen. Die Validierungslogik des Wallets muss den vorgesehenen Assertion-Frame verlangen, und die Assertion selbst muss jede relevante Zustandsänderung der geschützten Operation abdecken.
Lokale Inferenz und Transaktions-Assertions lösen unterschiedliche Teile des Wallet-Agenten-Problems. Das lokale Modell schützt den Kontext und wandelt Absichten in natürlicher Sprache in eine vorgeschlagene Aktion um; deterministische Berechtigungen beschränken Empfänger, Contracts, Werte und Häufigkeit; Assertions prüfen die endgültigen Zustandsänderungen. Die menschliche Bestätigung bleibt bei riskanten Aktionen der zweite Faktor.
Das Laptop-Ergebnis vom September macht die erste Schutzebene glaubwürdiger. Es deutet darauf hin, dass ein privates lokales Modell schnell genug reagieren kann, um alltägliche Arbeiten zu koordinieren und gezielt Remote-Intelligenz einzusetzen. Die übrigen Ebenen behalten weiterhin die Autorität, die Assets schützt.
Ein Krypto-Wallet kann das Modell als leistungsfähige Schnittstelle, Planer und Überwachungssystem behandeln. Vertrauen sollte Kontrollen gelten, die das Modell nicht verändern kann, sowie einem Genehmigungsweg, der den Nutzer wirksam in Kontrolle hält.
Quelle: CryptoSlate über CryptoNewsNet.

