Die Fortschritte medizinischer KI eilen den Nachweisen besserer Patientenergebnisse voraus
Wichtige Erkenntnisse
- •Eine randomisierte Studie an 16 Penda-Health-Einrichtungen in Kenia ergab, dass LLM-Unterstützung Dokumentation und Diagnosequalität verbesserte, die Behandlungsversager nach 14 Tagen jedoch nicht signifikant senkte: 2,2 % in der KI-Gruppe gegenüber 2 % in der Kontrollgruppe.
- •Die US-amerikanische FDA veröffentlichte am 18. August ein Diskussionspapier zur Regulierung generativer KI-Medizinprodukte, das bis zum 19. Oktober für öffentliche Stellungnahmen offen ist und Risikobewertung, Prüfung vor Marktzulassung und Marktüberwachung behandelt.
- •Eine multinationale Studie fand, dass GPT-4o die Leistung von 249 Ärzten bei klinischen Fallvignetten um 7,2 % bis 18 % verbesserte; die Studie verwendete jedoch simulierte Fälle und bewertete keine Schäden, sodass reale Vorteile für Patienten unbelegt bleiben.
- •Ein Kommentar im npj Digital Medicine warnte, dass ein Clinician im Loop keine wirksame Aufsicht garantiert, da Automatisierungsverzerrungen dazu führen können, dass fehlerhafte KI-Empfehlungen eher akzeptiert werden.
- •MarketsandMarkets prognostiziert, dass der KI-Gesundheitsmarkt von 36,67 Milliarden US-Dollar 2026 auf 194,79 Milliarden US-Dollar bis 2031 wachsen wird, einer jährlichen Wachstumsrate von 39,7 %.
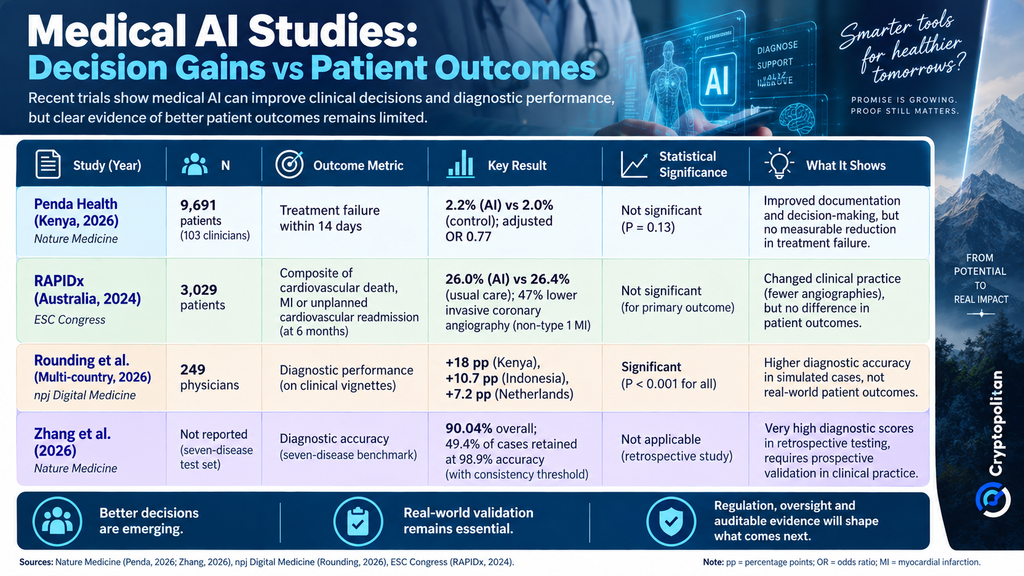
Eine wachsende Zahl von Studien aus dem Jahr 2026 zeigt eine hartnäckige Lücke in der medizinischen Künstlichen Intelligenz auf: Diese Systeme können ärztliche Entscheidungen beeinflussen und beeindruckende diagnostische Ergebnisse liefern, ohne zu zeigen, dass die Patienten dadurch tatsächlich gesünder werden.
Die Frage ist relevant für Krankenhäuser, die KI-Tools evaluieren, für Unternehmen, die ihren Nutzen belegen wollen, und für Regulierungsbehörden, die entscheiden, welche Nachweise nach dem klinischen Einsatz solcher Systeme erforderlich sein sollten.
Regulierungsbehörden prüfen das Beweisproblem medizinischer KI
Die Kluft zwischen der berichteten Leistungsfähigkeit von KI und den belegten Vorteilen für Patienten wird zunehmend schwerer zu übersehen. Der Financial Times fasste das Problem in einer Schlagzeile zusammen: „Medical AI has a proof problem.“
Die Frage hat die akademische Debatte längst verlassen. Die US-amerikanische Zulassungsbehörde FDA untersucht viele derselben Punkte, während sie prüft, wie KI-gestützte Medizinprodukte vor und nach dem Einsatz bewertet werden sollen. Ein Diskussionspapier vom 18. August, das bis zum 19. Oktober für öffentliche Stellungnahmen offen ist, behandelt Risikobewertung, die Prüfung vor Marktzulassung und die Überwachung nach dem Inverkehrbringen.
Die FDA betonte, dass das Dokument ausschließlich ein Diskussionspapier ist. Es handelt sich nicht um einen Leitfadenentwurf, eine vorgeschlagene Richtlinienänderung oder einen Hinweis auf künftige regulatorische Erwartungen. Dennoch bietet offene Stellungnahmeverfahren Krankenhäusern, Geräteherstellern und Forschern einen formellen Kanal, um darzulegen, welche Nachweise ihrer Ansicht nach für den klinischen Einsatz erforderlich sein sollten.
Eine frühere Aufforderung der FDA zur öffentlichen Kommentierung zur Messung und Bewertung der realen Leistungsfähigkeit KI-gestützter Medizinprodukte hatte zudem Bedenken hinsichtlich Model Drift und der Grenzen statischer Kennzahlen aufgeworfen. Model Drift – die Verschlechterung, die auftreten kann, wenn reale Patienten oder Versorgungsabläufe von den Trainingsdaten eines Modells abweichen – ist ein Grund, warum ein bei der Einführung validiertes Tool Monate später anders funktionieren kann. Das wirft eine breitere Frage auf: Wie sollten Sicherheit und Wirksamkeit gemessen werden, nachdem ein KI-System das Labor verlassen und in die klinische Versorgung übergegangen ist?
KI-Unterstützung senkte die Behandlungsversager in Kenia nicht
Eine am 26. Juni in Nature Medicine veröffentlichte Studie untersuchte, ob ein für klinische Entscheidungsfindung eingesetztes LLM die Patientenergebnisse verbesserte. Die Studie umfasste 103 Clinical Officers an 16 Penda-Health-Einrichtungen in den Bezirken Nairobi und Kiambu. Die Behandler versorgten Patienten entweder mit oder ohne Unterstützung durch ein Large Language Model.
Von den 9.691 registrierten Patienten wurden 9.347 in die Primäranalyse einbezogen. Ein Behandlungsversagen nach 14 Tagen trat bei 2,2 % der KI-Gruppe und bei 2 % der Kontrollgruppe auf. Die adjustierte Odds Ratio lag bei 0,77, der Unterschied war jedoch nicht statistisch signifikant (P=0,13). Mit der Intervention waren keine schwerwiegenden unerwünschten Ereignisse verbunden.
Die KI-unterstützte Gruppe zeigte eine bessere Dokumentation sowie geeignetere Diagnosen und Behandlungspläne. Diese Verbesserungen bei Prozesskennzahlen führten jedoch nicht zu besseren Patientenergebnissen. Diese Lücke ist der Kern des Beweisproblems: Kennzahlen wie Dokumentations- und Diagnosequalität lassen sich weit einfacher erheben als Ergebnisse wie Behandlungsversager, doch die Penda-Ergebnisse deuten darauf hin, dass beide sich unabhängig voneinander entwickeln können.
Ein ähnliches Muster zeigte sich in der RAPIDx-AI-Studie von 2024. Unter den 3.029 Patienten der Primäranalyse trat der kombinierte Sechs-Monats-Endpunkt aus kardiovaskulärem Tod, Myokardinfarkt oder ungeplanter kardialer Wiederaufnahme bei 26 % der Patienten mit KI-unterstützter Versorgung auf, gegenüber 26,4 % unter Standardversorgung. In der Gruppe ohne Typ-1-Myokardinfarkt wurde jedoch eine invasive Koronarangiographie mit KI-unterstützter Versorgung um 47 % seltener durchgeführt.
Höhere Testergebnisse haben keine realen Nutzen belegt
Eine multinationale randomisierte Studie unter der Leitung von Nicholas Rounding ergab, dass GPT-4o die Leistung von249 Ärzten bei klinischen Fallvignetten um 18 % in Kenia, 10,7 % in Indonesien und 7,2 % in den Niederlanden verbesserte (P<0,001). Die Forschungsarbeit verwendete jedoch simulierte Fälle statt realer klinischer Situationen. Teilnehmer der Kontrollgruppe konnten weder das Internet noch klinische Leitlinien nutzen, und die Studie bewertete keine Schäden.
Die Ergebnisse zeigen, dass KI die Leistung unter kontrollierten Bedingungen steigern kann, belegen aber keine Wirkung auf Patientenergebnisse. Genau auf diese Unterscheidung zwischen kontrollierten und realen Bedingungen zielen die Fragen der FDA zur Bewertung vor und nach dem Inverkehrbringen ab.
Eine weitere Nature-Medicine-Studie von Li Zhang, Jakob Nikolas Kather und Kollegen berichtete eine Genauigkeit von 90,04 % bei einem Sieben-Krankheiten-Benchmark. Durch die Anwendung eines Konsistenzschwellenwerts behielt der On-Site-Agent 49,4 % der Fälle mit 98,9 % Genauigkeit, während die übrigen Fälle von Fachärzten überprüft wurden. Die Autoren sagten, die Ergebnisse müssten in Studien unter realen klinischen Bedingungen weiter bestätigt werden. Die Studie ist hier verfügbar.
Ein Arzt „im Loop“ ist nicht ausreichend
Eine von Joy Xu, Justin Ko und Joseph Kvedar erstellte Evidenzlandkarte zeigt, dass agentische KI nicht nur für administrative Aufgaben, sondern auch für Diagnose, Behandlungssteuerung und andere Gesundheitsaufgaben eingesetzt wird. Damit wird die Fähigkeit, diese Systeme zu steuern und zu auditieren, zunehmend wichtiger. Die Evidenzlandkarte ist hier verfügbar.
Ein separater Kommentar im npj Digital Medicine argumentierte, dass die bloße Beteiligung eines Clinicians keine wirksame Aufsicht oder Governance garantiert. Automatisierungsverzerrungen können dazu führen, dass fehlerhafte Empfehlungen eher akzeptiert werden. Eine sinnvolle Aufsicht erfordert ausreichend Wissen, Zeit und Befugnis, um das System anzufordern und bei Bedarf einzugreifen.
Ohne diese Bedingungen, warnten die Autoren, könne menschliche Aufsicht kaum mehr als eine Haftungsrückfallebene sein:
Verantwortung kann auf Clinicians abgewälzt werden, die Fehler erkennen oder korrigieren sollen, die sie kaum erfassen oder beheben können … eine moralische Crumple Zone.
Die Debatte reicht daher über die Frage hinaus, ob ein Mensch technisch „im Loop“ ist. Sie betrifft auch, ob diese Person in der Lage ist, das System bei Bedarf zu hinterfragen, zu übersteuern und zu stoppen. Der Kommentar ist hier verfügbar.
Kommerzielle Interessen erhöhen die Bedeutung von Evidenz
MarketsandMarkets prognostiziert, dass der KI-Gesundheitsmarkt von 36,67 Milliarden US-Dollar im Jahr 2026 auf 194,79 Milliarden US-Dollar bis 2031 wachsen wird, was einer jährlichen Wachstumsrate von 39,7 % entspricht. Die Marktprognose fällt in eine Zeit, in der Krankenhäuser mehr KI-Kaufentscheidungen treffen, während die Evidenz für verbesserte Patientenergebnisse uneinheitlich bleibt.
Dieses Umfeld könnte den Druck auf Validierungsformen erhö, die sich schwerer vermarkten lassen, aber für Anbieter wertvoller sind: prospektive Prüfungen, lokale Leistungsüberwachung und eine Aufsicht, die unabhängig auditiert werden kann. Ein kurzfristiger Indikator wird die Stellungnahme der FDA zu ihrem Diskussionspapier sein, das bis zum 19. Oktober für öffentliche Kommentare offen bleibt.

