ETH Zürich und Anthropic: Studie zeigt, dass LLMs anonyme Konten für wenige Dollar pro Person enttarnen können
Wichtige Erkenntnisse
- •Die Pipeline identifizierte 226 von 338 Hacker-News-Nutzern korrekt – rund 67 % – bei 90 % Präzision, ausschließlich anhand öffentlich zugänglicher Beiträge.
- •Der gesamte Benchmark kostete unter 2.000 Dollar, im Durchschnitt etwa 1 bis 4 Dollar pro identifiziertem Profil – ein Beleg dafür, wie günstig groß angelegte Deanonymisierung geworden ist.
- •Das System arbeitet in vier Stufen – Extract, Search, Reason und Calibrate – und enthält sich bei Unsicherheit bewusst, um falsche positive Ergebnisse zu reduzieren.
- •Die Forscher veröffentlichten weder Code noch Prompts oder echte Identitäten, und die Studie wurde vor der Veröffentlichung von der Ethikkommission der ETH Zürich geprüft.
- •Die Autoren kommen zu dem Schluss, dass die praktische Anonymität pseudonymer Konten nicht mehr besteht, und verweisen auf Risiken für Journalisten, Aktivisten, Werbeziele und Krypto-Nutzer.
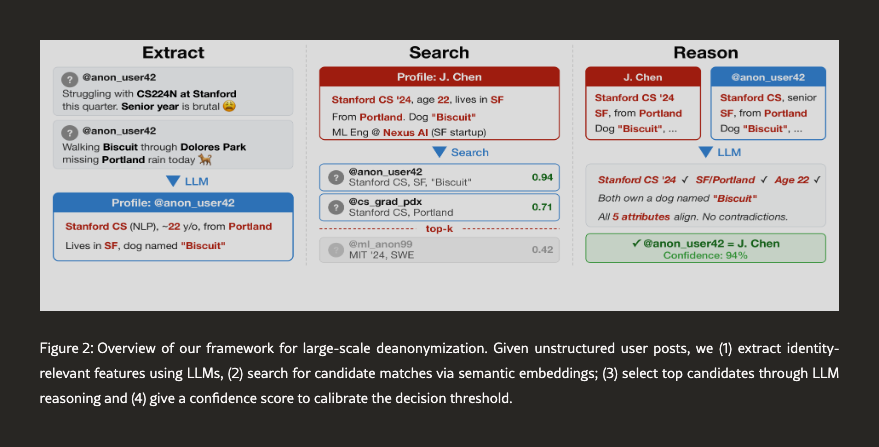
Forscher der ETH Zürich, der KI-Sicherheitsgruppe MATS und von Anthropic haben eine automatisierte LLM-Pipeline entwickelt, die pseudonyme Online-Beiträge mit realen Identitäten verknüpfen kann. In Tests identifizierte das System hunderte Hacker-News-Nutzer bei 90 % Präzision, zu Kosten von bis zu 1 Dollar pro Nutzer.
Die Studie "Large-scale online deanonymization with LLMs" wurde erstmals am 18. Februar auf arXiv veröffentlicht und erschien später in den Proceedings des 35. USENIX Security Symposiums, einer führenden akademischen Plattform für Sicherheitsforschung. Diese Woche erregte sie erneute Aufmerksamkeit, nachdem sie auf X und Reddit kursierte.
Die Autoren der Studie sind Simon Lermen, Daniel Paleka, Joshua Swanson, Michael Aerni, Nicholas Carlini und Florian Tramèr. Carlini ist Mitarbeiter von Anthropic, dem Unternehmen hinter den Claude-Modellen, während die anderen mit der ETH Zürich und MATS verbunden sind.
Vier Stufen verkleinern einen Pool von 89.000 Kandidaten
Der Angriff erfordert weder gestohlene Daten noch gehackte Server. Der Agent arbeitet ausschließlich mit Informationen, die ohnehin öffentlich einsehbar sind, und leistet die Arbeit eines geduldigen Ermittlers – schneller und günstiger.
Die Forscher unterteilten den Prozess in vier Stufen: Extract, Search, Reason und Calibrate. Zunächst extrahiert ein Sprachmodell Identitätshinweise aus rohen Beiträgen – Andeutungen zu einem Beruf, einem Standort oder einer charakteristischen Ausdrucksweise. Semantische Embeddings verkleinern dann einen Pool von bis zu 89.000 Kandidaten auf eine engere Auswahl. Ein Reasoning-Modell bewertet die stärksten Übereinstimmungen und entscheidet, ob zwei Konten derselben Person gehören. Dieibrate-Stufe sorgt dafür, dass die Pipeline bei Unsicherheit nicht urteilt, was falsche positive Ergebnisse reduziert.
Die Pipeline läuft auf Standard-Tools: Websuche, Embeddings und Modellen wie GPT-5.2. Frühere Deanoonymisierungsangriffe, etwa die Re-Identifizierung der anonymisierten Netflix-Bewertungen im Jahr 2008, beruhten auf strukturierten Daten. Dieser Fall zeigte, wie angeblich anonyme Datensätze durch Abgleich mit externen Informationen enttarnt werden konnten – ein datenlastiger Vorläufer des hier beschriebenen automatisierten, kostengünstigen Ansatzes.
226 von 338 Hacker-News-Nutzern bei 90 % Präzision identifiziert
Um die Methode ohne Risiko für echte Menschen zu evaluieren, stellte das Team einen Benchmark aus 338 Hacker-News-Nutzern zusammen – das Technologieforum des Startup-Inkubators Y Combinator –, deren Profile auf eine LinkedIn-Seite verwiesen und damit eine bekannte Ground-Truth-Identität boten. Mit nur den Kommentaren und Beiträgen jedes Nutzers identifizierte der Agent 226 korrekt – etwa 67 % – bei 90 % Präzision. Er lag 25-mal falsch und enthielt sich bei 86 Konten. Klassische Baselines ohne LLM erzielten in den größeren Matching-Tests der Studie Werte nahe null.
Die Experimente kosteten insgesamt weniger als 2.000 Dollar, umgerechnet rund 1 bis 4 Dollar pro Profil.
Zwei weitere Datensätze testeten den Ansatz zusätzlich: Einer ordnete Reddit-Nutzer über zwei verschiedene Film-Communities hinweg zu, ein anderer rekonstruierte eine einzelne Reddit-Historie, indem sie in zwei Zeiträume aufgeteilt wurde. In beiden Fällen übertrafen die LLM-Methoden die älteren Techniken deutlich.
Warnungen und Schutzmaßnahmen
Die Autoren verweisen auf ein Spektrum möglicher Missbräuche: Regierungen, die Journalisten oder Aktivisten ins Visier nehmen, Unternehmen, die immer präzisere Werbeprofile erstellen, und Betrüger, die Dossiers für Social-Engineering-Angriffe zusammenstellen.
"Die Kombination ist oft ein einzigartiger Fingerabdruck", schrieb Lermen in einem Blogbeitrag vom 24. Februar. Er fügte hinzu: Wenn ein Team kluger Ermittler jemanden anhand seiner Beiträge identifizieren könnte, dürften LLM-Agents das ebenfalls können – und die Kosten sinken stetig.
Die Forscher haben weder den Code noch die Prompts oder echte Identitäten veröffentlicht, die das System aufgedeckt hat. Die Studie wurde vor der Veröffentlichung von der Ethikkommission der ETH Zürich geprüft.
"Die praktische Anonymität, die pseudonyme Nutzer online schützt, besteht nicht mehr", lautet das Fazit der Studie. Genau auf diese Art von Anonymität haben sich bislang die meisten pseudonymen Konten gestützt – verbreitet sowohl in Entwickler-Foren als auch in Krypto-Communities.
Die erneute Aufmerksamkeit für die Studie kam einen Tag, nachdem SEC-Kommissarin Hester Peirce vor der Massenerhebung von KYC-Daten – Know-Your-Customer, die Identitätsprüfungen, die Finanzunternehmen bei ihren Nutzern durchführen müssen – gewarnt hatte. Dieser Ansatz bedeute, "immer größere Daten-Heuhaufen" zu bauen. Jüngste Datenschutzvorfälle Revolut und bei Dienstleistern im Umfeld des Hardware-Wallet-Herstellers Trezor haben Ängste vor "Wrench Attacks" geschürt, bei denen jemand, der erfahren hat, dass eine Person Krypto besitzt, persönlich auftaucht.

