OpenAIs GPT-6 Astra erreicht erstmals volle Punktzahl im koreanischen CSAT mit Rekord-Niedrigwert an Tokens
Wichtige Erkenntnisse
- •OpenAIs GPT-6 Astra erreichte im 2026 CSAT LLM Solution Log volle 450 Punkte – als erstes Modell in allen getesteten Fächern.
- •Astra verbrauchte 357.000 Tokens, den niedrigsten öffentlich gemeldeten Wert, was die Inferenzkosten im Vergleich zu Konkurrenten senkt.
- •OpenAIs GPT-5.6 belegte mit 448,5 Punkten Rang zwei, vor GPT-5.4 mit 448, Claude Fable 5.1 mit 447,5 und Gemini 3.1 Pro mit 445.
- •Die Effizienz des Modells wird einem Design zugeschrieben, das Kontext aus früheren Denkschritten bewahrt, komprimiert und wiederverwendet.
- •Branchenexperten warnen, dass KI-Fähigkeiten an offenen, realen Problemlösungen gemessen werden sollten – nicht allein an standardisierten Prüfungsergebnissen.
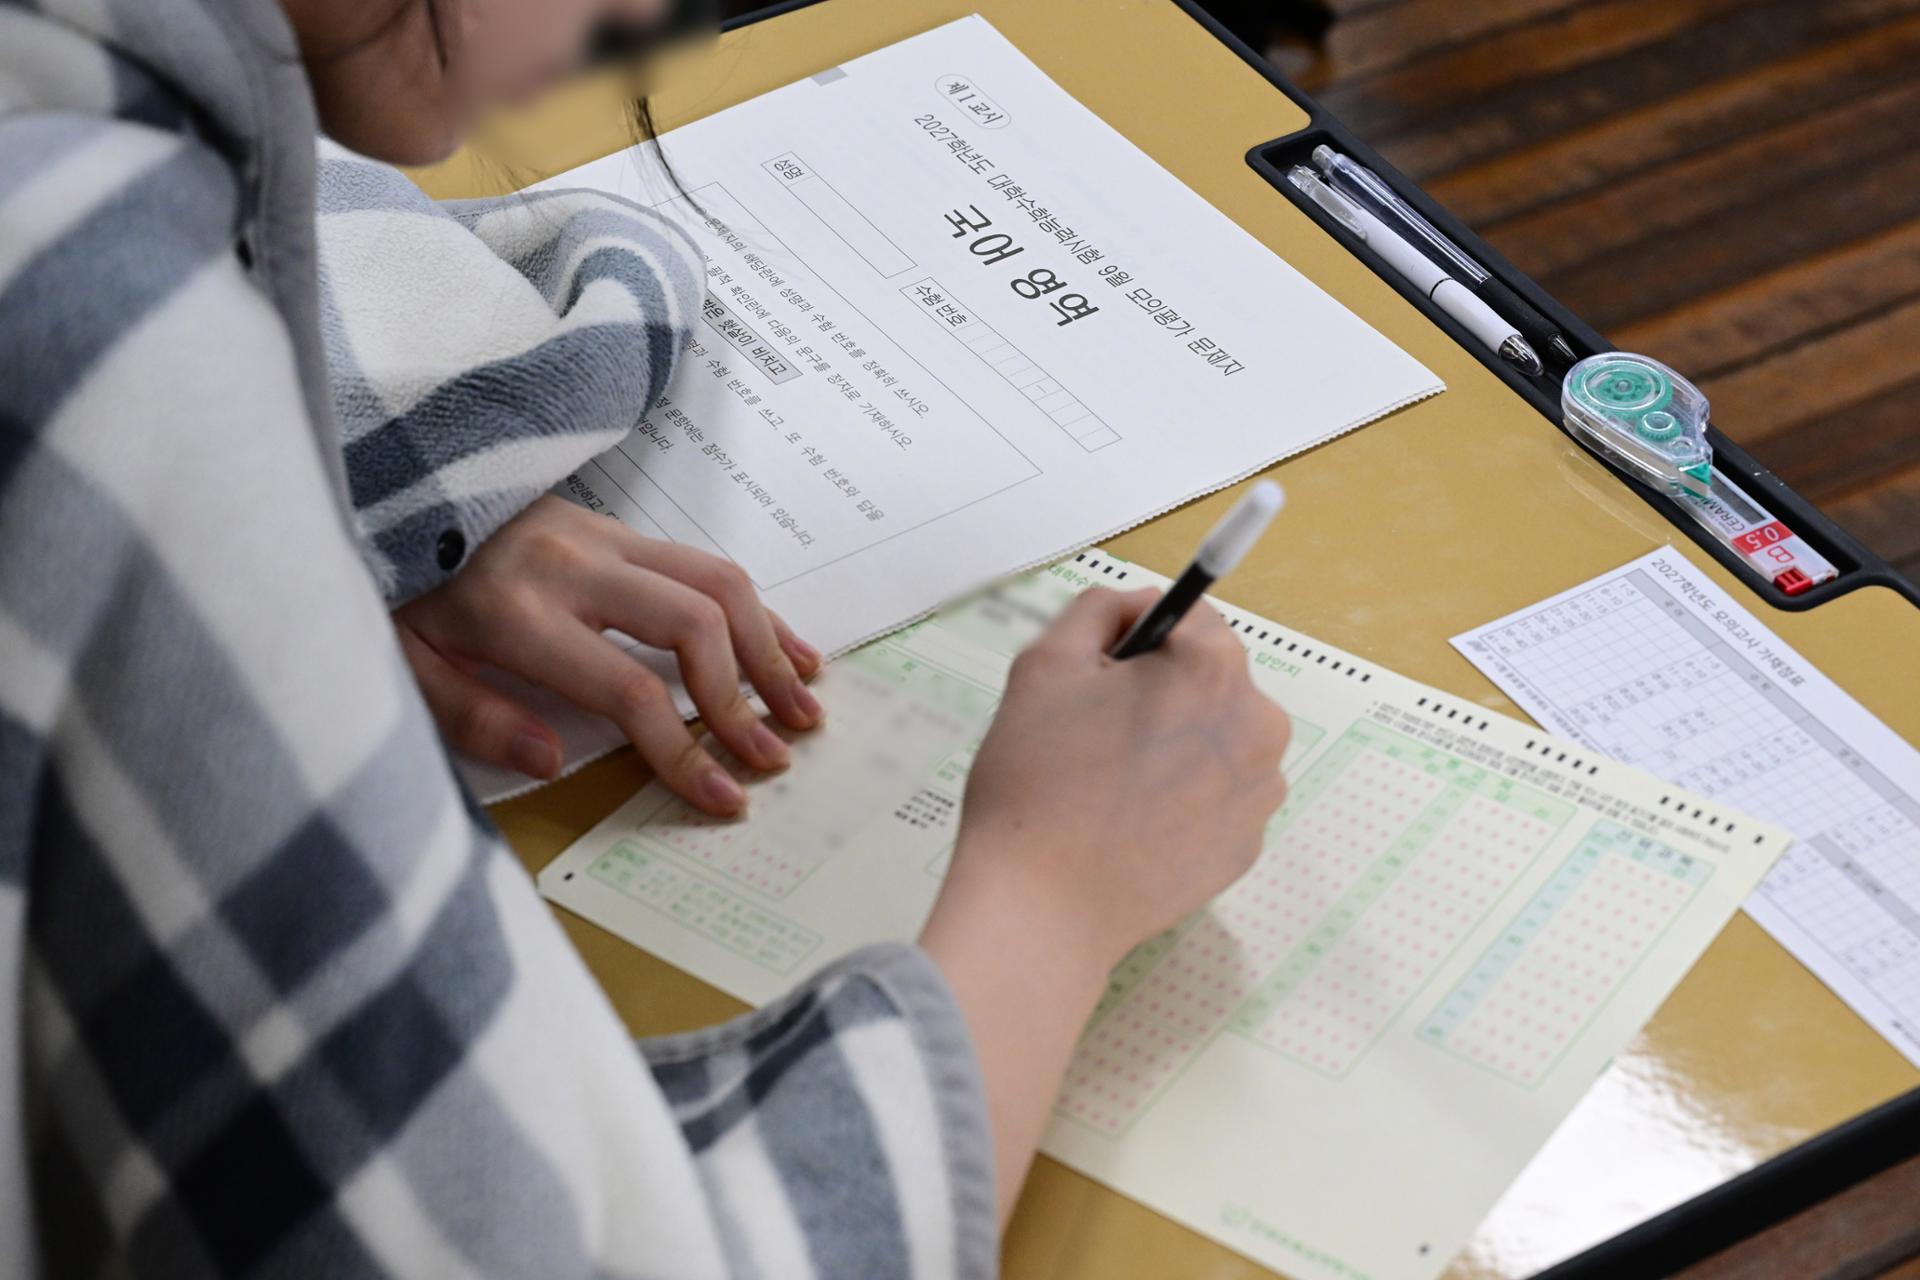
OpenAIs neuestes KI-Modell hat erstmals eine perfekte Punktzahl in Südkoreas College Scholastic Ability Test (CSAT) erzielt, wie eine neu veröffentlichte Analyse zeigt. Während Spitzmodelle bereits früher nahezu perfekte Ergebnisse erzielten, zieht dieser Fall besondere Aufmerksamkeit auf sich, weil das Modell dabei fewer Tokens als seine Konkurrenten verbrauchte – eine betriebswirtschaftlich relevante Kennzahl, da der Token-Verbrauch direkt in Inferenzkosten für Entwickler und Unternehmen umschlägt, die diese Modelle im großen Maßstab einsetzen.
Die am Sonntag auf GitHub veröffentlichten Ergebnisse zeigten, dass OpenAIs neues GPT-6 Astra das einzige bewertete Modell war, das im 2026 CSAT LLM Solution Log volle 450 Punkte erreichte. Die Bewertung testete die Modelle mit Fragen des CSAT 2026 aus Koreanisch, Englisch, Mathematik, koreanischer Geschichte sowie vier Wahlfächern – Physik I, Chemie I, Biologie I sowie Gesellschaft und Kultur – ohne Internetzugang. Der CSAT, eine standardisierte Prüfung, die jährlich von Hunderttausenden koreanischen Schülern abgelegt wird, hat sich zu einem wiederkehrenden Maßstab dafür entwickelt, wie gut führende Modelle mehrsprachiges, fachübergreifendes Denken unter Prüfungsbedingungen bewältigen.
Astra war das erste KI-Modell, das in der Bewertung in allen getesteten Fächern die volle Punktzahl erreichte. Im Februar hatte Googles Gemini 3.1 Pro mit nur zwei Wahlfächern – Chemie I und Biologie I – eine perfekte Punktzahl erzielt, unter dem in dieser Bewertung verwendeten breiteren Format jedoch Fragen in Physik I und einem Gesellschaftsfach verfehlt.
In den am Sonntag veröffentlichten Ranglisten belegte OpenAIs GPT-5.6 mit 448,5 Punkten den zweiten Platz, gefolgt von GPT-5.4 auf Rang drei mit 448. Anthropics Claude Fable 5.1 kam mit 447,5 auf den vierten Platz, Gemini 3.1 Pro mit 445 auf den fünften.
GPT-6 Astra verbrauchte 357.000 Tokens – der niedrigste öffentlich gemeldete Gesamtwert. Zum Vergleich: GPT-5.6 verbrauchte 429.000 Tokens und Claude Fable 5.1 562.000. Da die Prüfungsaufgaben und Antworten öffentlich verfügbar waren, lässt sich ein früherer Kontakt über Trainingsdaten nicht ausschließen, wobei Konkurrenzmodelle wie Claude Fable 5.1 und Gemini 3.1 Pro unter denselben Bedingungen antraten.
Die starke Leistung bei zugleich geringerem Token-Verbrauch wird auf ein Design zurückgeführt, das den Kontext bei sich wiederholenden Aufgaben bewahrt und mit dem Denken verknüpft ist. Ein sogenannter Provider-Adapter-Harness komprimiert Informationen aus früheren Denkschritten und verwertet sie erneut, sodass die KI die Prüfung in einer Weise absolviert, die dem Vorgehen eines sehr guten Schülers ähnelt.
Lee Seung-hyun, adjunct professor an der Hanyang-Universität, sagte, entscheidend sei nicht allein, dass das Modell intelligenter geworden sei, sondern dass es frühere Denkschritte bewahren, den Kontext komprimieren und seinen Plan revidieren könne. „Das bedeutet, dass es nicht jedes Mal härter nachdenkt, sondern dort weitermacht, wo es zuvor bereits eine Lösung gefunden hatte“, so Lee.
OpenAI bezeichnete das Ergebnis als ermutigend und verwies darauf, dass das Modell mit Hyperscale-KI-Recheninfrastruktur eine effiziente Verarbeitung erreiche. Ein OpenAI-Vertreter sagte, dieser Meilenstein zeige, dass Modelle leistungsfähiger werden und gleichzeitig ihre Performance verbessern und Kosten senken können.
Branchenexperten mahnten jedoch, das Potenzial eines Modells anhand seiner Fähigkeit zu beurteilen, offene Probleme zu lösen, statt sich allein auf standardisierte Prüfungsergebnisse zu stützen. Ein Insider aus der koreanischen KI-Branche sagte, es wäre bedeutsamer, wenn KI reale Herausforderungen im Arbeitsumfeld bewältigen könne, für die es keine vordefinierten Antworten gebe. Wie führende Modelle in breiteren, unabhängigen Benchmarks abschneiden – und ob Konkurrenten den Effizienzvorsprung aufholen – wird zeigen, ob dieses Ergebnis eine dauerhafte Verschiebung des Kosten-Nutzen-Verhältnisses markiert.
Dieser Artikel basiert auf einem Bericht des Hankook Ilbo, der Schwesterpublikation der Korea Times, der von einem generativen KI-System übersetzt und von der Korea Times redigiert wurde. Originalquelle: The Korea Times.
