xAI 的 Grok 4.7 在法律代理基準測試中超越 Anthropic 與 OpenAI 模型,價格僅為其幾分之一
重點速覽
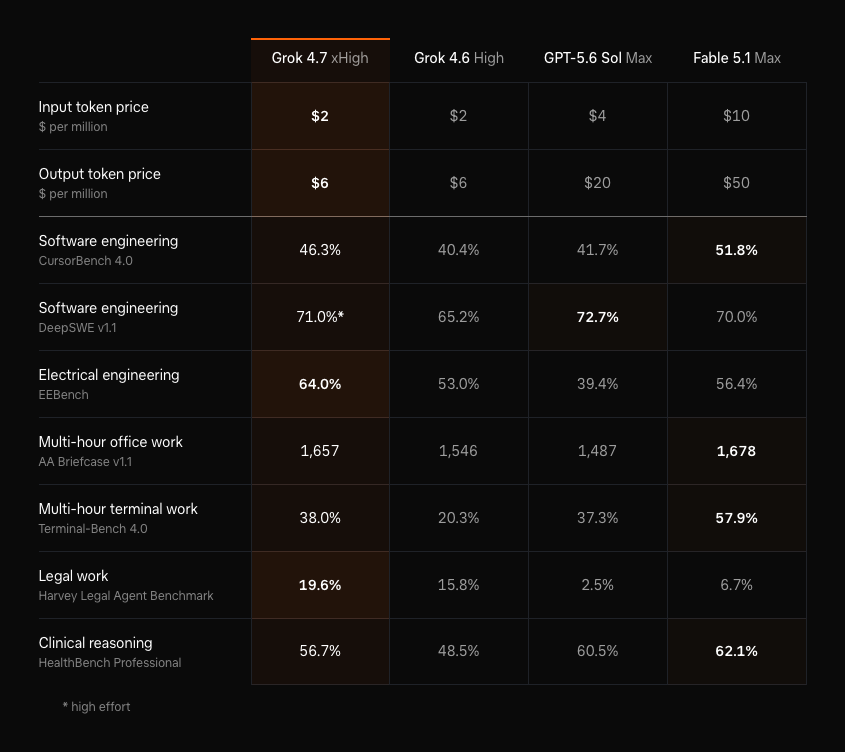
- •Grok 4.7 在 Harvey Legal Agent Benchmark 上得分 19.6%,約為 Anthropic 的 Fable 5.1 的 6.7% 的三倍,接近 OpenAI 的 GPT-5.6 Sol 的 2.5% 的八倍。
- •該模型定價為每百萬輸入代幣 2 美元、每百萬輸出代幣 6 美元,輸入成本為 Fable 5.1 的 10 美元的五分之一、GPT-5.6 Sol 的 4 美元的一半。
- •Anthropic 的 Fable 5.1 在較長的程式編寫與終端基準上保持大幅領先,在 Terminal-Bench 4.0 上以約 20 個百分點勝過 Grok 4.7。
- •Grok 4.7 擁有 2.1 兆參數,比代多 40%,並使用了包括 Starlink 衛星遙測與製造記錄在內的 SpaceX 補充資料進行訓練。
- •所有公佈的基準數據均來自 xAI 自行測試而非獨立驗證,且其性價比圖表所依據的 CursorBench 由 Cursor 開發,SpaceX 近期已完成收購。
xAI 於週一推出 Grok 4.7,這款新旗艦模型在法律代理基準測試中的得分超過 Anthropic 的 Fable 5.1 與 OpenAI 的 GPT-5.6 Sol,而每百萬輸入代幣的價格僅為 Fable 5.1 的五分之一。
根據 xAI 的發布公告,Grok 4.7 在 Harvey Legal Agent Benchmark 上得分 19.6%,Fable 5.1 為 6.7%,GPT-5.6 Sol 則為 2.5%。這使得 Grok 4.7 的得分約為 Anthropic 的三倍,接近 Sol 的八倍。Cryptopolitan 上個月曾報導,該公司先前的模型 Grok 4.6 已以 15.8% 領先這兩款模型。Harvey 基準測試由法律科技公司 Harvey 維護,評估模型在多步驟法律工作上的表現,是 AI 代理應用最受矚目的專業領域之一。
法律工作是 Grok 4.7 在少數幾個領域中同時明顯勝過兩家競爭對手的項目之一。該模型在 EEBench 電機工程測試上也勝過 Fable 5.1,並在 DeepSWE 程式編寫基準上小幅領先。
定價與性價比
Grok 4.7 定價為每百萬輸入代幣 2 美元、每百萬輸出代幣 6 美元——與 Grok 4.6 相同。其輸入價格是 GPT-5.6 Sol 的 4 美元的一半,也是 Fable 5.1 的 10 美元的五分之一。在輸出方面,Grok 4.7 收費 6 美元,而 Sol 為 20 美元、Fable 為 50 美元,約為 Anthropic 費率的八分之一。每百萬代幣費率是 API 供應商的標準計費方式——輸入代幣涵蓋模型讀取的內容,輸出代幣涵蓋其生成的內——因此這些標價是開發者在選擇前沿模型時所衡量的數字。
xAI 也將 CursorBench 4.0 的得分與每項完成任務的平均成本對照,並聲稱該模型位於性價比前沿。Grok 4.7 在該圖表上以每項任務約 6 美元的成本達到約 46%,而 Claude Opus 5 需要將近兩倍的花費才能取得類似成果。Fable 5.1 在更高預算下表現較佳,在每項任務約 17 美元時攀升至 51.8%。
Elon Musk 在 X 上的一則貼文中形容此次發布是「智慧、速度與低成本的強勁結合」。
Anthropic 在終端與程式編寫測試上保持領先
Grok 4.7 在 GDPval 與 AA Briefcase 辦公工作測試上屈居 Fable 5.1 之後,Anthropic 的模型在較長的程式編寫與終端基準上保持明顯領先。差距最大的是 Terminal-Bench 4.0,Fable 5.1 得分 57.9%,而 Grok 4.7 為 38.0%——差距約 20 個百分點。Fable 在 CursorBench 以及 HealthBench Professional 臨床推理測試上也保持領先,後者中 GPT-5.6 Sol 同樣勝過 Grok。
Grok 4.7 在 GDPval 上獲得 1,695 Elo 分數,該基準評估模型在律師、護理師與金融分析師所執行任務上的表現,高於 Grok 4.6 的 1,605 分。此成績落後 Fable 5.1 的 1,735 分,但領先 OpenAI 較新的 GPT-6 Astra 在同一圖表上的 1,542 分。Elo 評分源自國際象棋,依相對表現而非原始百分比為模型排名。
綜合來看,Grok 4.7 在七項基準中的五項領先 GPT-5.6 Sol,僅在 DeepSWE 與臨床測試上落敗。
以 SpaceX 數據訓練的更大模型
Grok 4.7 擁有 2.1 兆參數,比驅動 Grok 4.6 的 1.5 兆多出 40%。xAI 加入了 SpaceX 的補充訓練資料,包括 Starlink 衛星遙測與製造記錄,並表示新模型比前代更有可能花費額外時間處理艱難問題並反覆核對自己的答案。
該模型已在 Grok 應用程式、Cursor、Grok Build 以及 xAI 上線,無需候補名單。
上述所有數據均來自 xAI 自行測試,而非獨立驗證。作為 xAI 性價比圖表依據的 CursorBench 由 Cursor 開發,SpaceX 已於上個月完成對 Cursor 的收購。xAI 以 GPT-5.6 Sol 作為對比基準,而 OpenAI 較新的 GPT-6 Astra 僅出現在 GDPval、AA Briefcase 與 EEBench 的比較中。第三方評估將是對這些差距的首次外部檢驗。

