醫療 AI 的準確度進展超越患者療效改善的證據
重點速覽
- •一項涵蓋肯亞 16 家 Penda Health 醫療機構的隨機試驗發現,大型語言模型支援改善了病歷記錄與診斷品質,但並未顯著降低 14 天治療失敗率——AI 組為 2.2%,對照組為 2%。
- •美國 FDA 於 8 月 18 日發布了一份關於生成式 AI 醫療器材監管的討論文件,開放公眾意見至 10 月 19 日,內容涵蓋風險評估、上市前評估與上市後監測。
- •一項多國試驗發現 GPT-4o 使 249 名醫生在臨床情境模擬題上的表現提升了 7.2% 至 18%,但該研究使用模擬病例且未評估危害,因此真實世界的患者效益仍未確立。
- •《npj Digital Medicine》的一篇評論警告,有臨床醫生在環並不能保證有效的監督,因為自動化偏誤可能使有缺陷的 AI 建議更容易被接受。
- •MarketsandMarkets 預計醫療 AI 市場將從 2026 年的 366.7 億美元成長至 2031 年的 1,947.9 億美元,複合年成長率為 39.7%。
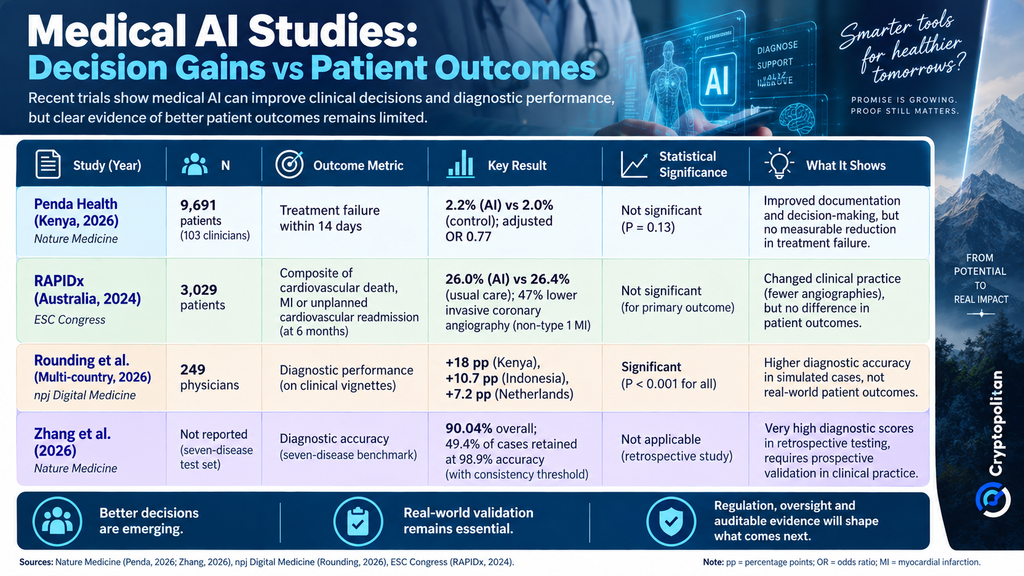
2026 年越來越多的研究凸顯了醫療人工智慧中一個持續存在的落差:這些系統能夠影響醫生的決策並產生令人印象深刻的診斷結果,卻未能證明患者最終變得更健康。
這個問題對於評估 AI 工具的醫院、尋求證明其價值的企業,以及決定這些系統進入臨床實務後應要求何種證據的監管機構而言都至關重要。
監管機構開始審視醫療 AI 的證明問題
AI 所宣稱的表現與對患者實際益處之間的落差,正變得越來越難以忽視。《金融時報》(Financial Times) 在一則標題中總結了這個問題:「醫療 AI 存在證明問題。」
這個問題已超越學術討論的範疇。美國食品藥物管理局(FDA)在考量如何於部署前後評估 AI 醫療器材時,也正在審視許多相同的議題。一份8 月 18 日發布的討論文件開放公眾意見至 10 月 19 日,內容涵蓋風險評估、上市前評估與上市後監測。
FDA 強調,該文件僅為討論文件,並非草案指引、擬議的政策變更,也不代表未來的監管預期。儘管如此,這個開放的意見徵集窗口為醫院、器材製造商和研究人員提供了一個正式管道,以闡述他們認為臨床部署應需要哪些類型的證據。
FDA 之前曾就衡量與評估 AI 醫療器材的真實世界表現發布公眾意見徵集,其中也提出了對模型漂移以及依賴靜態指標之局限性的疑慮。模型漂移——即當真實世界的患者或臨床模式偏離模型的訓練資料時可能發生的效能衰退——是工具在上市時通過驗證、數月後表現卻可能不同的原因之一。這留下了一個更廣泛的問題:當 AI 系統離開實驗室進入臨床照護後,應如何衡量其安全性與有效性?
在肯亞,AI 支援並未降低治療失敗率
6 月 26 日發表於《自然學》(Nature Medicine) 的一項研究,檢視了用於臨床決策的大型語言模型是否能改善患者療效。這項研究涉及奈洛比與基安杜郡 16 家 Penda Health 醫療機構的 103 名臨床醫事人員。這些人員在有大型語言模型協助或無協助的情況下為患者進行治療。
在 9,691 名登記患者中,9,347 名被納入主要分析。AI 組的 14 天治療失敗率為 2.2%,對照組為 2%。調整後的勝算比為 0.77,但差異不具統計顯著性(P=0.13)。該介入措施未發生任何嚴重不良事件。
AI 支援組展現了更好的病歷記錄以及更適當的診斷與治療計畫。然而,這些過程指標的改善並未帶來患者療效的提升。這個落差正是證明問題的核心:病歷記錄和診斷品質等指標遠比治療失敗等療效結果更容易收集,但 Penda 的結果顯示兩者可能各自獨立變動。
2024 年的 RAPIDx AI 試驗也出現了類似的模式。在主要分析的 3,029 名患者中,接受 AI 支援照護的患者出現心血管死亡、心肌梗塞或非計畫性心血管再入院等六個月複合療效結果的比例為 26%,而接受標準照護者為 26.4%。然而,在非第一型心肌梗塞組中,AI 支援照護下執行侵入性冠狀動脈造影的頻率低了 47%。
更高的測試分數並未確立真實世界的效益
一項由 Nicholas Rounding 領導的多國隨機試驗發現,GPT-4o 使 249 名醫生在臨床情境模擬題上的表現提升了肯亞 18%、印尼 10.7%、荷蘭 7.2%(P<0.001)。然而,這項研究使用的是模擬病例而非真實的臨床情境。對照組的參與者無法使用網路或臨床指引,且該研究並未評估危害。
這些結果顯示 AI 可以在受控環境中提升表現,但並未確立其對患者療效的影響。這種受控環境與真實世界之間的區別,正是 FDA 上市前與上市後問題所針對的核心。
另一項由 Li Zhang、Jakob Nikolas Kather 及其同事進行的《自然醫學》研究,在七種疾病的基準測試中報告了 90.04% 的準確率。透過引入一致性閾值,現場代理保留了 49.4% 的病例,準確率達 98.9%,其餘病例則由人類專業人員審查。作者表示,這些發現需要在真實臨床環境中進行的試驗進一步證實。該研究可於此處查閱。
有醫生「在環」並不足夠
由 Joy Xu、Justin Ko 和 Joseph Kvedar 彙編的證據地圖發現,代理式 AI 不僅用於行政工作,還用於診斷、管理和其他醫療保健任務。因此,治理和稽核這些系統的能力變得越來越重要。該證據地圖可於此處查閱。
《npj Digital Medicine》上的篇評論指出,僅有臨床醫生參與並不能保證有效的監督與治理。自動化偏誤可能使人們更容易接受有缺陷的建議。有效的監督需要足夠的知識、時間和權限來質疑系統並在必要時介入。
作者警告,若缺乏這些條件,人類監督可能淪為僅是責任的後盾:
責任可能崩塌到臨床醫生身上,而他們被期待去發現自己其實難以偵測或糾正的錯誤……形成一個道德潰縮區(moral crumple zone)。
因此,這場辯論不僅涉及人類在技術上是否「在環」,還涉及該人員是否具備在必要時質疑、覆寫和停止系統的能力。該評論可於此處查閱。
商業利益增加證據的重要性
MarketsandMarkets 預計醫療 AI 市場將從 2026 年的 366.7 億美元成長至 2031 年的 1,947.9 億美元,複合年成長率為 39.7%。這份市場預測發布之際,醫院正準備做出更多 AI 採購決策,而患者療效改善的證據仍然參差不齊。
這種環境可能會增加對某些更難以行銷、但對醫療提供者更有價值的驗證形式的壓力:前瞻性測試、本地效能監測以及可獨立稽核的監督。近期的觀察指標之一,將是 FDA 就其討論文件所收到的意見,該文件的公眾意見徵集將開放至 10 月 19 日。

