xAI的Grok 4.7在法律智能体基准测试中以更低价格超越Anthropic和OpenAI模型
要点速览
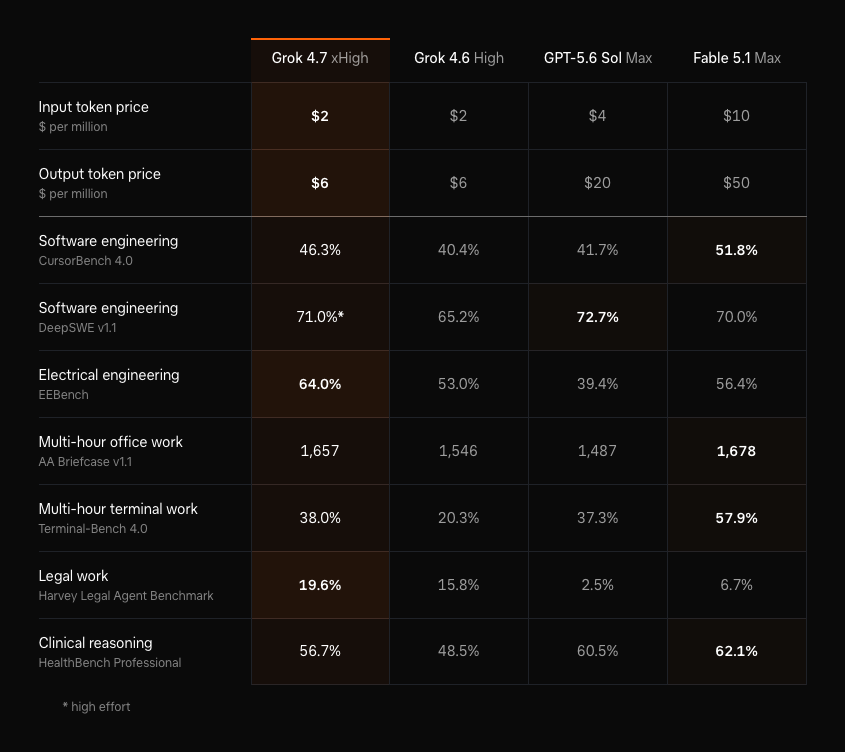
- •Grok 4.7在Harvey法律智能体基准测试中得分19.6%,约为Anthropic的Fable 5.1(6.7%)的三倍,接近OpenAI的GPT-5.6 Sol(2.5%)的八倍。
- •该模型定价为每百万输入代币2美元、每百万输出代币6美元,输入成本为Fable 5.1(10美元)的五分之一、GPT-5.6 Sol(4美元)的一半。
- •Anthropic的Fable 5.1在更长的编程和终端基准测试中保持显著领先,在Terminal-Bench 4.0上以约20个百分点的优势击败Grok 4.7。
- •Grok 4.7拥有2.1万亿参数,比前代多40%,并使用了包括Starlink卫星遥测数据和制造记录在内的SpaceX补充训练数据。
- •所有公布的基准测试数据均来自xAI自身的测试而非独立验证,其性价比图表所依据的CursorBench由SpaceX近期收购的Cursor开发。
xAI于周一发布了Grok 4.7,推出了一款在法律智能体基准测试中得分超过Anthropic的Fable 5.1和OpenAI的GPT-5.6 Sol、同时输入代币价格仅为Fable 5.1五分之一的新旗舰模型。
根据xAI的发布公告,Grok 4.7在Harvey法律智能体基准测试中得分19.6%,而Fable 5.1为6.7%,GPT-5.6 Sol为2.5%。这使Grok 4.7的得分约为Anthropic的三倍,接近Sol的八倍。Cryptopolitan上月曾报道,该公司上一代模型Grok 4.6已以15.8%的得分领先这两款模型。Harvey基准测试由法律科技公司Harvey维护,评估模型在多步骤法律工作中的表现,是智能体AI应用最受关注的专业领域之一。
法律工作是为数不多的Grok 4.7全面超越两家竞争对手的领域之一。该模型还在EEBench电气工程测试中胜过Fable 5.1,并在DeepSWE编程基准测试中略胜一筹。
定价与性价比
Grok 4.7的定价为每百万输入代币2美元、每百万输出代币6美元——与Grok 4.6相同。该输入价格是GPT-5.6 Sol的4美元的一半,是Fable 5.1的10美元的五分之一。在输出方面,Grok 4.7收费6美元,而Sol为20美元,Fable为50美元,约为Anthropic费率的八分之一。按百万代币计费是API提供商的标准收费方式——输入代币涵盖模型读取的内容,输出代币涵盖模型生成的内容——因此这些标价是开发者在选择前沿模型时权衡的关键数字。
xAI还将CursorBench 4.0得分与每项已完成任务的平均成本进行对比,并声称该模型处于性价比前沿。Grok 4.7在该图表上以每项任务约6美元的成本达到约46%,而Claude Opus 5需要接近两倍的支出才能取得类似结果。Fable 5.1在更高预算下表现更好,在每项任务约17美元时攀升至51.8%。
Elon Musk在X上发帖称此次发布是“智能、速度与低成本的强劲组合”。
Anthropic在终端和编程测试中保持领先
Grok 4.7在GDPval和AA Briefcase办公工作测试中均屈居Fable 5.1之后,Anthropic的模型在更长的编程和终端基准测试中保持明显领先。差距最大的是Terminal-Bench 4.0,Fable 5.1得分为57.9%,而Grok 4.7为38.0%——差距约20个百分点。Fable在CursorBench以及HealthBench Professional临床推理测试中也处于领先地位,GPT-5.6 Sol在该临床测试中同样击败了Grok。
Grok 4.7在GDPval上获得1,695的Elo评分,该基准测试评估模型在律师、护士和金融分析师所完成任务上的表现,高于Grok 4.6的1,605。这一成绩落后于Fable 5.1的1,735,但领先于OpenAI较新的GPT-6 Astra在同一图表上取得的1,542。Elo评分改编自国际象棋,根据相对成绩而非原始百分比得分对模型进行排名。
综合来看,Grok 4.7在七项基准测试中有五项领先于GPT-5.6 Sol仅在DeepSWE和临床测试中落败。
使用SpaceX数据训练的更大模型
Grok 4.7拥有2.1万亿参数,比驱动Grok 4.6的1.5万亿多40%。xAI加入了SpaceX补充训练数据,包括Starlink卫星遥测数据和制造记录,并表示新模型也比前代更有可能花额外时间钻研棘手问题并复核自己的答案。
该模型已在Grok应用、Cursor、Grok Build和xAI上同步上线,无需排队等候。
上述所有数据均来自xAI自身的测试,而非独立验证。CursorBench——xAI性价比图表所依据的基准测试——由Cursor开发,SpaceX上月完成了对该公司的收购。xAI将Grok 4.7与GPT-5.6 Sol进行对比,而OpenAI较新的GPT-6 Astra仅出现在GDPval、AA Briefcase和EEBench的对比中。第三方评估将是对这些差距的首次外部检验。

