医疗AI的准确率提升速度已超过患者获益证据的积累速度
要点速览
- •一项覆盖肯尼亚16家Penda Health机构的随机试验发现,大语言模型支持改善了文档记录和诊断质量,但并未显著降低14天治疗失败率,AI组为2.2%,对照组为2%。
- •美国FDA于8月18日发布了一份关于监管生成式AI医疗器械的讨论文件,公开征求意见至10月19日,内容涵盖风险评估、上市前评估和上市后监测。
- •一项多国试验发现GPT-4o使249名医生在临床病例情境中的表现提升了7.2%至18%,但该研究使用模拟病例且未评估危害,因此真实世界中的患者获益仍未确立。
- •《npj Digital Medicine》的一篇评论警告称,有临床医生“在环”并不能保证有效监督,因为自动化偏差会使有缺陷的AI建议更容易被接受。
- •MarketsandMarkets预计医疗AI市场规模将从2026年的366.7亿美元增长到2031年的1947.9亿美元,年复合增长率为39.7%。
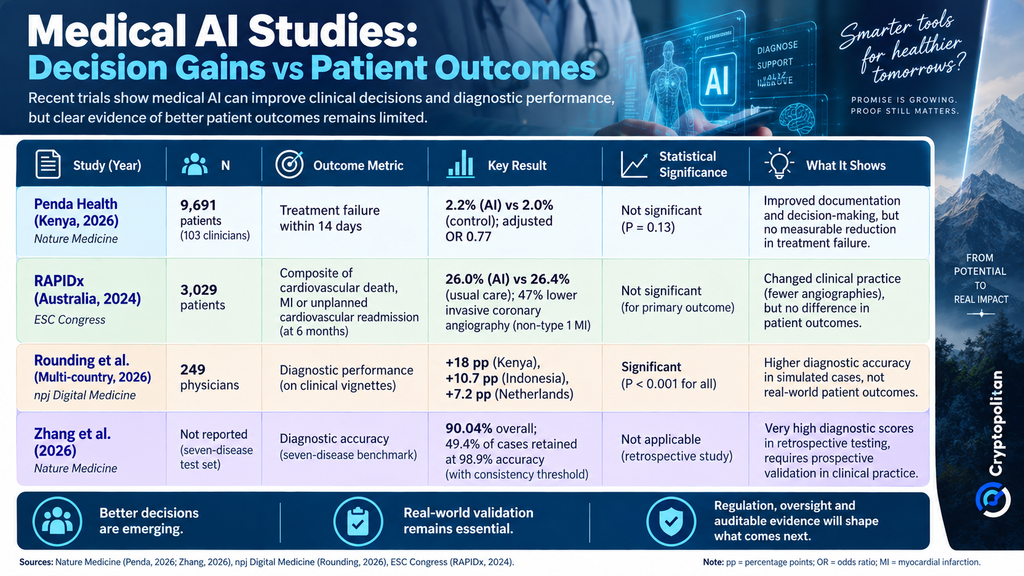
2026年,越来越多的研究凸显了医疗人工智能领域一个持续存在的差距:这些系统能够影响医生的决策并产生令人印象深刻的诊断结果,却未能证明患者最终变得更健康。
这一问题对评估AI工具的医院、试图证明其价值的公司,以及在系统进入临床实践后决定应要求何种证据的监管机构都至关重要。
监管机构开始审视医疗AI的证明难题
AI所报告的性能与已证实的患者获益之间的差距正变得愈发难以忽视。《金融时报》在一则标题中概括了这一问题:“医疗AI存在证明难题。”
这一问题已不再局限于学术讨论。美国食品药品监督管理局(FDA)在考虑如何在AI医疗器械部署前后对其进行评估时,也在审视许多同样的问题。一份8月18日的讨论文件公开征求意见至10月19日,内容涉及风险评估、上市前评估和上市后监测。
FDA强调,该文件仅为讨论文件,并非指导原则草案、拟议的政策变更,也不代表未来的监管预期。尽管如此,公开的征求意见窗口为医院、器械制造商和研究人员提供了一个正式渠道,以阐明他们认为临床部署应当需要哪些类型的证据。
此前,FDA曾就如何测量与评估AI医疗器械的真实世界表现公开征求意见,其中也提出了模型漂移以及依赖静态指标的局限性等顾虑。模型漂移——即当真实世界的患者或诊疗模式与模型训练数据出现偏差时可能发生的性能退化——是导致工具在上线时经过验证、数月后却可能表现不同的原因之一。这留下一个更宏观的问题:当AI系统离开实验室进入临床诊疗后,应如何衡量其安全性与有效性?
在肯尼亚,AI支持并未降低治疗失败率
《自然·医学》6月26日发表的一项研究考察了用于临床决策的大语言模型(LLM)是否能改善患者结局。该研究涉及内罗毕郡和基安布郡16家Penda Health机构的103名临床医师。这些医师在有或没有大语言模型辅助的情况下为患者提供诊疗。
在9691名登记患者中,9347人被纳入主分析。14天后治疗失败发生率在AI组为2.2%,对照组为2%。调整后比值比为0.77,但差异无统计学意义(P=0.13)。该干预未引发任何严重不良事件。
AI支持组的文档记录更完善,诊断和治疗方案也更恰当。然而,这些过程指标的改善并未带来患者结局的改善。这一差距正是证明难题的核心:文档记录和诊断质量等指标远比治疗失败等结局更容易收集,但Penda的结果表明,两者可能各自独立变化。
2024年的RAPIDx AI试验也出现了类似的格局。在3029名患者的主分析中,接受AI支持诊疗的患者在6个月内心血管死亡、心肌梗死或非计划心血管再入院的综合结局发生率为26%,而接受标准诊疗的患者为26.%。不过,在非1型心肌梗死组中,AI支持诊疗下有创冠状动脉造影的实施频率降低了47%。
测试分数不断攀升,真实世界证据仍然滞后
由Nicholas Rounding牵头的一项多国随机试验发现,GPT-4o使249名医生在临床病例情境中的表现提升了18%(肯尼亚)、10.7%(印度尼西亚)和7.2%(荷兰)(P<0.001)。然而,该研究使用的是模拟病例,而非真实临床场景。对照组参与者无法使用互联网或临床规程,且研究未评估潜在危害。
结果表明AI可以在受控环境中提升表现,但并未确立其对患者结局的影响。这种受控环境与真实世界之间的区别,正是FDA上市前和上市后问题所针对的核心。
李樟(Li Zhang)、Jakob Nikolas Kather及其同事在《自然·医学》上发表的另一项研究报告了在七种疾病基准上达到90.04%的准确率。通过引入一致性阈值,现场智能体保留了49.4%的病例,准确率达98.9%,其余病例则由人类专业人员审核。作者表示,这些发现需要在真实临床环境中开展的试验进一步确认。该研究可在此查阅。
有医生“在环”并不足以解决问题
由Joy Xu、Justin Ko和Joseph Kvedar编制的一份证据图谱显示,智能体AI不仅用于行政工作,还用于诊断、管理及其他医疗任务。因此,治理和审计这些系统的能力正变得日益重要。该证据图谱可在此查阅。
《npj Digital Medicine》上的一篇评论指出,仅仅让临床医生参与并不能保证有效的监督和治理。自动化偏差会使人更容易接受有缺陷的建议,而有意义的监督需要足够的知识、时间和权限来质疑系统并在必要时进行干预。
作者警告,如果缺乏这些条件,人类监督可能沦为一种责任兜底机制:
责任可能全部落在临床医生身上,而他们往往并不具备发现或纠正这些错误的有利条件……成为一个“道德缓冲区”。
因此,争论的焦点已不只是人类在技术上是否“在环”,还包括这个人是否真正具备质疑、否决和必要时叫停系统的能力。该评论可在此查阅。
商业利益使证据问题愈发重要
MarketsandMarkets预计,医疗AI市场规模将从2026年的366.7亿美元增长到2031年的1947.9亿美元,年复合增长率为39.7%。这一市场预测发布之际,医院即将做出更多AI采购决策,而患者结局改善的证据仍不均衡。
在这种环境下,那些更难营销但对医疗提供方更有价值的验证方式可能面临更大的压力,包括前瞻性测试、本地化性能监测以及可独立审计的监督。一个近期观察指标将是FDA就其讨论文件收到的反馈意见,该文件公开征求意见至10月19日。

