Grok 4.7 от xAI обходит модели Anthropic и OpenAI в юридическом бенчмарке за малую долю цены
Ключевые выводы
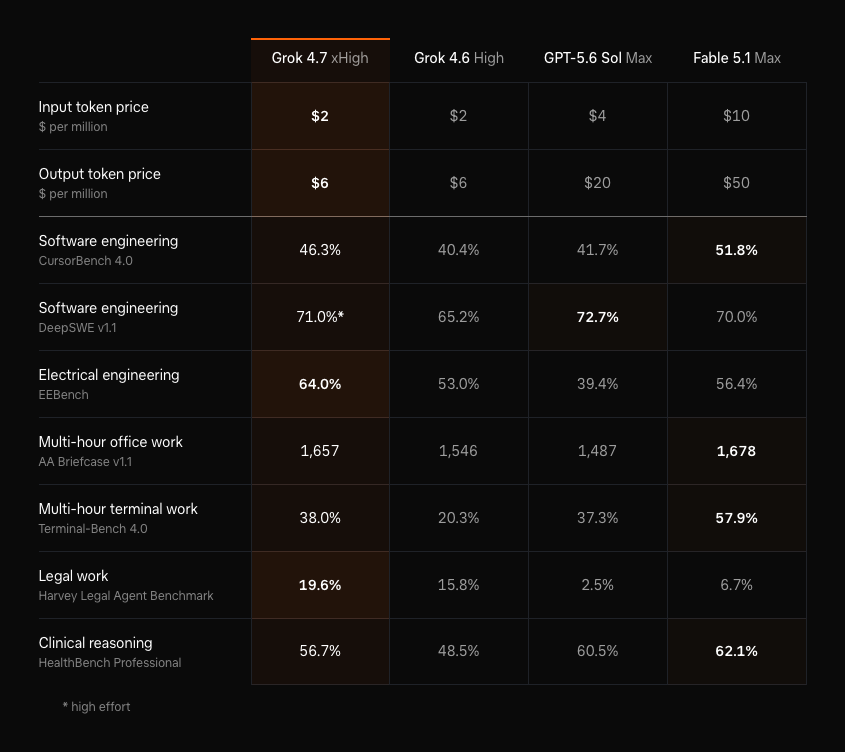
- •Grok 4.7 набрала 19,6% на Harvey Legal Agent Benchmark — примерно втрое больше, чем Fable 5.1 от Anthropic с 6,7%, и почти в восемь раз больше, чем 2,5% у GPT-5.6 Sol от OpenAI.
- •Модель стоит $2 за миллион входных токенов и $6 за миллион выходных, что делает стоимость входа в пять раз ниже, чем $10 у Fable 5.1, и вдвое ниже, чем $4 у GPT-5.6 Sol.
- •Fable 5.1 от Anthropic сохраняет значительное преимущество в более длительных кодинговых и терминальных бенчмарках, выигрывая Terminal-Bench 4.0 с отрывом примерно в 20 процентных пунктов у Grok 4.7.
- •Grok 4.7 работает на 2,1 трлн параметров — на 40% больше, чем у предшественницы, и обучалась с дополнительными данными SpaceX, включая телеметрию спутников Starlink и производственные записи.
- •Все опубликованные результаты бенчмарков получены из собственных тестов xAI, а не из независимой проверки, а CursorBench, лежащий в основе графика цены и производительности, создан компанией Cursor, недавно приобретенной SpaceX.
В понедельник xAI запустила Grok 4.7 — новую флагманскую модель, которая обошла Fable 5.1 от Anthropic и GPT-5.6 Sol от OpenAI в юридическом бенчмарке, взимая при этом лишь пятую часть цены Fable 5.1 за входной токен.
Согласно анонсу релиза xAI, Grok 4.7 набрала 19,6% на Harvey Legal Agent Benchmark, где Fable 5.1 достигла 6,7%, а GPT-5.6 Sol — 2,5%. Это примерно в три раза выше результата Anthropic и почти в восемь раз выше результата Sol. Cryptopolitan сообщал в прошлом месяце, что предыдущая модель компании, Grok 4.6, уже опережала эту пару с результатом 15,8%. Бенчмарк Harvey поддерживается юридической технологической компанией Harvey и оценивает модели на многоэтапной юридической работе — одной из профессиональных областей, где внедрение агентного ИИ отслеживается наиболее внимательно.
Юридическая работа выделяется как одна из немногих областей, где Grok 4.7 однозначно превосходит обоих конкурентов. Модель также обходит Fable 5.1 в тесте по электротехнике EEBench и незначительно опережает её в кодинговом бенчмарке DeepSWE.
Цены и соотношение цены и производительности
Grok 4.7 стоит $2 за миллион входных токенов и $6 за миллион выходных — те же тарифы, что и у Grok 4.6. Эта цена входа составляет половину от $4 у GPT-5.6 Sol и одну пятую от $10 у Fable 5.1. По выходным токенам Grok 4.7 берёт $6 против $20 у Sol и $50 у Fable — примерно одну восьмую ставки Anthropic. Тарифы за миллион токенов — стандартный способ выставления счетов провайдерами API: входные токены покрывают то, что модель читает, выходные — то, что она пишет, поэтому именно эти цены разработчики сопоставляют при выборе между флагманскими моделями.
xAI также сопоставила результаты CursorBench 4.0 со средней стоимостью выполненной задачи и заявляет, что модель находится на границе соотношения цены и производительности. Grok 4.7 достигает около 46% на этом графике при примерно $6 за задачу, тогда как Claude Opus 5 требует почти вдвое больших затрат для аналогичного результата. Fable 5.1 показывает себя лучше при больших бюджетах, поднимаясь до 51,8% при примерно $17 за задачу.
Илон Маск назвал релиз «сильным сочетанием интеллекта, скорости и низкой стоимости» в публикации на X.
Anthropic сохраняет лидерство в терминальных и кодинговых тестах
Grok 4.7 заняла второе место после Fable 5.1 на GDPval и в тесте офисной работы AA Briefcase, а модель Anthropic сохраняет явное преимущество в более длительных кодинговых и терминальных бенчмарках. Наибший отрыв — на Terminal-Bench 4.0, где Fable 5.1 набрала 57,9% против 38,0% у Grok 4.7 — разрыв примерно в 20 пунктов. Fable также лидирует на CursorBench и в тесте клинических рассуждений HealthBench Professional, где GPT-5.6 Sol также обходит Grok.
Grok 4.7 получила 1,695 Elo на GDPval — бенчмарке, оценивающем модели на задачах юристов, медсестёр и финансовых аналитиков, что выше 1,605 у Grok 4.6. Это меньше, чем 1,735 у Fable 5.1, но больше, чем 1,542 у более новой GPT-6 Astra от OpenAI на том же графике. Рейтинги Elo, заимствованные из шахмат, ранжируют модели по относительным результатам, а не по процентным показателям.
В совокупности Grok 4.7 опережает GPT-5.6 Sol в пяти из семи бенчмарков, уступая только в DeepSWE и клиническом тесте.
Более крупная модель, обученная на данных SpaceX
Grok 4.7 работает на 2,1 трлн параметров — на 40% больше, чем 1,5 трлн у Grok 4.6. xAI добавила дополнительные обучающие данные SpaceX, включая телеметрию спутников Starlink и производственные записи, и сообщает, что новая модель, в отличие от предшественницы, с большей вероятностью будет тратить дополнительное время на сложные задачи и перепроверять собственные ответы.
Модель запущена в приложении Grok, Cursor, Grok Build и через API xAI без списка ожидания.
Все приведенные выше показатели получены из собственных тестов xAI, а не из независимой проверки. CursorBench — бенчмарк, лежащий в основе графика соотношения цены и производительности xAI, — создан компанией Cursor, которую SpaceX завершила приобретать в прошлом месяце. xAI тестировала Grok 4.7 против GPT-5.6 Sol, тогда как более новая GPT-6 Astra от OpenAI появляется только в сравнениях GDPval, AA Briefcase и EEBench. Независимые оценки станут первой внешней проверкой этих отрывов.

