GPT-6 Astra от OpenAI впервые набрал максимальный балл на корейском экзамене CSAT с рекордно низким расходом токенов
Ключевые выводы
- •GPT-6 Astra от OpenAI набрала максимальные 450 баллов в рейтинге 2026 CSAT LLM Solution Log, став первой моделью, добившейся этого по всем проверявшимся предметам.
- •Astra потребила 357 000 токенов — самый низкий заявленный показатель среди общедоступных моделей, что снижает затраты на инференс по сравнению с конкурентами.
- •GPT-5.6 от OpenAI заняла второе место с 448,5 балла, впереди GPT-5.4 с 448, Claude Fable 5.1 с 447,5 и Gemini 3.1 Pro с 445.
- •Эффективность модели объясняется архитектурой, которая сохраняет, сжимает и переиспользует контекст предыдущих шагов рассуждений при повторяющихся задачах.
- •Отраслевые эксперты предостерегают, что возможности ИИ следует оценивать по решению открытых реальных задач, а не только по результатам стандартизированных экзаменов.
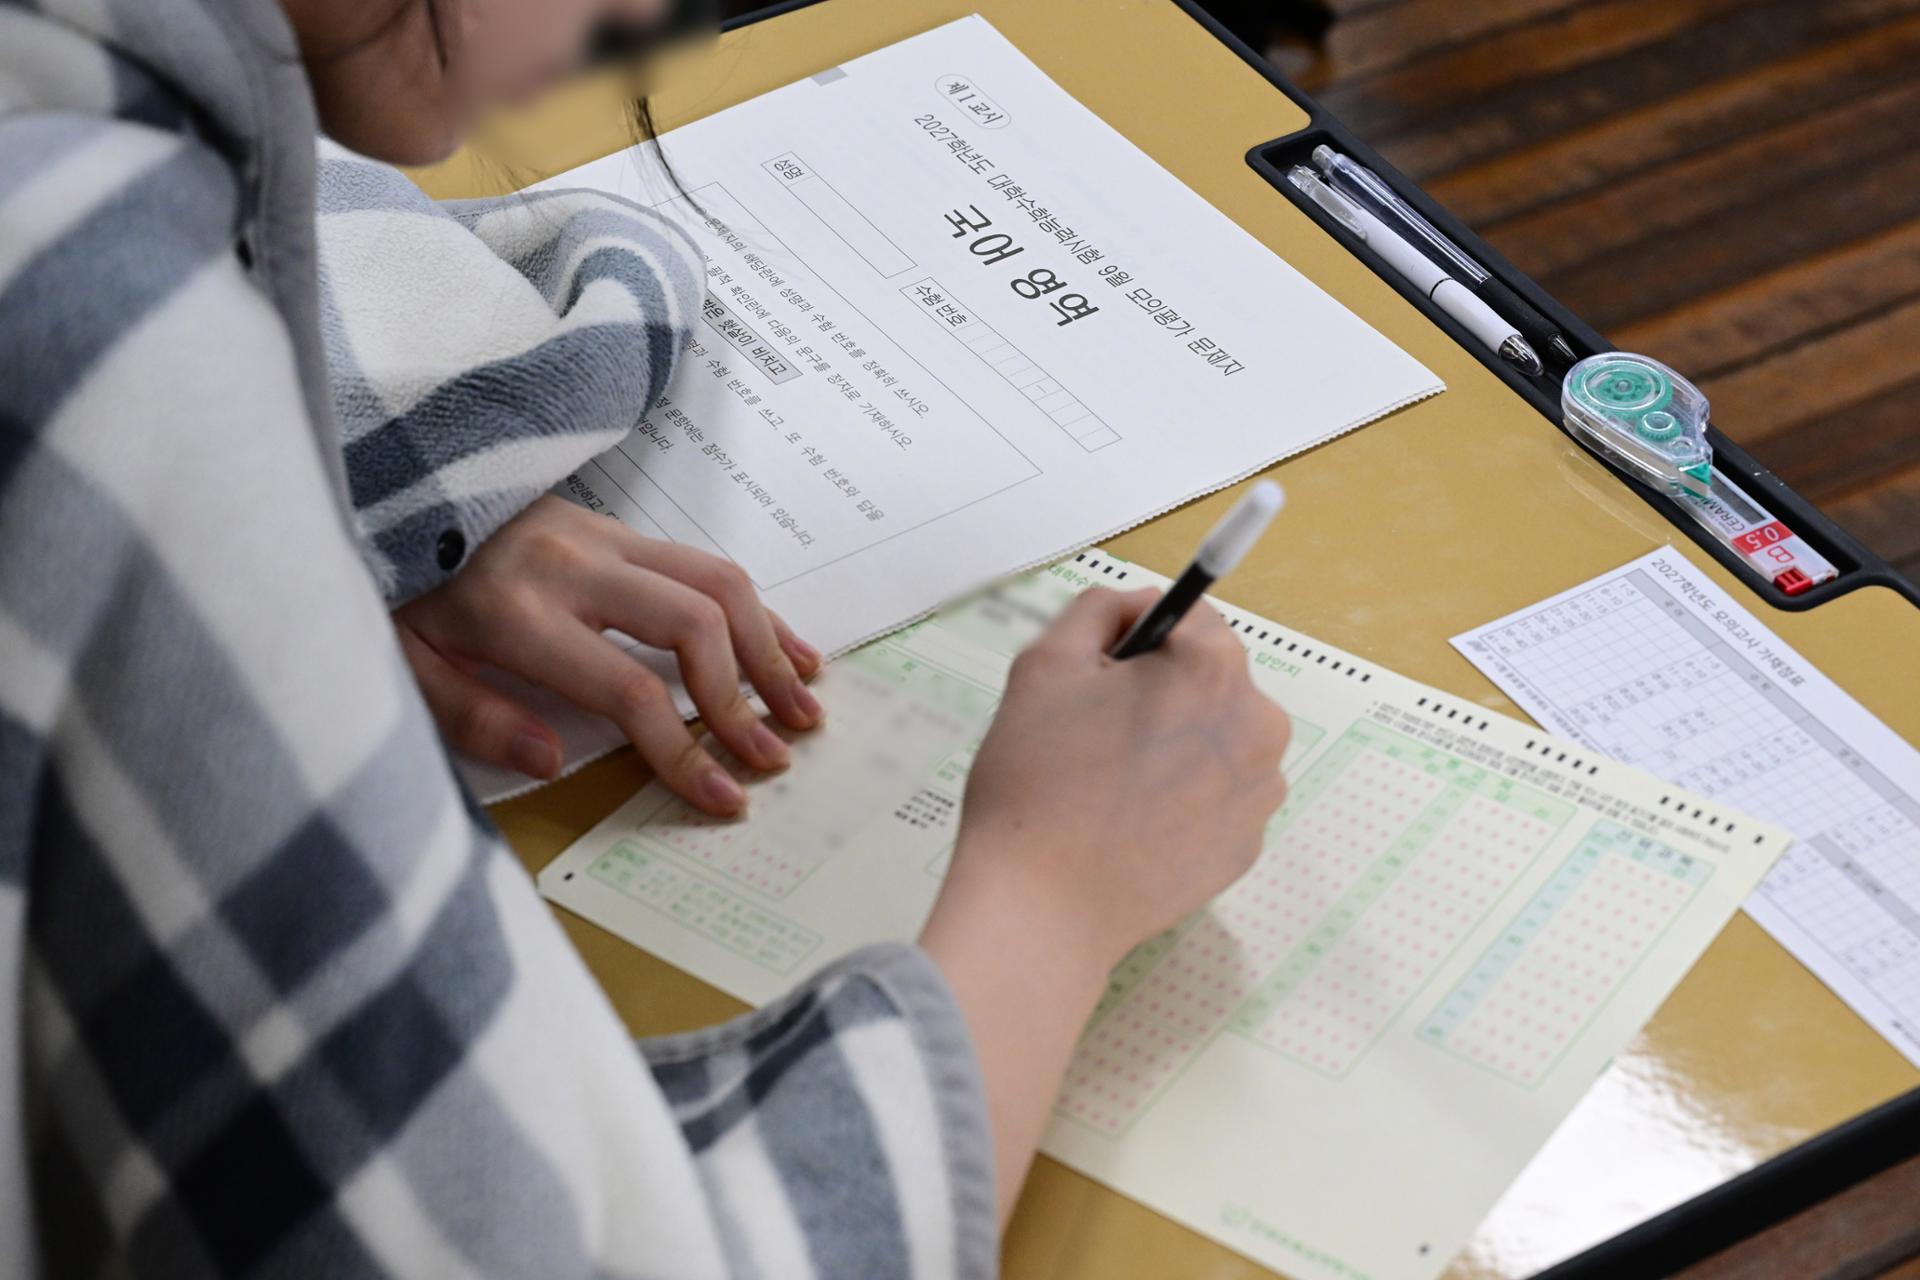
Новейшая модель искусственного интеллекта от OpenAI впервые получила максимальный балл на корейском экзамене College Scholastic Ability Test (CSAT), согласно недавно опубликованному анализу. Хотя топовые ИИ-модели ранее показывали почти идеальные результаты, данный итог привлекает особое внимание тем, что модель добилась его, потребляя меньше токенов, чем конкуренты — показатель, важный с коммерческой точки зрения, поскольку расход токенов напрямую отражается на затратах на инференс для разработчиков и компаний, использующих эти модели в больших масштабах.
Результаты, опубликованные в воскресенье на GitHub, показали, что новая модель OpenAI GPT-6 Astra стала единственной оценивавшейся моделью, набравшей максимальные 450 баллов в рейтинге 2026 CSAT LLM Solution Log. Оценка проводилась по вопросам CSAT 2026 года, охватывающим корейский язык, английский, математику, историю Кореи и четыре предмета по выбору — физику I, химию I, биологию I и «общество и культура», — без доступа в интернет. CSAT — стандартизированный экзамен, который ежегодно сдают сотни тысяч корейских студентов, — стал регулярным ориентиром для сравнения того, насколько хорошо передовые модели справляются с многоязычными и межпредметными рассуждениями в экзаменационных условиях.
Astra стала первой ИИ-моделью, добившейся максимального балла по всем проверявшимся предметам в рамках этой оценки. В феврале модель Gemini 3.1 Pro от Google получила максимальный балл, сдав лишь два предмета по выбору — химию I и биологию I, — но в более широком формате данной оценки ошиблась в вопросах по физике I и одному из предметов обществознания.
В опубликованном в воскресенье рейтинге GPT-5.6 от OpenAI заняла второе место с 448,5 балла, далее GPT-5.4 — третье место с 448 баллами. Claude Fable 5.1 от Anthropic стала четвёртой с 447,5, а Gemini 3.1 Pro — пятой с 445 баллами.
GPT-6 Astra использовала 357 000 токенов — самый низкий заявленный показатель среди общедоступных моделей. Для сравнения: GPT-5.6 использовала 429 000 токенов, а Claude Fable 5.1 — 562 000. Поскольку вопросы и ответы экзамена были общедоступны, нельзя исключить предварительное знакомство модели с ними через обучающие данные, хотя модели-конкуренты, такие как Claude Fable 5.1 и Gemini 3.1 Pro, находились в тех же условиях.
Высокая производительность модели в сочетании с низким расходом токенов объясняется архитектурой, связанной с рассуждениями, которая сохраняет контекст при выполнении повторяющихся задач. Адаптер провайдера (provider adapter harness) сжимает и переиспользует информацию из предыдущих шагов рассуждений, позволяя ИИ проходить тест способом, имитирующим подход студента с высшим баллом.
Ли Сын-хён, адъюнкт-профессор университета Ханьян, отметил, что ключ не просто в том, что модель стала умнее, а в её способности сохранять предыдущие шаги рассуждений, сжимать контекст и пересматривать свой план. «Это значит, что вместо того чтобы каждый раз думать усерднее, она продолжала с того, что уже выяснила ранее», — сказал Ли.
OpenAI назвала результат обнадёживающим, отметив, что модель добилась эффективной обработки благодаря сверхмасштабной ИИ-вычислительной инфраструктуре. Представитель OpenAI заявил, что эта веха демонстрирует: модели могут становиться мощнее, одновременно повышая производительность и снижая затраты.
Однако отраслевые эксперты предостерегли, что потенциал модели следует оценивать по её способности решать открытые задачи, а не только по баллам за стандартизированные экзамены. Представитель корейской ИИ-отрасли отметил, что будет значимее, если ИИ возьмётся за реальные рабочие задачи, где нет заранее определённых ответов. То, как ведущие модели покажут себя на более широких независимых бенчмарках — и смогут ли конкуренты сократить разрыв в эффективности, — покажет, означает ли этот результат устойчивый сдвиг в балансе стоимости и производительности.
Эта статья основана на материале Hankook Ilbo, издания-побратима The Korea Times, переведённом генеративной ИИ-системой и отредактированном The Korea Times. Первоисточник: The Korea Times.
