Grok 4.7 od xAI wyprzedza modele Anthropic i OpenAI w teście agentów prawnych za ułamek ceny
Najważniejsze informacje
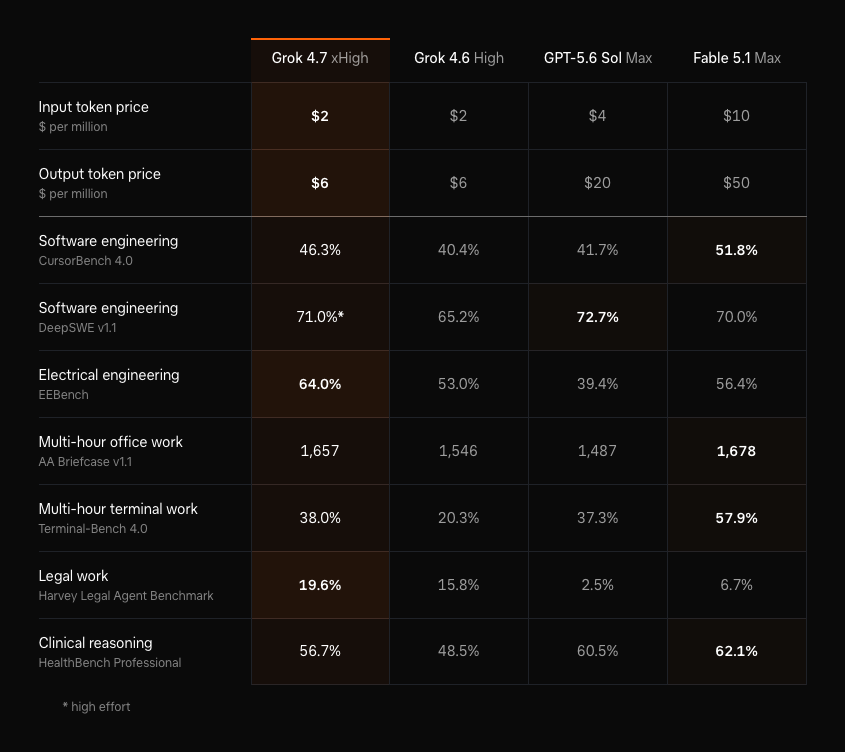
- •Grok 4.7 zdobył 19,6% w Harvey Legal Agent Benchmark, około trzykrotnie więcej niż Fable 5.1 od Anthropic z wynikiem 6,7% i prawie ośmiokrotnie więcej niż GPT-5.6 Sol od OpenAI z wynikiem 2,5%.
- •Model kosztuje 2 dolary za milion tokenów wejściowych i 6 dolarów za milion tokenów wyjściowych, co czyni jego koszt wejściowy jedną piątą 10 dolarów Fable 5.1 i połowę 4 dolarów GPT-5.6 Sol.
- •Fable 5.1 od Anthropic zachowuje znaczące przewagi w dłuższych benchmarkach programistycznych i terminalowych, wygrywając Terminal-Bench 4.0 z przewagą około 20 punktów procentowych nad Grokiem 4.7.
- •Grok 4.7 działa na 2,1 biliona parametrów, o 40% więcej niż poprzednik, i był trenowany na dodatkowych danych SpaceX, w tym telemetrii satelitów Starlink i zapisach produkcyjnych.
- •Wszystkie opublikowane wyniki benchmarków pochodzą z własnych testów xAI, a nie z niezależnej weryfikacji, a CursorBench stojący za wykresem ceny do wydajności jest tworzony przez Cursor, które SpaceX niedawno przejęło.
xAI uruchomiło w poniedziałek Groka 4.7, wprowadzając nowy flagowy model, który uzyskał wyższy wynik niż Fable 5.1 od Anthropic i GPT-5.6 Sol od OpenAI w teście agentów prawnych, pobierając przy tym jedną piątą ceny Fable 5.1 za token wejściowy.
Według zapowiedzi wydania xAI Grok 4.7 zdobył 19,6% w Harvey Legal Agent Benchmark, gdzie Fable 5.1 osiągnął 6,7%, a GPT-5.6 Sol — 2,5%. To oznacza, że Grok 4.7 ma wynik około trzykrotnie wyższy niż model Anthropic i blisko ośmiokrotnie wyższy niż Sol. Cryptopolitan informowało w zeszłym miesiącu, że poprzedni model firmy, Grok 4.6, już wyprzedzał tę dwójkę z wynikiem 15,8%. Test Harvey jest prowadzony przez firmę zajmującą się technologiami prawniczymi, Harvey, i ocenia modele w wieloetapowej pracy prawniczej — jednej z dziedzin zawodowych, w których wdrażanie agentowych systemów AI śledzi się najuważniej.
Praca prawnicza wyróżnia się jako jedna z niewielu dziedzin, w których Grok 4.7 wprost przewyższa obu konkurentów. Model pokonuje też Fable 5.1 w teście inżynierii elektrycznej EEBench i minimalnie go wyprzedza w benchmarku programistycznym DeepSWE.
Cennik i stosunek ceny do wydajności
Grok 4.7 kosztuje 2 dolary za milion tokenów wejściowych i 6 dolarów za milion tokenów wyjściowych — te same stawki co Grok 4.6. Ta cena wejściowa to połowa 4 dolarów GPT-5.6 Sol i jedna piąta 10 dolarów Fable 5.1. Po stronie wyjściowej Grok 4.7 pobiera 6 dolarów wobec 20 dolarów dla Sola i 50 dolarów dla Fable, czyli około jednej ósmej stawki Anthropic. Stki za milion tokenów to standardowy sposób rozliczania dostawców API — tokeny wejściowe obejmują to, co model czyta, a wyjściowe to, co pisze — więc te cenniki są wartościami, które deweloperzy ważą przy wyborze między modelami granicznymi.
xAI zestawiło również wyniki CursorBench 4.0 ze średnim kosztem na ukończone zadanie i twierdzi, że model znajduje się na granicy relacji ceny do wydajności. Grok 4.7 osiąga około 46% na tym wykresie przy około 6 dolarach za zadanie, podczas gdy Claude Opus 5 potrzebuje niemal dwukrotnie większych wydatków na podobny rezultat. Fable 5.1 wypada lepiej przy wyższych budżetach, wspinając się do 51,8% przy około 17 dolarach za zadanie.
Elon Musk opisał wydanie jako „silne połączenie inteligencji, szybkości i niskich kosztów” w poście na X.
Anthropic zachowuje przewagę w testach terminalowych i programistycznych
Grok 4.7 zajął drugie miejsce za Fable 5.1 w GDPval oraz w teście pracy biurowej AA Briefcase, a model Anthropic zachowuje wyraźną przewagę w dłuższych benchmarkach programistycznych i terminalowych. Największa różnica występuje w Terminal-Bench 4.0, gdzie Fable 5.1 zdobył 57,9% wobec 38,0% Groka 4.7 — przewaga około 20 punktów. Fable prowadzi także w CursorBench oraz w HealthBench Professional w rozumowaniu klinicznym, gdzie Groka pokonuje również GPT-5.6 Sol.
Grok 4.7 uzyskał 1 695 Elo w GDPval — benchmarku mierzącym modele w zadaniach wykonywanych przez prawników, pielęgniarki i analityków finansowych — wobec 1 605 Groka 4.6. To mniej niż 1 735 Fable 5.1, ale więcej niż 1 542 zanotowane przez nowszy GPT-6 Astra od OpenAI na tym samym wykresie. Rankingi Elo, zaczerpnięte z szachów, porządkują modele według względnych wyników, a nie surowych procentów.
Łącznie Grok 4.7 jest przed GPT-5.6 Sol w pięciu z siedmiu benchmarków, przegrywając tylko w DeepSWE i teście klinicznym.
Większy model trenowany na danych SpaceX
Grok 4.7 działa na 2,1 biliona parametrów, o 40% więcej niż 1,5 biliona napędzającego Groka 4.6. xAI dodało uzupełniające dane treningowe ze SpaceX, w tym telemetrię satelitów Starlink i zapisy produkcyjne, i mówi, że nowy model jest także skłonny niż poprzednik poświęcać więcej czasu na trudne problemy i weryfikować własne odpowiedzi.
Model udostępniono w aplikacji Grok, Cursor, Grok Build oraz w API xAI, bez listy oczekujących.
Wszystkie powyższe liczby pochodzą z własnych testów xAI, a nie z niezależnej weryfikacji. CursorBench — benchmark stojący za wykresem ceny do wydajności xAI — jest tworzony przez Cursor, które SpaceX zakończyło przejmować w zeszłym miesiącu. xAI porównywało Groka 4.7 z GPT-5.6 Sol, podczas gdy nowszy G-6 Astra od OpenAI pojawia się tylko w porównaniach GDPval, AA Briefcase i EEBench. Oceny niezależne będą pierwszą zewnętrzną weryfikacją tych przewag.

