ChatGPT Images 2.5 kontra Nano Banana 2: porównanie w sześciu kategoriach
Najważniejsze informacje
- •ChatGPT Images 2.5 zrównał się z Nano Banana 2, wygrywając po trzy kategorie porównania.
- •OpenAI twierdzi, że nowy model może zmniejszyć opóźnienia generowania obrazów nawet o 50% względem Images 2.0.
- •Test wykazał, że ChatGPT Images 2.5 nie prezentował już żółtej dominanty ani silnego nadmiernego wyostrzania znanych z wcześniejszych generacji.
- •Nano Banana 2 wygrał test z dużą ilością tekstu oraz oś czasu Bitcoina po tym, jak ChatGPT Images 2.5 popełnił błędy ortograficzne i dotyczące dat.
- •OpenAI dodało funkcje Sketch, udostępnianie promptów, komentarze dotyczące regionów obrazu, szablony formatów oraz nowe poziomy jakości API high i max.
OpenAI uruchomiło ChatGPT Images 2.5 8 września, obiecując ostrzejsze detale, bogatsze tekstury, bardziej naturalne oświetlenie, precyzyjniejszą edycję oraz nawet o 50% niższe opóźnienia generowania obrazów niż w Images 2.0.
W porównaniu obejmującym sześć kategorii Nano Banana 2 wygrał trzy testy, a ChatGPT Images 2.5 pozostał zwycięzcą w trzech pozostałych. O wyniku decydowały nie tyle oczywiste różnice jakości, ile niewielkie, możliwe do zweryfikowania błędy, w tym literówka i nieprawidłowa data w infografice opartej na badaniach.
OpenAI twierdzi, że opóźnienia spadły nawet o 50% w porównaniu z Images 2.0. Firma dodała również dwa modele API: GPT-Image-2.5 Flare, będący szybkim ustawieniem domyślnym, oraz GPT-Image-2.5 Sunburst, zaprojektowany z myślą o najwyższej precyzji edycji.
Porównanie jest kontynuacją wcześniejszego testu opublikowanego w maju, w którym GPT Image 2 i Nano Banana 2 wymieniały się zwycięstwami w ośmiu kategoriach. GPT Image 2 wygrał więcej kategorii, ale przy promptach zawierających wiele jednoczesnych ograniczeń generował charakterystyczny artefakt nadmiernego wyostrzenia. Pojawiło się więc pytanie, czy OpenAI zdoła naprawić ten problem w kolejnym modelu.
W tej rundzie ten sam oceniający wykorzystał sześć kategorii przeniesionych z wcześniejszych testów lub na ich podstawie zmodyfikowanych, a obu modelom przekazał te same prompty. Modelem Google był Nano Banana 2, czyli nazwa Gemini 3.1 Flash Image, a nie wolniejszy i bardziej metodyczny Nano Banana Pro. Test porównywał więc nowy, szybki model OpenAI skoncentrowany na precyzji z analogiczną ofertą Google.
Co zmieniło się w GPT-Image-2.5
Modele obrazowe OpenAI były wcześniej kojarzone z charakterystycznymi wadami. Model stojący za pierwotnym GPT Image 1 nabrał trwałej, ciepłej żółtej dominanty, którą użytkownicy nazwali „filtrem moczu”. OpenAI nigdy w pełni nie wyjaśniło ani nie naprawiło tego zabarwienia.
GPT Image 2 zastąpił ten problem innym: prompty zawierające zbyt wiele nałożonych na siebie ograniczeń mogły prowadzić do mocno przeostrzonych obrazów pełnych chropowatych, nadmiernie przetworzonych artefaktów.
Żaden z tych problemów nie pojawił się w tym teście. Obrazy wygenerowane przez ChatGPT Images 2.5 zachowywały równowagę kolorów i szczegółowość nawet przy pełnej złożoności promptów. Żółta dominanta i nadmierne wyostrzanie widoczne w dwóch wcześniejszych generacjach były nieobecne. Poprawa była szczególnie widoczna w testach steampunkowym i portretowym, które dały najbardziej spójne fotograficznie obrazy ChatGPT spośród trzech testowanych generacji.
OpenAI wprowadziło również funkcje usprawniające pracę, których nie da się uchwycić w prostym porównaniu obrazów. Sketch pozwala narysować bezpośrednio w ChatGPT przybliżony układ jako punkt odniesienia dla generowania. Inne dodatki to udostępnianie promptów, komentarze dotyczące konkretnych obszarów obrazu oraz szablony formatów plakatów i materiałów merchandisingowych. W API poziomy jakości obejmują teraz ustawienia od low po nowe high i max, wykraczając poza najwyższy poziom dostępny w Images 2.0.
Tak oba modele wypadły w sześciu kategoriach.
Gęstość napisów: scena Kellerman’s Hardware
Pierwszy test przedstawiał surowe skrzyżowanie o godzinie 2 w nocy, na którym niemal każda powierzchnia zawierała czytelny tekst: wyblakły szyld, graffiti malowane sprayem, winylowe napisy na witrynach, podarty plakat koncertowy, krawężnik z szablonowym napisem oraz oblepiony naklejkami automat telefoniczny.
Nano Banana 2 wygenerował niemal cały tekst w czysty sposób. Jego głównym błędem była naklejka na automacie telefonicznym, która powtarzała własną treść w zniekształconej formie — drobna wada, którą łatwo przeoczyć.
ChatGPT Images 2.5 uwzględnił szczegół pominięty przez Nano Banana 2: latarnię pokrytą nakładającymi się, przypiętymi zszywkami ulotkami, podartymi i zniszczonymi zgodnie z opisem w prompcie. Jednak jego tag street-artowy wyglądał jak „STILLL HERE”, z dodatkową literą L. Apostrof w napisie „KELLERMAN’S” na wyblakłym szyldzie również zniknął albo był nieczytelny.
Choć OpenAI stworzyło ogólnie bardziej realistyczną scenę, popełniło dwa niezależne błędy czytelności w teście skoncentrowanym na precyzyjnym renderowaniu tekstu. Kategorię wygrał Nano Banana 2.
Zwycięzca: Nano Banana 2
Świadomość przestrzenna: steampunkowa wieża zegarowa
Ten test kompozycji z lotu ptaka wymagał sceny z pięcioma płaszczyznami głębi i ogromną wieżą zegarową. Jej tarcze miały pokazywać różne godziny za pomocą czytelnych cyfr rzymskich, a sześć dodatkowych elementów tekstowych miało być rozmieszczonych od pierwszego planu po tło.
ChatGPT Images 2.5 stworzył zdecydowanie bardziej atmosferyczny obraz. Z dachów wyraźnie unosiła się para, przez środkowy plan przepływała rzeka, a zakres tonalny był bogatszy na wszystkich pięciu płaszczyznach głębi. Tekst również był łatwiejszy do odczytania.
Atmosfera w Nano Banana 2 była bardziej płaska. Na obu widocznych tarczach znalazły się czytelne cyfry rzymskie — XII, III, VI i IX — ale wskazówki były ustawione podobnie na obu zegarach, wbrew prośbie o pokazanie różnych godzin.
ChatGPT Images 2.5 wygrał dzięki wierniejszemu wykonaniu instrukcji bez utraty realizmu.
Zwycięzca: ChatGPT Images 2.5
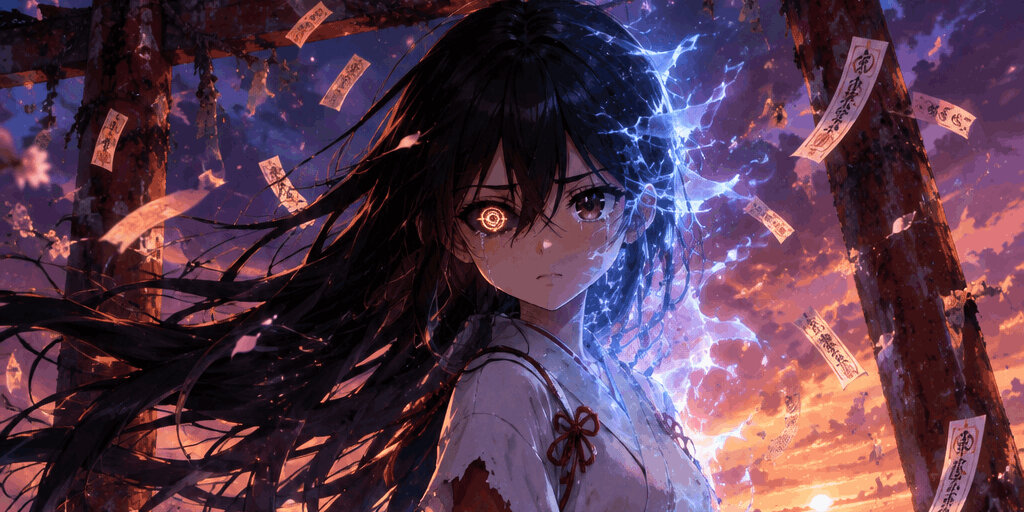
Ilustracja: anime’owa medium duchowa
Prompt wymagał kluczowej ilustracji w stylu Studio Ufotable, przedstawiającej dziewczynę przemieniającą się w energię duchową przy bramie torii, z dziewięcioogonowym lisem kitsune i zmierzchowym niebem namalowanym w stylu kojarzonym z Makoto Shinkai.
ChatGPT Images 2.5 stworzył najlepsze niebo w całej serii testów. Obraz zawierał widoczną tarczę słońca, odbicie w wodzie i sylwetkę gór, które uzasadniały porównanie do Shinkaia. Dobrze wypadły również asymetryczne oczy bohaterki.
Model mniej dosłownie potraktował instrukcję, zgodnie z którą dziewczyna miała „rozpuszczać się w energii”. Zinterpretował ją jako efekt elektrycznych trzasków przebiegających przez włosy, zamiast opisanego w prompcie płynnego, półprzezroczystego rozpadu. Delikatna niebiesko-biała smuga energii w Nano Banana 2 była bliższa tej konkretnej instrukcji.
Żaden z modeli nie stworzył przekonującego dziewięcioogonowego lisa. ChatGPT Images 2.5 mimo to wygrał dzięki ogólnemu oddziaływaniu wizualnemu.
Zwycięzca: ChatGPT Images 2.5
Realizm: architektka na dachu
Ten filmowy portret zawierał wiele niezależnych ograniczeń: beżowy trencz, okrągłe okulary, plany trzymane konkretnie w lewej dłoni, oświetlenie złotej godziny, małą głębię ostrości i ziarno filmu.
ChatGPT Images 2.5 stworzył efektowne oświetlenie — tarcza słońca była widoczna bezpośrednio za bohaterką, a mikrotekstura skóry została oddana bardzo dobrze. Skóra była zbyt gładka, ale otoczenie wyglądało bardzo realistycznie, przypominając zdjęcie wykonane aparatem analogowym.
Dodanie instrukcji, które zwykle obniżyłyby jakość fotograficzną, nieoczekiwanie zwiększyło realizm obrazu. W jednej z generacji użyto słów kluczowych takich jak „realistic, highlights, crushed shadows, uneven flash, blown out skin tones, candid moment, shot on a phone camera”.
Nano Banana 2 zachował pełniejszą kompozycję i umieścił plany w prawej ręce bohaterki zamiast w wymaganej lewej. Dodał jednak czytelny opis na planie: „PROJECT: 124 DUANE ST”, szczegół pomijany w większości generacji.
Nano Banana 2 wygrał porównanie pojedynczych ujęć, podczas gdy ChatGPT Images 2.5 został oceniony jako lepszy przy wielokrotnych iteracjach.
Zwycięzca: Nano Banana 2 dla pojedynczego ujęcia; ChatGPT Images 2.5 dla wielokrotnych iteracji
Badania agentowe: oś czasu Bitcoina
Obie platformy potrafią zbadać temat przed wygenerowaniem obrazu. Test wymagał panoramicznej osi czasu historii Bitcoina w stylu rysunku dziecięcego, z rygorystycznym wymogiem poprawności faktograficznej. Była to najważniejsza kategoria porównania i właśnie w niej pojawiła się największa różnica między modelami.
ChatGPT Images 2.5 wygenerował przejrzystą, dwurzędową infografikę zawierającą wiele konkretnych dat, ale jedna z nich była błędna. Model wskazał 2023 jako rok zatwierdzenia funduszy ETF na Bitcoina w Stanach Zjednoczonych. Amerykańska Komisja Papierów Wartościowych i Giełd zatwierdziła pierwsze spotowe ETF-y na Bitcoina 10 stycznia 2024 roku, czyli pełny rok później. Źródło zauważyło, że rozbieżność może wynikać z kwestii interpretacyjnej, ponieważ w tamtym roku zatwierdzono ETF-y oparte na kontraktach futures.
Nano Banana 2 stworzył mniej uporządkowaną oś czasu przedstawiającą podobne wydarzenia. W przypadku zatwierdzenia ETF-ów i czwartego halvingu użył zakresu „2023–2024”, zamiast wskazywać jeden nieprawidłowy rok. W rezultacie żadna z podanych przez niego dat nie była technicznie fałszywa.
Nano Banana 2 wygrał, ponieważ stanowczo podana błędna data ma większe znaczenie w teście zaprojektowanym do oceny, czy „rozumowanie agentowe” prowadzi do dokładnych wyników badań.
Zwycięzca: Nano Banana 2
Abstrakcyjne pojęcia: prompt z wymyślonymi słowami
Ostatni prompt składał się niemal wyłącznie z wymyślonych terminów: „A woman eating shmfiyxl in Lyxin. Next to her, her Lymglsushing plays Lakishkark.” Danie, miejsce, towarzysz i aktywność nie miały definicji słownikowych, więc każdy model musiał wymyślić ich znaczenie i zdecydować, jak je przedstawić.
ChatGPT Images 2.5 umieścił nonsensowne słowa bezpośrednio w scenie jako widoczny tekst. „Lyxin” pojawiło się na neonowym szyldzie nad elegancką, futurystyczną restauracją, a „Lakishkark” wydrukowano na pudełku gry planszowej, w którą grał kosmiczny towarzysz kobiety. Przekształcając wymyślone terminy w czytelne napisy, model nadał im konkretną formę zamiast pozostawiać je abstrakcyjnymi.
Nano Banana 2 obrał inną drogę. Wygenerował ciepłą, osadzoną kulturowo scenę z gwatemalskim stoiskiem targowym, kobietą w tradycyjnym huipilu oraz istotą przypominającą orka, grającą na hybrydowym instrumencie strunowo-dętym. Zinterpretował słowo „plays” jako granie muzyki, a nie granie w grę, co było innym, lecz równie uzasadnionym odczytaniem promptu.
Na obrazie nie znalazło się jednak nic, co konkretnie odnosiłoby się do „Lyxin” lub „Lakishkark”, a żadne z wymyślonych słów nie pojawiło się jako widoczny tekst. ChatGPT Images 2.5 wygrał, ponieważ przekształcenie niezdefiniowanych pojęć w czytelne etykiety było bardziej dosłowną odpowiedzią na prompt, który nie dostarczał ustalonych znaczeń.
Zwycięzca: ChatGPT Images 2.5
Werdykt
Nano Banana 2 wygrał trzy z sześciu kategorii, więc porównanie zakończyło się praktycznie remisem. Wynik zależy od oczekiwań użytkownika i sposobu korzystania z modelu.
ChatGPT Images 2.5 naprawił problem nadmiernego wyostrzania, który dotykał jego poprzednika. Jego ilustracja była prawdopodobnie najbardziej efektownym wizualnie pojedynczym obrazem wygenerowanym przez którykolwiek z modeli w dwóch pełnych rundach testów.
Wybór modelu zależy zatem od zadania: obrazy bogate w tekst i oparte na badaniach wymagają większej wagi przywiązywanej do dokładnej czytelności i weryfikacji faktów, podczas gdy ilustracje i procesy oparte na wielokrotnym generowaniu uwypuklają inne mocne strony pokazane w tym teście. Porównanie nie wyłania uniwersalnego zwycięzcy, ale pokazuje, dlaczego ocena modeli obrazowych wymaga czegoś więcej niż osądzania pojedynczego obrazu wyłącznie po jego atrakcyjności wizualnej.
Główna różnica nie dotyczyła ogólnej jakości, lecz serii niewielkich, możliwych do zweryfikowania szczegółów: błędu ortograficznego w scenie pełnej napisów, nieprawidłowego roku w infografice opartej na badaniach oraz innych wąskich uchybień w wykonywaniu instrukcji. Pod względem ogólnej estetyki i jakości obrazu oba modele były zasadniczo porównywalne.

