xAI's Grok 4.7 scoort hoger dan Anthropic- en OpenAI-modellen op legal-agent-benchmark tegen een fractie van de prijs
Belangrijkste punten
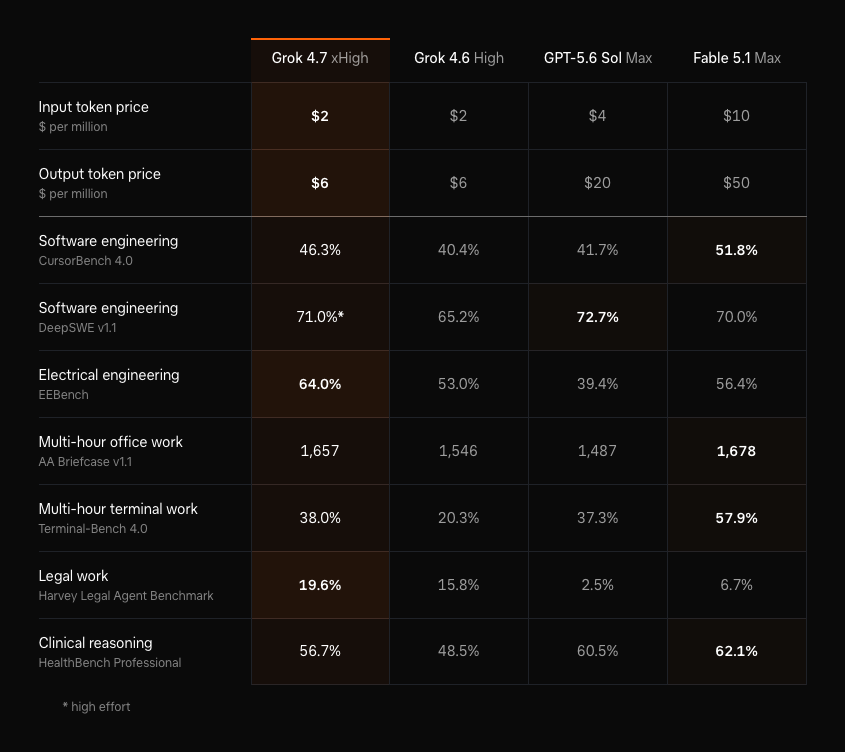
- •Grok 4.7 scoorde 19,6% op de Harvey Legal Agent Benchmark, ongeveer drie keer Anthropic's Fable 5.1 met 6,7% en bijna acht keer OpenAI's GPT-5.6 Sol met 2,5%.
- •Het model kost $2 per miljoen inputtokens en $6 per miljoen outputtokens, waarmee de inputprijs een vijfde is van de $10 van Fable 5.1 en de helft van de $4 van GPT-5.6 Sol.
- •Anthropic's Fable 5.1 behoudt aanzienlijke voorsprongen op langere coding- en terminalbenchmarks en wint Terminal-Bench 4.0 met ongeveer 20 procentpunten verschil van Grok 4.7.
- •Grok 4.7 draait op 2,1 biljoen parameters, 40% meer dan zijn voorganger, en is getraind met aanvullende SpaceX-data, waaronder Starlink-satelliettelemetrie en productiegegevens.
- •Alle gepubliceerde benchmarkcijfers komen uit xAI's eigen tests in plaats van onafhankelijke verificatie, en de CursorBench achter de prijs-prestatiegrafiek is gemaakt door Cursor, dat SpaceX recent overnam.
xAI lanceerde maandag Grok 4.7, een nieuw vlaggenschipmodel dat hoger scoorde dan Anthropic's Fable 5.1 en OpenAI's GPT-5.6 Sol op een legal-agent-benchmark, terwijl het per inputtoken een vijfde van de prijs van Fable 5.1 rekent.
Volgens de aankondiging van xAI scoorde Grok 4.7 19,6% op de Harvey Legal Agent Benchmark, waar Fable 5.1 tot 6,7% kwam en GPT-5.6 Sol tot 2,5%. Daarmee scoort Grok 4.7 ongeveer drie keer zo hoog als Anthropic's model en bijna acht keer zo hoog als Sol. Cryptopolitan meldde vorige maand dat het eerdere model van het bedrijf, Grok 4.6, datzelfde duo al voor was met 15,8%. De Harvey-benchmark wordt beheerd door legaltech-bedrijf Harvey en beoordeelt modellen op meerstaps juridisch werk, een van de professionele domeinen waarin de invoering van agentische AI het nauwkeurigst wordt gevolgd.
Juridisch werk is een van de weinige domeinen waarin Grok 4.7 beide concurrenten ronduit overtreft. Het model passeert Fable 5.1 ook op de EEBench elektrotechniektest en komt er net bovenuit op de DeepSWE-codingbenchmark.
Prijzen en prijs-prestatieverhouding
Grok 4.7 kost $2 per miljoen inputtokens en $6 per miljoen outputtokens — dezelfde tarieven als Grok 4.6. Die inputprijs is de helft van de $4 van GPT-5.6 Sol en een vijfde van de $10 van Fable 5.1. Aan de outputkant rekent Grok 4.7 $6, tegenover $20 voor Sol en $50 voor Fable, ofwel ongeveer een achtste van het tarief van Anthropic. Tarieven per miljoen tokens zijn de standaardier waarop API-aanbieders factureren — inputtokens dekken wat een model leest, outputtokens wat het schrijft — dus deze listprijzen zijn de cijfers die ontwikkelaars afwegen bij het kiezen tussen frontiërmodellen.
xAI zette de CursorBench 4.0-scores ook af tegen de gemiddelde kosten per voltooide taak en stelt dat het model op de prijs-prestatiefrontlinie zit. Grok 4.7 haalt ongeveer 46% op die grafiek tegenover ongeveer $6 per taak, terwijl Claude Opus 5 bijna het dubbele bedrag nodig heeft voor een vergelijkbaar resultaat. Fable 5.1 presteert beter bij hogere budgetten en klimt tot 51,8% bij ongeveer $17 per taak.
Elon Musk omschreef de release op X als "een sterke combinatie van intelligentie, snelheid & lage kosten".
Anthropic behoudt de voorsprong op terminal- en codingtests
Grok 4.7 werd tweede achter Fable 5.1 op GDPval en op de AA Briefcase-kantoortest, en Anthropic's model behoudt een duidelijke voorsprong op langere coding- en terminalbenchmarks. De grootste marge zit op Terminal-Bench 4.0, waar Fable 5.1 tot 57,9% kwam tegenover 38,0% voor Grok 4.7 — een gat van ongeveer 20 punten. Fable leidt ook op CursorBench en op HealthBench Professional klinisch redeneren, waar GPT-5.6 Sol Grok eveneens verslaat.
Grok 4.7 behaalde 1.695 Elo op GDPval, een benchmark die modellen meet op taken van advocaten, verpleegkundigen en financieel analisten, een stijging van 1.605 bij Grok 4.6. Dat ligt onder de 1.735 van Fable 5.1, maar boven de 1.542 die OpenAI's nieuwere GPT-6 Astra op dezelfde grafiek noteerde. Elo-ratings, afgeleid van het schaakspel, rangschikken modellen op relatieve resultaten in plaats van ruwe percentages.
Al met al zit Grok 4.7 op vijf van de zeven benchmarks boven GPT-5.6 Sol en verliest het alleen op DeepSWE en de klinische test.
Een groter model getraind met SpaceX-data
Grok 4.7 draait op 2,1 biljoen parameters, 40% meer dan de 1,5 biljoen van Grok 4.6. xAI heeft aanvullende SpaceX-trainingsdata toegevoegd, waaronder Starlink-satelliettelemetrie en productiegegevens, en zegt dat het nieuwe model ook eerder dan zijn voorganger extra tijd besteedt aan lastige problemen en zijn eigen antwoorden dubbel controleert.
Het model is gelanceerd in de Grok-app, Cursor, Grok Build en de xAI, zonder wachtlijst.
Alle bovenstaande cijfers komen uit xAI's eigen tests in plaats van onafhankelijke verificatie. CursorBench, de benchmark achter xAI's prijs-prestatiegrafiek, is gemaakt door Cursor, dat SpaceX vorige maand definitief overnam. xAI heeft Grok 4.7 vergeleken met GPT-5.6, terwijl OpenAI's nieuwere GPT-6 Astra alleen in de GDPval-, AA Briefcase- en EEBench-vergelijkingen verschijnt. Evaluaties door derden vormen de eerste externe toets van die marges.

