Ethereum-medeoprichter Vitalik Buterin zegt dat lokale AI privacy kan beschermen zonder snelheid te verliezen, maar wallets hebben nog steeds harde controles nodig
Belangrijkste punten
- •Buterins bericht markeert een verschuiving ten opzichte van zijn standpunt in april: lokale laptopmodellen kunnen nu dienen als primaire interface voor een groter deel van de taken in plaats van alleen nauw begrensd werk.
- •Benchmarks op zijn Strix Halo-laptop toonden invoerverwerkingssnelheden van 109,82 tot 373,22 tokens per seconde en uitvoergeneratie van 18,42 tot 33,37 tokens per seconde over 10 workloads.
- •Alibaba's open-weight Qwen3.8-Flash-Next is een mixture-of-experts-model met 125 miljard parameters dat per token slechts 6 miljard activeert, en het versloeg het grotere Qwen3.7-Plus op 8 van 14 benchmarks.
- •Standaard capability-benchmarks meten geen bestendigheid tegen prompt-injectie, walletautorisatie of de juistheid van autonome financiële handelingen, waardoor AI-controle over crypto-activa onopgelost blijft.
- •Voorgestelde waarborgen omvatten Buterins 2-van-2-goedkeuringsregel met mens plus model voor risicovolle transacties, door software gedefinieerde bestedingslimieten, de door de Ethereum Foundation gefinancierde on-device Steward-wallet en het conceptrapport EIP-7906 voor post-transactie-statusasserties.
Ethereum-medeoprichter Vitalik Buterin zegt dat kunstmatige intelligentie op laptops een praktisch kantelpunt nadert — al moet wallet-software nog een veel hogere drempel over voorden een AI kan worden vertrouwd met de controle over crypto-activa.
In een bericht van 17 september zei Buterin dat Qwen 3.8 Flash en recente verbeteringen aan llama.cpp — het open-sourceproject voor het draaien van grote taalmodellen direct op lokale hardware — lokale modellen dichtbij hebben gebracht bij het uitvoeren van een "groot deel" van de taken op zijn Strix Halo-laptop. Voor geavanceerder werk beschreef hij een lokaal model dat verzoeken coördineert naar sterkere externe systemen, terwijl het de volledige persoonlijke context van de gebruiker achterhoudt.
Een benchmarkafbeelding bij het bericht toonde 10 workloads. De gerapporteerde invoerverwerkingssnelheden varieerden van 109,82 tot 373,22 tokens per seconde, terwijl de uitvoergeneratie varieerde van 18,42 tot 33,37 tokens per seconde. Deze cijfers ondersteunen een praktische claim over responsiviteit op één high-end laptop, maar laten de vraag naar modeloordeel, bestendigheid tegen kwaadaardige instructies en transactie-autorisatie onbeantwoord.
Lokale inferentie kan de privacy verbeteren, terwijl de macht om geld te verplaatsen achter afzonderlijke, afdwingbare controles blijft.
Wat er veranderde tussen april en september
In een verslag van april over zijn lokale AI-opzet beschreef Buterin een beperktere rol voor laptopmodellen. Hij schreef dat Qwen3.5:35B begrensde taken en vertrouwd programmeerwerk aankon, terwijl geavanceerde onafhankelijke agenten die door konden werken aan een codebase praktisch gezien buiten het bereik van laptops bleven. Moeilijker programmeer- en denkwerk vereiste nog steeds sterkere externe modellen.
Het bericht van september verschuift zijn inschatting van waar de praktische grens ligt. Een lokaal model lijkt niet langer beperkt tot transcriptie,envattingen of ander nauw begrensd werk. In de nieuwere beschrijving kan het de hoofdinterface worden voor een groter deel van de activiteiten en zelf beslissen wanneer een extern model nodig is. Een externe dienst ontvangt alleen de vraag of context die het lokale model selecteert — niet elk bestand, bericht en walletdetail dat nodig is om de bredere situatie van de gebruiker te begrijpen. Het lokale systeem wordt zowel een informatiepoortwachter als een assistent.
April en september betroffen verschillende modelgeneraties en verschillende taken. Het bericht van september geeft tokenaantallen en doorvoer, maar laat de inhoud van de prompts, kwantiseringskeuzes en de volledige runtimeconfiguratie weg.
Qwen3.8-Flash-Next, uitgebracht door het Qwen-team van Alibaba, is een open-weight multimodaal mixture-of-experts-model. Het hoofdmodel heeft 125 miljard parameters, plus nog eens 51 miljard in n-gram-embeddingtabellen, terwijl er per token 6 miljard parameters worden geactiveerd. Open-weight-distributie betekent dat het model volledig op de eigen machine van de gebruiker kan worden gedownload en uitgevoerd — de regeling die lokale, privé-inferentie mogelijk maakt. De officiële repository documenteert lokale tekst- en visie-inferentie via llama.cpp met gekwantiseerde GGUF-builds.
Het activeren van een fractie van het model per token verlaagt de rekenlast. De gebruiker heeft nog steeds genoeg geheugen nodig voor de gekozen build en context, en de officiële materialen geven geen enkele hardwareminimumdrempel die geldt over kwantiseringsniveaus en workloads heen.
Capability-benchmarks laten walletautoriteit onopgelost
Qwen's technisch rapport beoordeelt het basismodel op 14 benchmarks die algemene kennis, wiskunde, wetenschap, redeneren, programmeren en meertalig begrip bestrijken. Het Qwen-team meldde dat Flash-Next het grotere Qwen3.7-Plus-basismodel versloeg op acht van die tests, met minder geactiveerde parameters en minder rekenkracht voor training.
Het rapport behandelt modelcapaciteit, efficiëntie en trainingsstabiliteit. Bestendigheid tegen prompt-injectie, beleidshandhaving, walletautorisatie en de juistheid van autonome financiële handelingen vallen buiten die benchmarkset.
Een assistent kan privé een transactie uitleggen, calldata voorbereiden of een route voorstellen. Een signer kan een onomkeerbaar verzoek indienen dat activa overdraagt of een ander contract toestemming geeft om ze te verplaatsen. Beter redeneren vermindert sommige fouten, maar een kwaadaardige instructie die verborgen zit in een website, bericht of transactiebeschrijving kan het plan van het model nog steeds omleiden.
Het Ethereum-ecosysteem test al een on-device-vers van het assistentconcept. In zijn toewijzingsupdate voor het tweede kwartaal vermeldde de Ethereum Foundation Steward, een volledig lokale macOS smart-account wallet waarvan de light client en AI-assistent op het apparaat zelf moeten draaien. De openbaarmaking legt financiering en projectomvang vast, maar laat productie-uitrol, onafhankelijke auditstatus en autonome transactieautoriteit onbevestigd. Die open punten zijn de markeringen om in de gaten te houden nu on-device wallet-assistenten van financieringsaankondigingen naar kant-en-klare software gaan.
Buterins walletadvies uit april plaatste die autoriteit buiten het taalmodel. Hij beschreef een firewall met menselijke bevestiging voor risicovolle handelingen, deterministische limieten op transactiebedragen, calldata en transactieaantallen, en een 2-van-2-regel met mens plus model. Het model kan een oplichtingspatroon herkennen dat een afgeleid persoon mist, terwijl een persoon een handeling kan afwijzen nadat kwaadaardige inhoud het model heeft gemanipuleerd. Het vereisen van beide goedkeuringen voor risicovolle transacties voorkomt dat één van de twee stilletjes de enige vertrouwensanker wordt.
Automatisering met laag risico kan beschikbaar blijven binnen door software gedefinieerde permissies. Saldo's lezen, niet-ondertekende transacties voorbereiden of werken onder strak begrensde limieten kan een assistent nuttig maken zonder hem onbeperkte bestedingsmacht te geven.
Vertrouwen in wallets hangt af van regels die het model niet kan herschrijven
EIP-7906, dat nog een conceptrapport is, stelt post-transactie-assertiekaders voor die de uiteindelijke staat-verschillen inspecteren die een transactie veroorzaakt. Een assertie kan de toepassingsuitkomst verwerpen wanneer die wijzigingen een gespecificeerde voorwaarde schenden.
Een wallet zou dat mechanisme kunnen gebruiken om te eisen dat een swap alleen goedgekeurde saldo's wijzigde, dat er nooit een verborgen tokentoestemming verscheen, of dat de status van een beschermd account onaangeroerd bleef. Die controles vergelijken de werkelijke effecten van een transactie met expliciete regels.
Het concept beschrijft ook de grenzen van de bescherming. Een assertie die te weinig controleert kan vals vertrouwen creëren. Walletvalidatielogica moet het beoogde assertiekader vereisen, en de assertie zelf moet elke relevante statuswijziging van de beschermde operatie dekken.
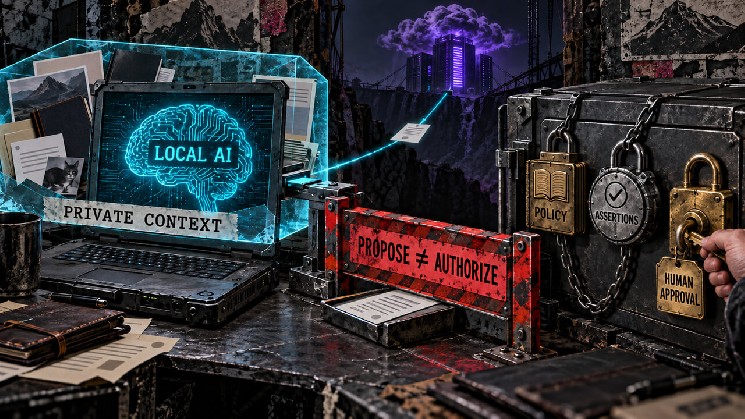
Lokale inferentie transactie-asserties lossen verschillende delen van het wallet-agentprobleem op. Het lokale model beschermt context en zet natuurlijke-taalintentie om in een voorgestelde handeling; deterministische permissies beperken ontvangers, contracten, waarde en frequentie; asserties inspecteren uiteindelijke statuswijzigingen. Menselijke bevestiging blijft de tweede factor voor risicovolle handelingen.
Het laptopresultaat van september maakt de eerste laag geloofwaardiger. Het suggereert dat een privé lokaal model snel genoeg kan reageren om dagelijks werk te coördineren en selectief externe intelligentie in te zetten. De overige lagen dragen nog steeds de autoriteit die activa beschermt.
Een crypto-wallet kan het model behandelen als een capabele interface, planner en monitor. Vertrouwen hoort bij controles die het model niet kan veranderen en bij een goedkeuringspad dat de gebruiker betekenisvol aan het roer houdt.
Bron: CryptoSlate via CryptoNewsNet.

