Open-source AI-modellen in 2026: de cijfers over downloads, gebruik en adoptie
Belangrijkste punten
- •Alibaba's Qwen had in maart 2026 in totaal 942,1 miljoen downloads op Hugging Face behaald, ruwweg het dubbele van Meta's Llama-totaal van 476,0 miljoen.
- •Mozilla schat dat open modellen ongeveer 33% van het actieve AI-gebruik verzorgen maar slechts zo'n 4% van de wereldwijde AI-omzet pakken.
- •China's open modellen passeerden de Verenigde Staten in cumulatieve downloads eind juli 2025 en leidden per maart 2026 met 428 miljoen.
- •Slechts 51% van de teams die met open modellen werken haalt productie, tegenover 63% voor gesloten modellen; de kloof wordt vooral toegeschreven aan ontbrekende infrastructuur in plaats vankwaliteit.
- •De inferentiekosten voor modellen van de GPT-4-klasse daalden in 36 maanden met ongeveer een factor 50, van ruwweg $20 naar $0,40 per miljoen tokens, een daling die het rapport koppelt aan concurrentie van open gewichten.
Open-source AI-modellen zijn inmiddels routineonderdelen van softwareontwikkeling. Ontwikkelaars downloaden ze, bouwen er applicaties op en draaien ze op hun eigen hardware. Meerdere organisaties proberen deze activiteit te meten, en hun cijfers komen niet altijd overeen. Dit rapport zet de belangrijkste cijfers naast elkaar en behandelt downloads, tokenverbruik, regionale verschuivingen, kosten, ontwikkelaarsenquêtes en bedrijfsfinanciering. Elk cijfer vermeldt zijn bron, datum en een toelichting op wat er precies wordt geteld.
Op elke maatregel hieronder is één kanttekening van toepassing. Een download is een bestandsverzoek, geen persoon. Een tokentelling meet het verrichte werk, niet het aantal gemaakte kopieën. De meeste open modellen worden nauwkeuriger omschreven als open-weight modellen: de getrainde parameters zijn openbaar, maar de trainingsdata en code vaak niet. De cijfers beschrijven daarom verschillende lagen van adoptie: distributie, inferentie, experimenteren en productie-uitrol. Ze moeten samen worden gelezen en niet als onderling uitwisselbare maten voor marktaandeel.
Belangrijkste cijfers in één oogopslag:
- Qwen had in maart 2026 in totaal 942,1 miljoen downloads op Hugging Face behaald; Llama stond op 476,0 miljoen.
- DeepSeek leverde tussen november 2024 en november 2025 14,37 biljoen tokens op OpenRouter.
- Open modellen verzorgen ongeveer 33% van het actieve AI-gebruik, maar verdienen volgens Mozilla slechts zo'n 4% van de AI-omzet.
- 79% van de ontwikkelaars die AI-functies toevoegen, gebruikt open modellen, tegen 71% voor gesloten modellen.
- Teams die met open modellen werken, halen productie minder vaak: 51%, tegenover 63% voor gesloten modellen.
Statistieken open-source AI-downloads per modelfamilie
The ATOM Report volgt ruwweg 1.500 open taalmodellen op Hugging Face en definieert een download als elk HTTP-verzoek naar een modelbestandsendpoint, inclusief geautomatiseerde pulls door tools zoals transformers of curl.
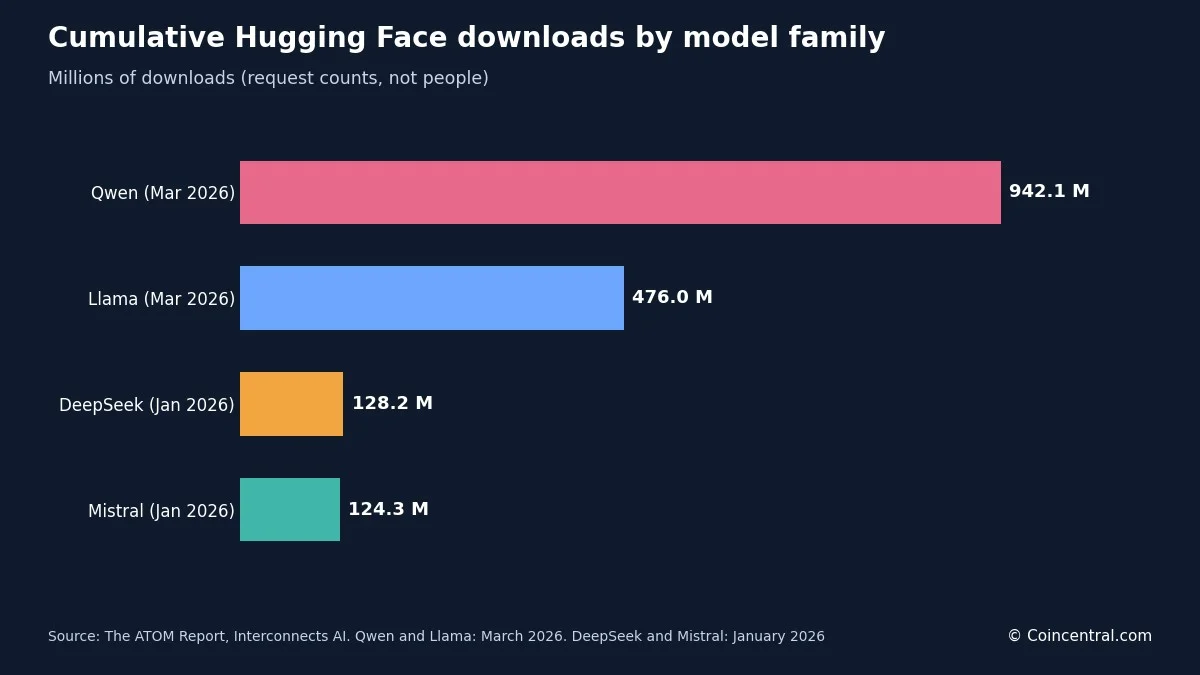
De Qwen-familie van Alibaba had in maart 2026 in totaal 942,1 miljoen downloads verzameld, terwijl de Llama-familie van Meta in dezelfde maand op 476,0 miljoen stond. Qwen passeerde Llama voor het eerst in september 2025, toen de totalen 325,4 miljoen en 323,7 miljoen waren. Zes maanden later was de kloof opgelopen tot 466,1 miljoen: Qwen voegde in die periode ruim 617 miljoen downloads toe, terwijl Llama er ongeveer 152 miljoen toevoegde.
Bron: The ATOM Report, Interconnects AI, cumulatieve Hugging Face-downloads.
DeepSeek en Mistral blijven ruim achter de top twee. DeepSeek passeerde Mistral in januari 2026, met 128,2 miljoen downloads tegen 124,3 miljoen. Mistral ging eerder aan het hoofd van het veld — het aandeel in nieuwe afgeleide modellen piekte in december 2023 op 57%, aangedreven door Mistral 7B en Mixtral. Meta's aandeel in afgeleide modellen piekte in augustus 2024 op 44% en was in februari 2026 gedaald naar 11%.
Nieuwere Amerikaanse labs beginnen vanaf een veel kleinere basis. NVIDIA's Nemotron registreerde 30,7 miljoen downloads tussen augustus 2025 en maart 2026, de OLMo van het Allen Institute for AI 14,8 miljoen en IBM's Granite 8,6 miljoen.
Bedrijfsaankondigingen volgen andere regels. Meta zei dat Llama op 18 maart 2025 voorbij 1 miljard downloads ging. Google zei dat Gemma op 20 augustus 2026 voorbij 1 miljard ging, waarbij een Google-medewerker opmerkte dat deze telling integraties in Android en Chrome buiten beschouwing laat. Geen van beide bedrijfscijfers is onafhankelijk gecontroleerd, en de ATOM-telling voor Llama omvat alleen gevolgde tekstgenererende modellen op Hugging Face, dus de twee sets cijfers zijn niet direct vergelijkbaar.
Qwen's maandelijkse volume onderbouwt zijn voorsprong. In februari 2026 genereerde Qwen alleen al 153,6 miljoen downloads, terwijl de acht daaropvolgende open modelorganisaties samen 71,2 miljoen produceerden.
Statistieken open-source AI-downloads per reg
ATOM wijst elk model toe aan de Verenigde Staten, China of Europa op basis van het hoofdkantoor van de uitgevende organisatie. De totale gevolgde downloads bereikten in maart 2026 2,04 miljard, tegen 339 miljoen een jaar eerder.
Bron: The ATOM Report, Interconnects AI, cumulatieve Hugging Face-downloads.
Geen enkele regio ging achteruit. In maart 2025 ledde de Verenigde Staten China met 80 miljoen downloads; in maart 2026 leidde China met 428 miljoen, waarbij ATOM de omslag eind juli 2025 plaatst.
Enquêtegegevens wijzen in dezelfde richting. De ontwikkelaarsenquête van Mozilla vond een open-modelgebruik van 89% in Groot-China en Oost-Azië, het hoogst van alle regio's, met West-Europa op 70%. Het verkeer op OpenRouter toont een parallelle verschuiving: Mozilla's analyse vond dat Chinese open-weight modellen groeiden van minder dan 2% van het wekelijkse verkeer eind 2024 naar 45% in april 2026.
Het zomer-rapport 2026 van Hugging Face bekeek modelgrootte. In vrijwel elke maand van 2026 was het grootste open model van een Chinees lab groter dan elk model van een Amerikaans lab. Het Chinese maandplafond lag tussen 754 miljard en 2,78 biljoen parameters, terwijl Amerikaanse modellen in vijf van de zeven maanden onder 130 miljard parameters bleven. AMD en NVIDIA brachten in 2026 elk meer dan 200 nieuwe modelrepositories uit — meer dan welke andere organisatie ook — met LiquidAI op de derde plaats met rond de 100.
Statistieken tokenverbruik voor open modellen
Downloads meten hoe vaak gewichten worden gekopieerd; tokens meten hoeveel werk een model verricht. OpenRouter en a16z analyseerden meer dan 100 biljoen tokens aan echt platformverkeer van november 2024 tot november 2025. DeepSeek leverde 14,37 biljoen tokens, vóór Qwen met 5,59 biljoen en Meta Llama met 3,96 biljoen — een andere volgorde dan de downloadranglijst, waar Qwen ruim aanvoert.
Bron: OpenRouter en a16z, State of AI, tokens gerouteerd op OpenRouter, november 2024 tot november 2025.
Open-weight modellen waren eind 2025 goed voor ruwweg een derde van het gebruik op OpenRouter. Over het jaarvenster haalden Chinese open modellen gemiddeld 13,0% van het wekelijkse tokenvolume, open modellen uit de rest van de wereld gemiddeld 13,7% en propriëtaire modellen uit de rest van de wereld 70%.
ATOM's eigen OpenRouter-reeks laat zien hoe snel aandeel kunnen verschuiven. DeepSeek V3 en R1 samen maakten in juni 2025 tot 75,6% uit van de inferencetokens van open modellen, wat in januari 2026 was gedaald naar 31,1%. Meta's aandeel zakte van een piek van 37,4% in januari 2025 naar nul in augustus 2025. De leiderschap op deze maatregel kan binnen enkele maanden wisselen.
Presenc AI, met een andere mix vannen, rapporteert een kleiner open aandeel: ongeveer 15% van de inferencetokens in januari 2026, tegen zo'n 1% een jaar eerder. Binnen die schatting heeft DeepSeek ongeveer 6%, Qwen ongeveer 5% en Llama ongeveer 3%.
Open-source versus gesloten AI: gebruik, omzet en prestaties
Mozilla publiceerde in juli 2026 zijn eerste State of Open Source AI-rapport. Het vond dat open modellen ongeveer 33% van het actieve AI-gebruik verzorgen maar slechts zo'n 4% van de wereldwijde AI-omzet pakken; gesloten modellen staan in voor de resterende 67% van het gebruik en 96% van de omzet. De divergentie komt door hoe open modelden geld verdienen: niemand betaalt licentiekosten per token om open gewichten te draaien, dus de omzet gaat naar wie het model host — vaak de eigen infrastructuur van de koper.
Andere bronnen rapporteren een lager gebruiksandeel. MIT Sloan, zoals geciteerd door TechnologyChecker, stelt gesloten modellen op ruwweg 80% van het modelgebruik en zegt dat open modellen bij uitgave ongeveer 90% van de prestaties van gesloten modellen halen.
De prestatiekloof is in de loop van de tijd verschoven. De Chatbot Arena-tracking van Mozilla toont een gemiddelde kloof die daalde van ruwweg 8,04% tot slechts 0,5% in augustus 2024. Vervolgens werd die groter nadat gesloten labs nieuwe redeneermodellen uitbrachten, en stond in maart 2026 op 3,3 procentpunten.
BenchLM gebruikt een andere schaal. Per 20 oktober 2026 waren 12 van zijn top 50 modellen (24%) open-weight, evenals 494 van de 972 modellen die het volgt (51%). Zijn beste open model, Xiaomi's MiMo-V2.6-Pro, scoorde 73,66 uit 100 en stond 12e — 13,03 punten achter het beste propriëtaire model, Claude Opus 5.5. BenchLM vermeldt de Arena Elo-kloof tussen het beste gesloten en het beste open model op 36,8 punten op 15 oktober 2026, tegenover 29,2 punten ongeveer een jaar eerder. De pagina noemt dit een verkleining, maar de afgedrukte cijfers tonen een grotere kloof, dus de trend moet met voorzichtigheid worden gelezen.
De kloof hangt ook af van de taak. De vergelijking van Presenc AI van mei 2026 toont bijna gelijkwaardigheid op kennis- en codetests en een ruime voorsprong voor gesloten modellen op zware redeneertests.
Bron: Presenc AI, Open Source vs Closed AI Market Share 2026. Waarden zijn benaderd.
Losse resultaten kunnen het patroon doorbreken. Z.ai's GLM-5.2 scoorde 81,0 op Terminal-Bench 2.1 tegen 83,4 voor GPT-5.5, en op SWE-bench Pro scoorde het 62,1 tegen 58,6 voor GPT-5.5. De eigen dataset van Mozilla had het beste open model op 67,9 op Terminal-Bench 2.1 voordat GLM-5.2 verscheen — de data van het rapport was al achterhaald op het moment van publicatie.
Statistieken ontwikkelaarsadoptie en productiegebruik
Het rapport van Mozilla is gebaseerd op een SlashData-enquête onder 1.494 ontwikkelaars, afgenomen in mei 2026, onder ontwikkelaars die AI-functies aan applicaties toevoegen.
Bron: Mozilla en SlashData 2026 ontwikkelaarsenquête, afgenomen in mei 2026. De eerste twee rijen overlappen.
In productie lopen de twee groepen uiteen. Van de teams die met open modellen werken haalt 51% productie, tegenover 63% voor gesloten modellen De rapportpagina van Mozilla vermeldt het open cijfer als 53%, terwijl zijn blogpost 51% noemt. SlashData's Alvaro Ruiz Cubero schrijft de kloof toe aan ontbrekende infrastructuur in plaats van modelkwaliteit.
Toen ontwikkelaars werden gevraagd wat open-modelprojecten belemmert, werd infrastructuurkosten het vaakst genoemd, op 27%, gevolgd door beveiliging en compliance op 26%, onderhoud en updates op 24% en implementatiecomplexiteit op 23%. De vier antwoorden liggen dicht bij elkaar, dus geen enkele enkele maatregel lost het probleem op.
Het gebruik hangt ook af van de taak. Presenc AI schat dat ongeveer 94% van edge- en on-device-werk een open model gebruikt, met aandelen van ongeveer 85% voor kostenkritisch hoogvolume-werk en ongeveer 71% voor werk met gevoelige data in vakgebieden als recht, financiën en gezondheidszorg.
Bron: Presenc AI, Open Source vs Closed AI Market Share 2026.
Enquêteresultaten hangen af van hoe de vraag wordt gesteld. Presenc AI zegt dat ongeveer 89% van de ondernemingen minstens één open-source model in productie gebruikt, terwijl de Linux Foundation, zoals geciteerd door TechnologyChecker, vond dat 63% van de organisaties open-source AI gebruikt en 89% ergens open source in hun AI-stack.
Zichtbare webimplementatie is veel lager. TechnologyChecker scande in mei 2026 meer dan 50 miljoen domeinen en vond Botpress, het meest voorkomende open-source AI-framework dat het kon detecteren, op 1.558 domeinen — tegenover 52.682 voor de gesloten OpenAI API en 1.349 voor Google's Dialogflow. Van de 899 bedrijven gekoppeld aan een Botpress-implementatie had 64% 10 of minder werknemers, had 81% minder dan 50 en ongeveer 5% had er 1.000 of meer. De Verenigde Staten waren goed voor ongeveer 23% van de gedetecteerde implementaties, gevolgd door Spanje met 6,9% en India met 6%. TechnologyChecker merkt op dat zijn methode backend-tools zoals transformers, LangChain of Ollama niet kan zien; de tellingen weerspiegelen alleen de browsergerichte laag.
Statistieken Hugging Face-ecosysteem
Het voorjaarsrapport 2026 van Hugging Face zei dat het platform in 2025 groeide naar 13 miljoen gebruikers, meer dan 2 miljoen publieke modellen en ruim 500.000 publieke datasets. Het zomer-rapport, de periode januari tot augustus 2026, registreerde een stijging van publieke modelrepositories van 2,43 miljoen naar 2,96 miljoen, datasets van 711.000 naar 1 miljoen en Spaces van 1,00 miljoen naar 1,44 miljoen.
De aandacht is sterk geconcentreerd. Het voorjaarsrapport vond dat ongeveer de helft van alle modellen minder dan 200 totale downloads had en dat de top 200 modellen — 0,01% van het totaal — 49,6% van alle downloads voor hun rekening nam. Het zomer-rapport zette het aandeel modellen met minder dan 200 downloads over hun hele bestaan op 85,6% eni dat 1,5% van de repositories goed is voor 99,2% van de downloads. De twee rapporten tellen anders en dekken verschillende perioden, maar beide tonen dezelfde vorm: een kleine groep modellen vangt vrijwel al het verkeer.
De Stanford AI Index 2026 telt ongeveer 5,6 miljoen AI-gerelateerde projecten op GitHub en Hugging Face, waarvan er slechts 206.880 (3,7%) 10 of meer sterren hebben. Modeluploads op Hugging Face verdrievoudigden zich ruim tussen 2023 en 2025, met 332.000 in een enkel kwartaal.
Bron: Hugging Face, State of Open Source on Hugging Face: Spring 2026, gepubliceerd op 17 maart 2026.
Het gemiddelde groeide veel sneller dan de mediaan. Hugging Face schrijft de opwaartse beweging aan de top toe aan kwantisatie en mixture-of-experts-ontwerpen, terwijl het gebruik van kleine modellen vlak blijft. Kleine modellen nemen nog steeds de meeste downloads: modellen onder 1 miljard parameters zijn goed voor 83% van alle downloads ooit en modellen boven 100 miljard voor 1%, terwijl van de downloads in 2026 alleen al 3% naar modellen boven 70 miljard parameters ging.
Likes en downloads meten verschillende dingen. De top 25 repositories op downloads in 2026 en de top 25 op likes deelden precies één vermelding. Het model all-MiniLM-L6-v2 werd in zeven maanden 1,55 miljard keer opgehaald en heeft 5.156 likes.
Qwen is de basis geworden waarop anderen bouwen. Op Qwen gebaseerde modellen zijn goed voor 151.448 afgeleiden op de Hub — 2,6 keer het totaal van Meta en 4,7 keer alleen de Llama-repositories — met Google erachter op 82.506. Qwen-afgeleiden groeiden in de eerste zeven maanden van 2026 met ruwweg 180 tot 210 nieuwe repositories per dag.
Lokaal draaien volgt hetzelfde patroon. Qwen registreert 39,6 miljoen GGUF-downloads per maand, tegenover 20,8 miljoen voor Gemma en 7,5 miljoen voor Llama. GGUF is het bestandsformaat dat door lokale runners zoals llama.cpp wordt gebruikt.
De snelste groei zit in de runtimelaag. Repositories die de gguf-library gebruiken stegen 464%, lerobot 194% en Apple's mlx 148%, terwijl transformers en peft 16% groeiden en diffusers 21%. Alle modelrepositories groeiden met 21,5%.
Agents zijn een nieuwe klasse van gebruikers geworden. Claude Code was in juli 2026 goed voor 44,4% van het agent-getagde verkeer naar de Hub, een daling van 67,8% in april, terwijl Codex in dezelfde maanden steeg van 10,4% naar 20,8%.
Statistieken kosten, prijzen en financiering
Mozilla rapporteert dat inferentie van de GPT-4-klasse in 36 maanden daalde van ongeveer $20 naar ruwweg $0,40 per miljoen tokens — een daling van een factor 50 die het rapport koppelt aan concurrentie van open gewichten. Een analyse van de Linux Foundation, geciteerd in het rapport, stelt inferentie van gesloten modellen op ongeveer zes keer de kosten van een vergelijkbaar open model. Mozilla zet die kloof om in een schatting van $24,8 miljard aan onbenutte jaarlijkse besparingen als kopers in aanmerking komende workloads naar open gewichten verplaatsen. Als voorbeeld verlaagde Stripe de inferentiekosten met 73% terwijl het 50 miljoen dagelijkse API-aanroepen verwerkte, door een deel van zijn AI-werk naar open modellen te verplaatsen.
Prijslijsten van providers illustreren de spreiding. De vergelijking van Presenc AI van 2026 vermeldt DeepSeek V4 op $0,14 per miljoen inputtokens, tegenover $3,00 voor GPT-5.5 en Claude 4.7 Opus.
Bron: Presenc AI, Open Source vs Closed AI Market Share 2026, providerprijzen mei 2026.
Kleinere gesloten modellen zitten dicht bij open prijzen, met GPT-5.5 mini op $0,15 en Gemini 3.1 Flash op $0,075 — in de lagere segmenten scheiden prijs alleen open en gesloten niet.
Bedrijven die op open modellen zijn gebouwd, beginnen omzet te rapporteren. Het rapport van Mozilla noemt Databricks op een run-rate van $5,4 miljard en Mistral AI op ongeveer $400 miljoen aan jaarlijkse terugkerende omzet, een stijging van een factor 20 in twaalf maanden. DeepSeek staat op ongeveer $220 miljoen en heeft $7,4 miljard opgehaald bij een waardering boven $50 miljard. Mistral kondigde op 9 september 2025 een Series C van €1,7 miljard aan tegen een post-money-waardering van €11,7 miljard, onder leiding van ASML. Zhipu AI en MiniMax werken beiden aan een beursgang in Hongkong in 2026. In mei 2026 beloofden IBM en Red Hat $5 miljard aan open-source AI-tooling en infrastructuur. Market.us voorspelt dat de markt voor open-source AI-modellen zal groeien van $19,05 miljard in 2025 naar $23,08 miljard in 2026, ongeveer 21%.
Licenties geven aan waar de opbrengst niet vandaan komt. Van 178 Chinese releases boven 20 miljard parameters in 2026 gebruikt 59% Apache 2.0 en 22% MIT. Voor Amerikaanse releases in dezelfde grootteklasse gebruikt 29% Apache of MIT, 41% eigen voorwaarden en 30% geeft niets aan. Hugging Face merkt op dat sommige van de grootste recente releases, zoals Kimi K3 en Qwen 3.8 2.4T, zijn begonnen met het toevoegen van niet-commerciële beperkingen of omzetdeeltermen — het licentielandschap verandert.
Bronnen
- The ATOM Report (arXiv)
- OpenRouter, State of AI
- Hugging Face, State of Open Source on Hugging Face: Spring 2026
- State of Open Source AI (Mozilla)
- BenchLM, Open Source LLM Statistics (2026)
- Hugging Face, State of Open Models: Summer 2026 Observations
- TechnologyChecker, Open-Source AI Adoption 2026
- Tech Insider, Open-Source AI Powers 33% of Use, Just 4% of Revenue
- Presenc AI, Open Source vs Closed AI Market Share 2026
- Command Linux, Open-Source AI Model Download Statistics 2026
Dit artikel is oorspronkelijk gepubliceerd op Blockonomi.

