ChatGPT Images 2.5 versus Nano Banana 2: een vergelijking in zes categorieën
Belangrijkste punten
- •ChatGPT Images 2.5 en Nano Banana 2 wonnen elk drie categorieën in de vergelijking.
- •Volgens OpenAI kan het nieuwe model de latency voor beeldgeneratie met maximaal 50% verlagen ten opzichte van Images 2.0.
- •Uit de test bleek dat ChatGPT Images 2.5 niet langer de gele tint of sterke overmatige verscherping uit eerdere generaties vertoonde.
- •Nano Banana 2 won de tekstzware beletteringstest en de Bitcoin-tijdlijntest nadat ChatGPT Images 2.5 spelling- en datumfouten maakte.
- •OpenAI voegde Sketch, het delen van prompts, opmerkingen bij beeldregio’s, formatsjablonen en nieuwe API-kwaliteitsniveaus high en max toe.
OpenAI lanceerde ChatGPT Images 2.5 op 8 september en beloofde scherpere details, rijkere texturen, natuurlijkere belichting, nauwkeurigere bewerkingen en tot 50% lagere latency voor beeldgeneratie dan bij Images 2.0.
In een vergelijking met zes categorieën won Nano Banana 2 drie tests en ChatGPT Images 2.5 de andere drie. De resultaten werden minder bepaald door duidelijke kwaliteitsverschillen dan door kleine, controleerbare fouten, waaronder een spelfout en een onjuiste datum in een infographic op basis van onderzoek.
OpenAI zegt dat de latency met maximaal 50% is gedaald ten opzichte van Images 2.0. Het bedrijf heeft ook twee API-modellen toegevoegd: GPT-Image-2.5 Flare, de snelle standaardoptie, en GPT-Image-2.5 Sunburst, ontworpen voor hoogwaardige bewerkingsprecisie.
De vergelijking volgt op een eerdere test die in mei werd gepubliceerd, waarin GPT Image 2 en Nano Banana 2 elkaar afwisselend versloegen in acht categorieën. GPT Image 2 won meer categorieën, maar vertoonde een kenmerkend artefact van overmatige verscherping wanneer prompts veel gelijktijdige beperkingen bevatten. Dat riep de vraag op of OpenAI het probleem in het volgende model kon oplossen.
Voor deze ronde gebruikte dezelfde beoordelaar zes categorieën die waren overgenomen uit of aangepast aan de eerdere tests en diende hij dezelfde prompts bij beide modellen in. Het model van Google was Nano Banana 2, de naam die Google gebruikt voor Gemini 3.1 Flash Image, en niet het tragere en bedachtzamere Nano Banana Pro. De test vergeleek daarmee het nieuwe, snelle en op precisie gerichte model van OpenAI met het gelijkwaardige aanbod van Google.
Wat veranderde er in GPT-Image-2.5?
De beeldmodellen van OpenAI werden eerder geassocieerd met kenmerkende tekortkomingen. Het model achter de oorspronkelijke GPT Image 1 ontwikkelde een aanhoudende warme, gele kleurzweem die gebruikers de bijnaam “piss filter” gaven. OpenAI heeft de tint nooit volledig verklaard of opgelost.
GPT Image 2 verruilde dat probleem voor een ander: prompts met te veel opeengestapelde beperkingen konden zwaar oververscherpte beelden opleveren, vol harde, overbewerkte artefacten.
Geen van beide problemen kwam in deze test naar voren. Afbeeldingen die met ChatGPT Images 2.5 werden gegenereerd, behielden hun kleurbalans en detail, zelfs bij volledig complexe prompts. De gele zweem en overmatige verscherping uit de twee eerdere generaties waren afwezig. De verbetering was vooral zichtbaar in de steampunk- en portrettests, die de fotografisch meest samenhangende ChatGPT-beelden opleverden van de drie geteste generaties.
OpenAI heeft ook workflowfuncties geïntroduceerd die niet zichtbaar worden in een eenvoudige vergelijking van afbeeldingen. Met Sketch kunnen gebruikers rechtstreeks in ChatGPT een ruwe indeling tekenen als referentie voor een generatie. Andere toevoegingen zijn het delen van prompts, opmerkingen bij specifieke delen van een afbeelding en sjablonen voor posters en merchandise. In de API lopen de kwaliteitsniveaus nu van low tot nieuwe high- en max-instellingen, boven het hoogste niveau van Images 2.0.
Hieronder staat hoe de twee modellen presteerden in de zes categorieën.
Tekstdichtheid: de scène van Kellerman’s Hardware
De eerste test toonde een ruig kruispunt om 2 uur ’s nachts, waarbij vrijwel elk oppervlak leesbare tekst bevatte: een verweerd reclamebord, met verf aangebrachte graffiti, belettering op de winkelpui, een gescheurde concertposter, een gestencilde stoeprand en een met stickers bedekte betaaltelefoon.
Nano Banana 2 gaf vrijwel alle tekst helder weer. De belangrijkste fout was een sticker op de betaaltelefoon die zijn eigen tekst op een vervormde manier herhaalde, een kleine fout die gemakkelijk over het hoofd kon worden gezien.
ChatGPT Images 2.5 voegde een detail toe dat Nano Banana 2 had weggelaten: een lantaarnpaal met overlappende, vastgeniete flyers die gescheurd en verweerd waren, precies zoals in de prompt beschreven. De straatkunsttag van het model leek echter “STILLL HERE” te spellen, met een extra L. Ook de apostrof in “KELLERMAN’S” op het verweerde reclamebord ontbrak of was onleesbaar.
Hoewel OpenAI over het geheel genomen een realistischer scène genereerde, maakte het twee afzonderlijke leesbaarheidsfouten in een test die draaide om nauwkeurige tekstweergave. Nano Banana 2 won de categorie.
Winnaar: Nano Banana 2
Ruimtelijk inzicht: de steampunk-klokkentoren
Deze test voor luchtcompositie vereiste een scène met vijf dieptevlakken en een enorme klokkentoren. De wijzerplaten moesten verschillende tijden tonen met leesbare Romeinse cijfers, terwijl zes aanvullende tekstelementen van de voorgrond tot de achtergrond waren verspreid.
ChatGPT Images 2.5 creëerde met duidelijke voorsprong het meest sfeervolle beeld. Er steeg zichtbaar stoom op van de daken, een rivier liep door het midden van de scène en het tonale bereik was rijker over de vijf dieptevlakken. De tekst was bovendien gemakkelijker te lezen.
Nano Banana 2 produceerde een vlakker beeld. De twee zichtbare wijzerplaten bevatten wel leesbare Romeinse cijfers—XII, III, VI en IX—maar de wijzers stonden op beide klokken ongeveer in dezelfde positie, in strijd met de vraag om verschillende tijden weer te geven.
ChatGPT Images 2.5 won omdat het de instructies beter volgde zonder aan realisme in te boeten.
Winnaar: ChatGPT Images 2.5
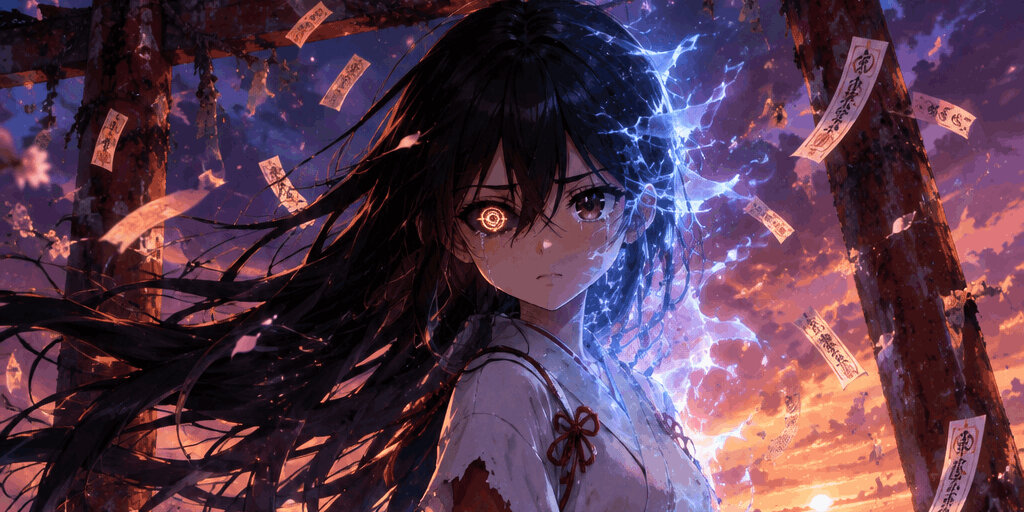
Illustratie: de anime-geestmedium
De prompt vroeg om een key visual in de stijl van Studio Ufotable, met een meisje dat bij een torii-poort verandert in spirituele energie, vergezeld door een kitsune met negen staarten onder een door Makoto Shinkai geïnspireerde schemerlucht.
ChatGPT Images 2.5 produceerde de sterkste lucht in de hele testreeks. Het beeld bevatte een zichtbare zonneschijf, een weerspiegeling in het water en een bergsilhouet die de vergelijking met Shinkai ondersteunden. Ook de asymmetrische ogen van het personage werkten goed.
Het model nam de instructie dat het meisje moest “oplossen in energie” minder letterlijk. Het herinterpreteerde dit als een elektrisch knetterend effect door haar haar, in plaats van de vloeiende, doorschijnende oplossing die in de prompt werd beschreven. Het ijle blauw-witte energiespoor van Nano Banana 2 sloot beter aan bij die specifieke instructie.
Geen van beide modellen creëerde een overtuigende vos met negen staarten. Toch won ChatGPT Images 2.5 op basis van de algehele visuele impact.
Winnaar: ChatGPT Images 2.5
Realisme: de architect op het dak
Dit filmische portret bevatte talrijke afzonderlijke beperkingen: een beige trenchcoat, een ronde bril, blauwdrukken die specifiek in de linkerhand werden vastgehouden, belichting tijdens het gouden uur, een geringe scherptediepte en filmkorrel.
ChatGPT Images 2.5 produceerde opvallend licht, met de zonneschijf direct achter het onderwerp en uitstekende microtextuur van de huid. De huid was te glad, maar de omgeving zag er zeer realistisch uit, vergelijkbaar met een foto gemaakt met een analoge camera.
Het toevoegen van instructies die de fotografische kwaliteit normaal gesproken zouden verminderen, verhoogde onverwacht het realisme van het beeld. Een generatie gebruikte onder meer de trefwoorden “realistic, highlights, crushed shadows, uneven flash, blown out skin tones, candid moment, shot on a phone camera”.
Nano Banana 2 behield een vollere compositie en plaatste de blauwdrukken in de rechterhand van het onderwerp in plaats van de gevraagde linkerhand. Het voegde wel een leesbaar label aan de blauwdruk toe: “PROJECT: 124 DUANE ST”, een detail dat bij de meeste generaties ontbrak.
Nano Banana 2 won de vergelijking van één opname, terwijl ChatGPT Images 2.5 sterker werd beoordeeld bij herhaalde iteraties.
Winnaar: Nano Banana 2 voor één opname; ChatGPT Images 2.5 voor herhaalde iteraties
Agentisch onderzoek: de Bitcoin-tijdlijn
Beide platforms kunnen een onderwerp onderzoeken voordat ze een afbeelding genereren. De test vroeg om een breedbeeldtijdlijn van de Bitcoin-geschiedenis in de stijl van een kindertekening, met een strikte eis voor feitelijke nauwkeurigheid. Dit was de belangrijkste categorie in de vergelijking en leverde het grootste verschil tussen de modellen op.
ChatGPT Images 2.5 genereerde een overzichtelijke infographic met twee rijen en talrijke specifieke datums, maar één daarvan was onjuist. Het model vermeldde 2023 als het jaar waarin Bitcoin-ETF’s in de Verenigde Staten werden goedgekeurd. De Amerikaanse Securities and Exchange Commission keurde de eerste spot-Bitcoin-ETF’s goed op 10 januari 2024, een volledig jaar later. De bron merkte op dat de afwijking mogelijk het gevolg was van een interpretatiekwestie, aangezien futures-ETF’s in dat jaar werden goedgekeurd.
Nano Banana 2 produceerde een minder gestructureerde tijdlijn met vergelijkbare gebeurtenissen. Voor de goedkeuring van de ETF’s en de vierde halving gebruikte het model een bereik van “2023–2024” in plaats van één onjuist jaar te noemen. Daardoor was geen van de genoemde datums technisch onjuist.
Nano Banana 2 won omdat een zelfverzekerd gepresenteerde onjuiste datum zwaarder weegt in een test die moet beoordelen of “agentisch redeneren” tot nauwkeurig onderzoek leidt.
Winnaar: Nano Banana 2
Abstracte concepten: een prompt met verzonnen woorden
De laatste prompt bestond vrijwel volledig uit verzonnen termen: “A woman eating shmfiyxl in Lyxin. Next to her, her Lymglsushing plays Lakishkark.” Het gerecht, de locatie, de metgezel en de activiteit hadden geen woordenboekdefinities. Elk model moest hun betekenis verzinnen en bepalen hoe het die zou weergeven.
ChatGPT Images 2.5 verwerkte de onzintermen rechtstreeks als zichtbare tekst in de scène. “Lyxin” verscheen op een neonbord boven een strak, futuristisch restaurant, terwijl “Lakishkark” op de doos van een bordspel stond dat door de buitenaardse tafelgenoot van de vrouw werd gespeeld. Door de verzonnen termen om te zetten in leesbare bewegwijzering maakte het model ze concreet in plaats van abstract.
Nano Banana 2 koos een andere aanpak. Het genereerde een warme, cultureel specifieke scène met een Guatemalteekse marktkraam, een vrouw in een traditionele huipil en een orkachtig wezen dat een hybride snaar- en blaasinstrument bespeelde. Het interpreteerde “plays” als muziek maken in plaats van een spel spelen, een andere maar geldige lezing van de prompt.
Niets in de afbeelding verwees echter specifiek naar “Lyxin” of “Lakishkark”, en geen van beide verzonnen woorden verscheen als zichtbare tekst. ChatGPT Images 2.5 won omdat het omzetten van ongedefinieerde concepten in leesbare labels het meest letterlijke antwoord was op een prompt zonder vaststaande betekenissen.
Winnaar: ChatGPT Images 2.5
Het oordeel
Nano Banana 2 won drie van de zes categorieën, waardoor de vergelijking feitelijk gelijk eindigde. De uitkomst hangt af van de verwachtingen van de gebruiker en de manier waarop het model wordt gebruikt.
ChatGPT Images 2.5 loste het probleem met overmatige verscherping van zijn voorganger op. De illustratie-output was mogelijk de visueel meest indrukwekkende afzonderlijke afbeelding die een van beide modellen in de twee volledige testrondes produceerde.
De keuze voor een model hangt daarom samen met de taak: tekstzware en op onderzoek gebaseerde afbeeldingen leggen meer nadruk op exacte leesbaarheid en feitelijke controle, terwijl illustratie en workflows met herhaalde generaties andere sterke punten benadrukken die in deze test naar voren kwamen. De vergelijking wijst geen universele winnaar aan, maar laat wel zien waarom het beoordelen van beeldmodellen meer vereist dan het beoordelen van één afbeelding op visuele aantrekkingskracht.
Het belangrijkste verschil zat niet in de algehele kwaliteit, maar in een reeks kleine, verifieerbare details: een spelfout in een scène met veel belettering, een onjuist jaar in een infographic op basis van onderzoek en andere beperkte fouten in het volgen van instructies. Wat betreft algemene esthetiek en beeldkwaliteit waren de twee modellen grotendeels vergelijkbaar.

