Kosten van AI-modellen: trainingsuitgaven stijgen terwijl inferentieprijzen instorten
Belangrijkste punten
- •Epoch AI schat dat de geamortiseerde hardware- en energiekosten van frontiertrainingsruns sinds 2016 jaarlijks met circa 2,4 keer zijn gegroeid, en voorspelt dat de grootste runs rond 2027 de $1 miljard kunnen overstijgen als de trend zich voortzet.
- •De geschatte trainingsrekenkracht bedroeg circa $79 miljoen voor GPT-4, $192 miljoen voor Gemini 1.0 Ultra en $170 miljoen voor Llama 3.1 405B, terwijl hardware 47% tot 67% van de ontwikkelkosten van frontiermodellen vormt en researchpersoneel nog eens 29% tot 49% goed is.
- •DeepSeek meldde circa $5,576 miljoen aan trainingsrekenkracht voor DeepSeek-V3, gebaseerd op ongeveer 2,788 miljoen Nvidia H800 GPU-uren, een cijfer dat eerdere research, ablatiestudies en andere ontwikkelkosten uitsluit.
- •De kosten voor het bereiken van een vast niveau van AI-prestaties zijn sinds 2023 met circa 47% per kwartaal gedaald, ongeveer 13 keer per jaar — een tempo dat volgens Epoch AI sneller is dan eerdere kostencurves zoals DNA-sequencing en lithium-ionbatterijen.
- •Inferentie op GPT-3.5-niveau daalde van circa $20 per miljoen tokens eind 2022 naar $0,07 in oktober 2024, en per oktober 2026 rekenden kleine commerciële modellen zoals GPT-6 Luna en Claude Haiku 5.5 $0,10 per miljoen invoertokens en $0,50 per miljoen uitvoertokens.
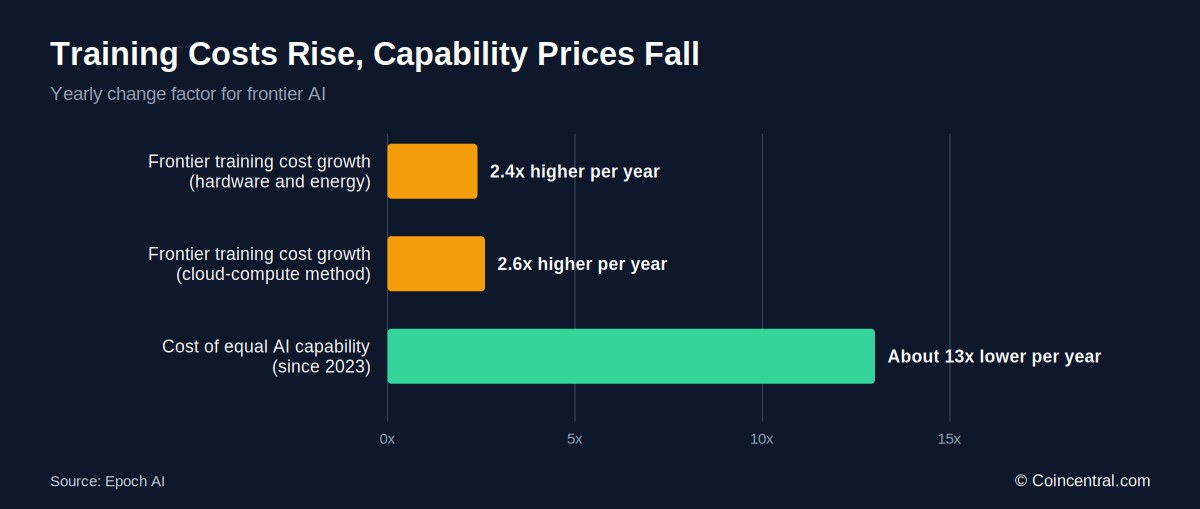
Kunstmatige intelligentie is een tijdperk binnengegaan van gesplitste economie: de kosten van het bouwen van frontiermodellen blijven stijgen, terwijl de kosten van het gebruik ervan blijven dalen. Beide trends vinden tegelijkertijd plaats.
Het trainen van een frontier-AI-model kan tientallen of zelfs honderden miljoenen dollars aan rekenkracht vergen. Epoch AI schat dat de hardware- en energiekosten van deze trainingsruns jaarlijks met circa 2,4 keer zijn gegroeid.
Zodra een model is getraind, keert het beeld om. Volgens Epoch AI is de prijs voor het bereiken van een vast niveau van AI-prestaties sinds 2023 elk kwartaal met circa 47% gedaald — ongeveer een daling van 13 keer per jaar.
Dit artikel bundelt de belangrijkste cijfers over trainingskosten, inferentiekosten en tokenprijzen, gebaseerd op gegevens van Epoch AI, Stanford University, DeepSeek, OpenAI, Anthropic en Google. Alle prijzen zijn standaard gepubliceerde tarieven per oktober 2026.
Belangrijkste cijfers in één oogopslag
- De trainingskosten voor frontier-AI zijn jaarlijks met circa 2,4 keer gegroeid.
- Epoch AI voorspelt dat de grootste trainingsruns rond 2027 de $1 miljard kunnen overstijgen als de trend zich voortzet.
- De trainingsrekenkracht van GPT-4 wordt geschat op circa $79 miljoen.
- Gemini 1.0 Ultra wordt geschat op circa $192 miljoen.
- Llama 3.1 405B wordt geschat op circa $170 miljoen.
- Grok-2 wordt geschat op circa $107 miljoen.
- DeepSeek meldde $5,576 miljoen voor de officiële trainingsrun van DeepSeek-V3, een cijfer dat eerdere research- en personeelskosten uitsluit.
- Hardware vormt circa 47% tot 67% van de ontwikkelingskosten van frontiermodellen; research- en ontwikkelingspersoneel goed voor nog eens 29% tot 49%.
- Energie vertegenwoordigt slechts circa 2% tot 6%.
- De kosten van gelijke AI-prestaties dalen met circa 47% per kwartaal, of ongeveer 13 keer per jaar.
- Inferentie op GPT-3.5-niveau daalde tussen eind 2022 en eind 2024 met meer dan 280 keer in kosten.
- GPT-6 Luna en Claude Haiku 5.5 kosten $0,10 per miljoen invoertokens en $0,50 per miljoen uitvoertokens.
- Gegecachte tokens kunnen op sommige API's 90% tot 95% goedkoper zijn dan gewone invoertokens.
De groeiende kloof tussen stijgende trainingskosten en dalende gebruiks kosten staat centraal in de AI-economie. De rest van dit artikel behandelt beide kanten achtereenvolgens.
Hoeveel kost het trainen van een AI-model?
Er is geen eenduidig antwoord. De kosten lopen uiteen van een paar honderd dollar voor vroege onderzoekmodellen tot honderden miljoenen dollars voor frontiersystemen.
Stanford's AI Index, met schattingen ontwikkeld in samenwerking met Epoch AI, houdt bij hoe de trainingskosten zijn geëvolueerd. Stanford wijst erop dat deze cijfers vooral de gebruikte rekenbronnen schatten en niet de volledige economische kosten van het bouwen van elk model. Toch is de verandering over zeven jaar indrukwekkend: de oorspronkelijke Transformer kostte naar schatting minder dan $1.000 aan rekenkracht om te trainen, terwijl GPT-4 circa $79 miljoen kostte — meer dan 100.000 keer zoveel.
Niet elk model volgt de stijgende lijn. Llama 2 70B, met circa $3 miljoen, kostte minder dan GPT-3 met $4 miljoen en aanzienlijk minder dan PaLM 540B met $12 miljoen. Modelgrootte, chipsoort en trainingsmethode bepalen allemaal de uiteindelijke rekening.
Trainingskosten voor frontiermodellen groeien 2 tot 3 keer per jaar
Epoch AI bestudeerde tientallen grote AI-systemen en schat dat de geamortiseerde hardware- en energiekosten van frontiertrainingsruns sinds 2016 jaarlijks met circa 2,4 keer zijn gegroeid. Een aparte methode op basis van cloud-computeprijzen vond een vergelijkbaar tempo van 2,6 keer per jaar. Dat twee onafhankelijke benaderingen naar hetzelfde bereik wijzen, geeft de schatting extra gewicht.
Als de trend zich voortzet, voorspelt Epoch dat de grootste frontiermodellen rond 2027 de $1 miljard per trainingsrun kunnen overstijgen. Stanford merkte in 2026 op dat industrie-schattingen voor nieuwe frontiersystemen nu variëren van honderden miljoenen dollars richting $1 miljard per iteratie.
Dat betekent niet dat elk toekomstig topmodel een miljard dollar zal kosten. Mixture-of-experts-ontwerpen, betere data, verbeterde algoritmes en goedkopere hardware kunnen allemaal de rekenkracht verminderen die nodig is voor een bepaald prestatieniveau. DeepSeek liet zien hoe groot dat verschil kan zijn.
Trainingskosten van DeepSeek-V3
DeepSeek trok brede aandacht nadat het een trainingskost van circa $5,576 miljoen voor DeepSeek-V3 meldde. Het technische rapport vermeldt dat het volledige officiële trainingsproces circa 2,788 miljoen Nvidia H800 GPU-uren gebruikte. Bij een veronderstelde huurprijs van $2 per GPU-uur komt het totaal uit op het genoemde bedrag van $5,576 miljoen.
Dit cijfer wordt vaak verkeerd gelezen. Het is niet de totale ontwikkelkosten van V3. DeepSeek gaf aan dat het cijfer eerdere research, architectuur-experimenten, ablatiestudies, datatwerk en andere ontwikkelkosten uitsluit. Daarom is het niet direct te vergelijken met schattingen die bredere R&D-uitgaven meenemen; een eerlijke vergelijking vereist aan beide kanten dezelfde reikwijdte.
Wat het cijfer wél laat zien, is dat ontwerp- en engineeringkeuzes de kosten van een definitieve grote trainingsrun aanzienlijk kunnen verlagen — een bevinding met gevolgen voor de hele industrie.
Rekenkracht is maar een deel van de kosten
Het bouwen van een frontiermodel vergt meer dan GPU's. Epoch AI schat dat de totale ontwikkelkosten zich over drie hoofdgebieden verdelen: hardware vormt circa 47% tot 67%, research- en ontwikkelingspersoneel goed voor nog eens 29% tot 49%, en energie vertegenwoordigt slechts circa 2% tot 6%.
Bijkomende kosten kunnen bestaan uit data-acquisitie, dataopschoning, mislukte experimenten, post-training en reinforcement learning. Veiligheidstests, modelevaluaties, netwerken, opslag en datacenterfaciliteiten tellen allemaal mee.
Daardoor kan de officieel genoemde kostprijs van een definitieve trainingsrun aanzienlijk te laag zijn voor wat het kost om een concurrerend frontiermodel te bouwen, en de kloof tussen beide cijfers kan groot zijn.
Inferentie en tokenprijzen
Training versus inferentie
Training creëert een model; inferentie voert het uit. Bedrijven betalen voor inferentie telkens wanneer iemand het model gebruikt. Als miljoenen mensen dagelijks een model gebruiken, kan de totale inferentie-uitgave de kostprijs van de oorspronkelijke training overstijgen.
Deze dynamiek wordt belangrijker nu AI doordringt in codeeragents, AI-zoekfuncties, klantenservice, spraakassistenten, videoanalyse en bedrijfsautomatisering. Een chatbotantwoord van een paar honderd tokens is goedkoop; een codeeragent die miljoenen tokens leest, herhaaldelijk tools aanroept en uren draait, verbruikt veel meer rekenkracht.
Actuele tokenprijzen
De meeste commerciële AI-API's rekenen per token. Een token is een klein stukje tekst, en één miljoen tokens komt overeen met honderdduizenden Engelse woorden, hoewel de exacte verhouding varieert.
De prijzen van $2 en $10 van Gemini 4 Argon zijn introductietarieven tot 30 november 2026. Google zegt dat de standaardprijzen daarna stijgen naar $4 voor invoer en $20 voor uitvoer.
Dit zijn lijstprijzen. Het zijn niet de eigen kosten van de aanbieders om de modellen te draaien.
Kleine modellen versus frontiermodellen
OpenAI's GPT-6 Luna rekent $0,10 per miljoen invoertokens en $0,50 per miljoen uitvoertokens. Anthropic's Claude Haiku 5.5 hanteert dezelfde publieklijke prijs voor prompts onder 100.000 tokens. Anthropic bracht Haiku 5.5 in oktober 2026 uit en zegt dat het model gemiddeld circa 75% goedkoper te draaien is dan Haiku 4.5.
Bij deze tarieven betaalt een bedrijf dat 100 miljoen invoertokens naar een $0,10-model stuurt slechts $10, terwijl 10 miljoen uitvoertokens tegen $0,50 per miljoen nog eens $5 kosten. Uitvoer is duurder omdat modellen token voor token genereren, wat meer rekenkracht vergt.
Goedkope modellen zijn niet voor elke taak geschikt. Frontier-reasoningsystemen hebben veel meer rekenkracht nodig, en aanbieders rekenen daarvoor naar verhouding meer: Anthropic vermeldt Claude Opus 5.5 tegen $4 per miljoen invoertokens en $20 per miljoen uitvoertokens — 40 keer de uitvoerprijs van Haiku 5.5.
Dat verschil geeft AI-agents een duidelijke reden om eenvoudige taken naar kleine modellen te routeren, en de dure modellen te reserveren voor complex redeneren.
Inferentiekosten van AI zijn sterk gedaald
Stanford's AI Index geeft een duidelijk voorbeeld. In november 2022 kostte prestatie op GPT-3.5-niveau op de MMLU-benchmark circa $20 per miljoen tokens. In oktober 2024 bereikte Gemini 1.5 Flash-8B hetzelfde benchmarkniveau voor $0,07 per miljoen tokens — een daling van meer dan 280 keer in minder dan twee jaar.
Stanford constateerde dat inferentieprijzen jaarlijks tussen 9 keer en 900 keer daalden, afhankelijk van de gemeten taak. Het bereik is breed omdat elke benchmark en elk prestatieniveau zijn eigen prijsgeschiedenis heeft.
Lagere winstmarges zijn niet de enige oorzaak. AI-modellen en de hardware waarop ze draaien zijn aanzienlijk efficiënter geworden.
De prijs van gelijke AI-capaciteit daalt 13 keer per jaar
Het septemberonderzoek van Epoch AI uit 2026 gaat verder dan ruwe tokenprijzen en meet wat het kost om een vast niveau van modelprestaties te bereiken. Epoch schat dat deze kosten sinds 2023 elk kwartaal met circa 47% zijn gedaald. Over een heel jaar betekent dat een daling van ongeveer 13 keer.
De rekening is eenvoudig. Als de prijs elk kwartaal met 47% daalt, blijft 53% over. Na vier kwartalen blijft circa 7,9% over — bijna een dertiende.
Epoch zegt dat deze daling sneller verloopt dan eerdere grote technologiekostencurves, waaronder DNA-sequencing, algemene computertechniek, lithium-ionbatterijen en elektriciteitskosten. Het tempo verschilt per taak.
Hardware en software maken AI goedkoper om te draaien
AI-inferentie profiteert van gestage verbeteringen in chip-economie, die Stanford bijhoudt via drie jaarlijkse trends voor machine-learninghardware. Moderne GPU's gebruiken bovendien numerieke formaten met lagere precisie, betere geheugensystemen en snellere verbindingen tussen chips. Elke verandering laat een datacenter meer werk doen voor hetzelfde geld.
Software versterkt deze winsten. Technieken zoals kwantisatie, distillatie, sparsity, mixture-of-experts-ontwerpen, speculative decoding, continu batching en betere compilers verminderen allemaal de rekenkracht per antwoord. Daardoor kan dezelfde hoeveelheid AI-capaciteit in de loop van de tijd met minder rekenbronnen worden geleverd.
Caching en batchverwerking verlagen de kosten verder
Moderne API's geven steeds vaker korting op herhaalde informatie. Denk aan een AI-agent die bij elk verzoek dezelfde honderd pagina's tellende bedrijfshandleiding meestuurt: een aanbieder kan die tekst cachen in plaats van die telkens opnieuw te verwerken.
OpenAI rekent $0,20 per miljoen gecachte invoertokens voor GPT-6 Sol, tegenover $2 voor gewone invoer — een korting van 90%. Google's Gemini 4 Argon geeft momenteel 95% korting op in aanmerking komende impliciet gecachte invoer.
Gebruikers die geen directe antwoorden nodig hebben, kunnen ook minder betalen. OpenAI prijst Batch- en Flex-verwerking voor GPT-6 Sol op circa 50% van de standaardtarieven. Batchverwerking is geschikt voor documentclassificatie, analyse overnachts, data-extractie, grootschalige samenvattingen en offline evaluaties.
AI-prijzen beginnen op cloud computing te lijken: klanten betalen verschillende tarieven afhankelijk van snelheid, betrouwbaarheid en de flexibiliteit van de werkbelasting.
Kosten per taak en totale AI-uitgaven
Waarom de prijs per token misleidend kan zijn
Een model dat $1 per miljoen tokens kost, is niet altijd goedkoper dan een model dat $2 kost. Stel dat het eerste model 5 miljoen tokens nodig heeft om een taak te voltooien, terwijl het tweede model dat met 1 miljoen doet. Het eerste model kost $5 voor de taak, het tweede $2.
Reasoningmodellen maken deze controle belangrijker, omdat ze grote hoeveelheden interne denk tokens kunnen genereren — en sommige daarvan worden gefactureerd. Anthropic zegt dat Claude Sonnet 5.5 per taak fewer tokens gebruikt dan Sonnet 5, wat het in de praktijk goedkoper kan maken, zelfs waar de lijstprijzen op elkaar lijken. Bedrijven volgen steeds vaker de kosten per succesvol voltooide taak in plaats van alleen de kosten per miljoen tokens.
Wat de prijzen laat dalen
Drie krachten drukken de inferentiekosten omlaag: efficiëntere hardware, efficiëntere modelontwerpen en sterke concurrentie tussen aanbieders.
OpenAI verlaagde de API-prijzen van GPT-6 Sol en Luna met circa 50% ten opzichte van hun promotionele GPT-5.6-tegenhangers, terwijl de capaciteit ook verbeterde. Anthropic zegt dat Haiku 5.5 per typische werkbelasting circa 75% goedkoper is dan Haiku 4.5. Ook Google concurreert op tokenprijzen.
Het gevolg is dat AI-toepassingen die twee of drie jaar geleden te duur waren, nu in gewone producten passen.
Dalende kosten kunnen de totale uitgaven verhogen
Goedkopere AI betekent niet altijd lagere sectorsuitgaven. Een bedrijf zou een miljoen klantgesprekken misschien niet automatiseren als elk gesprek $1 kost. Bij één cent per gesprek automatiseert het ze misschien allemaal.
Het patroon lijkt op het Jevons-paradox, waarbij efficiënter gebruik van een hulpbron leidt tot meer totaal gebruik. Dat kan helpen verklaren waarom de grootste cloudbedrijven honderden miljarden dollars blijven uitgeven aan AI-datacenters, zelfs nu de kosten per query dalen.
Conclusie
De AI-economie beweegt tegelijk in twee richtingen. Aan het front stijgen de trainingskosten snel: GPT-4 had naar schatting $79 miljoen aan trainingsrekenkracht nodig, Gemini 1.0 Ultra circa $192 miljoen en Llama 3.1 405B circa $170 miljoen, en Epoch AI schat dat de trainingskosten voor frontiermodellen jaarlijks met circa 2,4 keer zijn gegroeid.
Zodra modellen beschikbaar zijn, daalt de kostprijs van gebruik snel. Inferentie op GPT-3.5-niveau daalde van circa $20 per miljoen tokens in 2022 naar $0,07 in 2024, en nieuwer onderzoek van Epoch stelt de daling van de kosten van een vast AI-prestatieniveau op circa 47% per kwartaal, of ongeveer 13 keer per jaar. Per oktober 2026 kosten kleine commerciële modellen slechts $0,10 per miljoen invoertokens en $0,50 per miljoen uitvoertokens.
Kortom: de meest geavanceerde modellen zijn duurder om te bouwen, terwijl de output van die modellen goedkoper is om te gebruiken. Als dat zo blijft, kan het effect van AI minder afhangen van wat één model kost om te trainen, en meer van wat er gebeurt wanneer miljarden mensen en bedrijven tegen prijzen nabij gewone cloudsoftware toegang krijgen tot krachtige AI.
Bronnen
- Epoch AI: The Plunging Price of Thought
- Epoch AI: How Much Does It Cost to Train Frontier AI Models?
- Stanford University: 2025 AI Index Report, Research and Development
- Stanford University: 2026 AI Index Report
- DeepSeek: DeepSeek-V3 Technical Report
- OpenAI: Introducing GPT-6 Sol and Luna
- OpenAI: API Pricing
- Anthropic: Claude Haiku 5.5
- Anthropic: Claude Sonnet 5.5
- Google AI: Gemini 4 Argon Pricing
Dit artikel verscheen oorspronkelijk op CoinCentral.

