xAIのGrok 4.7、法的エージェントベンチマークでAnthropicとOpenAIのモデルを低価格で上回るスコア
重要ポイント
- •Grok 4.7はHarvey Legal Agent Benchmarkで19.6%を記録し、6.7%のAnthropic Fable 5.1の約3倍、2.5%のOpenAI GPT-5.6 Solの約8倍のスコアとなった。
- •価格は入力100万トークンあたり2ドル、出力100万トークンあたり6ドルに設定され、入力コストはFable 5.1の10ドルの5分の1、GPT-5.6 Solの4ドルの半分である。
- •AnthropicのFable 5.1は長時間のコーディング・ターミナル系ベンチマークで大きなリードを維持しており、Terminal-Bench 4.0Grok 4.7に対して約20ポイント差で勝利している。
- •Grok 4.7は2.1兆パラメータで動作し、前モデルから40%増加している。Starlink衛星のテレメトリや製造記録を含むSpaceXの追加データで学習された。
- •公表されたベンチマーク数値はすべてxAI自身のテストによるもので独立した検証はなく、価格性能チャートの基となったCursorBenchは、SpaceXが最近買収したCursorが開発したものである。
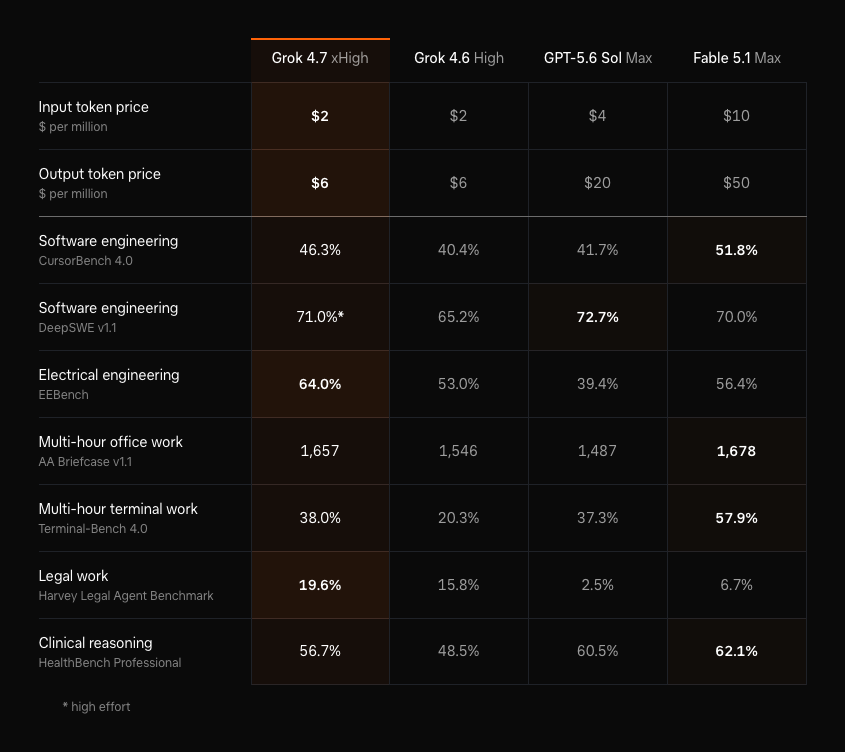
xAIは月曜日、Grok 4.7をリリースした。この新しいフラッグシップモデルは、法的エージェント系ベンチマークにおいてAnthropicのFable 5.1とOpenAIのGPT-5.6 Solを上回るスコアを記録し、入力トークンあたりの価格はFable 5.1の5分の1に抑えられている。
xAIのリリース発表によると、Grok 4.7はHarvey Legal Agent Benchmarkで19.6%を記録した。同じテストでFable 5.1は6.7%、GPT-5.6 Solは2.5%にとどまっており、Grok 4.7はAnthropicの約3倍、Solの約8倍のスコアとなっている。Cryptopolitanは先月、同社の前モデルGrok 4.6がすでに15.8%でこの2モデルをリードしていたと報じている。Harveyベンチマークは法律テック企業のHarveyが運営しており、多段階の法的業務におけるモデルの能力を評価するもので、エージェント型AIの導入が最も注目される専門分野の一つである。
法的業務は、Grok 4.7が両競合を明確に上回る数少ない分野の一つだ。同モデルはEEBenchの電気工学テストでもFable 5.1を上回り、DeepSWEのコーディングベンチマークでもわずかに優れた成績を収めている。
価格と価格性能比
Grok 4.7の価格は入力100万トークンあたり2ドル、出力100万トークンあたり6ドルで、Grok 4.6と同じ水準だ。この入力単価はGPT-5.6 Solの4ドルの半分、Fable 5.1の10ドルの5分の1に相当する。出力面では、Grok 4.7は6ドルに対し、Solは20ドル、Fableは50ドルであり、Anthropicの約8分の1となっている。100万トークンあたりの単価はAPIプロバイダーの標準的な課金方式であり、入力トークンはモデルが読み取る量、出力トークンは書き出す量を指すため、開発者が最先端モデルを選ぶ際に比較するのがこの定価となる。
xAIはまた、CursorBench 4.0のスコアをタスク完了あたりの平均コストに対してプロットし、同モデルが価格性能フロンティア上に位置すると主張。そのチャートでGrok 4.7はタスクあたり約6ドルで約46%に達するのに対し、Claude Opus 5は同程度の結果を得るのにほぼ2倍の費用を要する。Fable 5.1は予算が大きい場合に優れており、タスクあたり約17ドルで51.8%まで上昇する。
イーロン・マスク氏はXへの投稿で、今回のリリースを「知性、速度、低コストの強力な組み合わせ」と述べた。
ターミナル・コーディング系テストではAnthropicがリードを維持
Grok 4.7はGDPvalとAA Briefcaseの事務作業テストでFable 5.1に次ぐ2位となり、Anthropicのモデルはより長時間のコーディングおよびターミナル系ベンチマークで明確なリードを保っている。最大の差がついたのはTerminal-Bench 4.0で、Fable 5.1が57.9%に対しGrok 4.7は38.0%と、約20ポイントの開きがある。FableはCursorBenchやHealthBench Professionalの臨床推論でもリードしており、臨床推論ではGPT-5.6 SolもGrokを上回っている。
Grok 4.7はGDPvalで1,695 Eloを獲得した。GDPvalは弁護士、看護師、金融アナリストが行うタスクでモデルを評価するベンチマークであり、Grok 4.6の1,605から上昇した。これはFable 5.1の1,735には及ばないが、同じチャートでOpenAIの新型GPT-6 Astraが記録した1,542は上回っている。Eloレーティングはチェスから応用されたもので、生のパーセンテージスコアではなく相対的な結果によってモデルを順位付ける。
全体として、Grok 4.7は7つのベンチマークのうち5つでGPT-5.6 Solを上回っており、下回っているのはDeepSWEと臨床テストのみである。
SpaceXデータで学習されたより大型のモデル
Grok 4.7は2.1兆パラメータで動作し、Grok 4.6の1.5兆から40%増加している。xAIはStarlink衛星のテレメトリや製造記録など、SpaceXの追加学習データを取り入れたほか、新モデルは前モデルよりも困難な問題に多くの時間をかけ、自らの回答を再確認する傾向が強いと説明している。
同モデルはGrokアプリ、Cursor、Grok Build、xAI APIでウェイトリストなしで提供が開始された。
上記の数値はすべて独立した検証ではなくxAI自身のテストによるものである。xAIの価格性能チャートの基となったCursorBenchはCursorが開発しており、SpaceXは先月Cursorの買収を完了した。xAIはGrok 4.7をGPT-5.6 Solと比較ベンチマークしており、OpenAIの新型GPT-6 AstraはGDPval、AA Briefcase、EEBenchの比較にのみ登場する。これらの差の初めての外部検証は、第三者による評価となるだろう。

