Grok 4.7 di xAI supera i modelli di Anthropic e OpenAI nel benchmark per agenti legali a una frazione del prezzo
Punti chiave
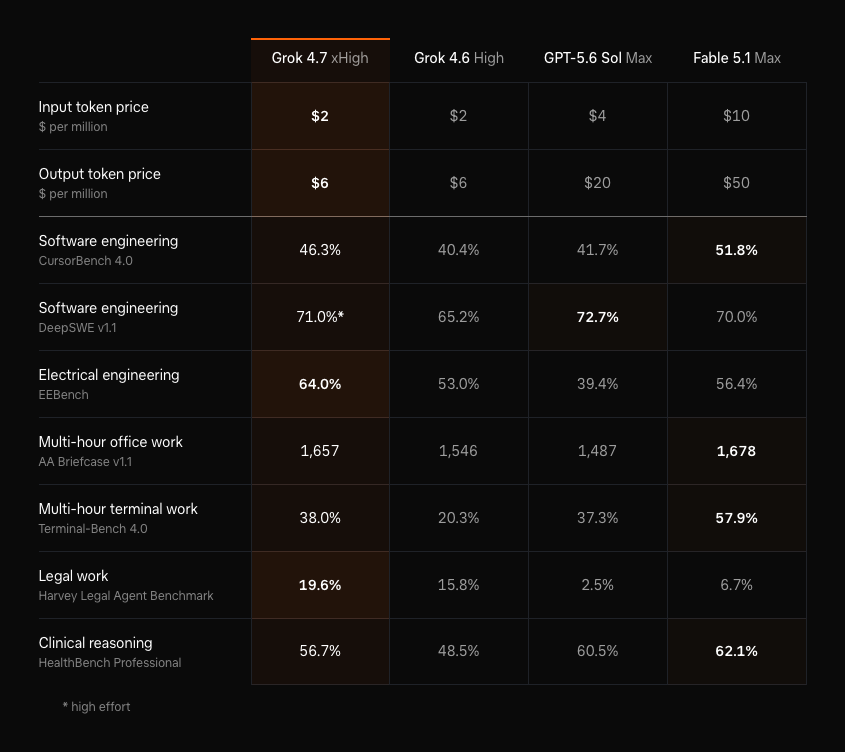
- •Grok 4.7 ha ottenuto il 19,6% nell'Harvey Legal Agent Benchmark, circa il triplo di Fable 5.1 di Anthropic al 6,7% e quasi otto volte il 2,5% di GPT-5.6 Sol di OpenAI.
- •Il modello è offerto a 2 dollari per milione di token di input e 6 dollari per milione di token di output, con un costo di input pari a un quinto dei 10 dollari di Fable 5.1 e alla metà dei 4 dollari di GPT-5.6 Sol.
- •Fable 5.1 di Anthropic conserva vantaggi sostanziosi nei benchmark più lunghi di programmazione e terminale, vincendo Terminal-Bench 4.0 con circa 20 punti percentuali di scarto su Grok 4.7.
- •Grok 4.7 gira su 2,1 trilioni di parametri, il 40% in più rispetto al predecessore, ed è stato addestrato con dati supplementari di SpaceX, inclusi la telemetria dei satelliti Starlink e i registri di produzione.
- •Tutte le cifre dei benchmark pubblicati provengono dai test interni di xAI e non da verifiche indipendenti, e il CursorBench alla base del grafico prezzo-prestazioni è realizzato da Cursor, acquisita di recente da SpaceX.
xAI ha lanciato lunedì Grok 4.7, presentando un nuovo modello di punta che ha superato Fable 5.1 di Anthropic e GPT-5.6 Sol di OpenAI in un benchmark per agenti legali, applicando al contempo un quinto del prezzo di Fable 5.1 per token di input.
Secondo l'annuncio di rilascio di xAI, Grok 4.7 ha ottenuto il 19,6% nell'Harvey Legal Agent Benchmark, dove Fable 5.1 ha raggiunto il 6,7% e GPT-5.6 Sol si è fermato al 2,5%. Questo colloca Grok 4.7 a circa tre volte il punteggio di Anthropic e quasi otto volte quello di Sol. Cryptopolitan ha riferito il mese scorso che il precedente modello dell'azienda, Grok 4.6, guidava già la stessa coppia con il 15,8%. Il benchmark Harvey è gestito dall'azienda di tecnologia legale Harvey e valuta i modelli su attività legali articolate in più fasi, uno dei domini professionali in cui l'adozione dell'AI agentica è osservata più da vicino.
Il lavoro legale si distingue come uno dei pochi domini in cui Grok 4.7 supera nettamente entrambi i concorrenti. Il modello supera inoltre Fable 5.1 nel test di ingegneria elettrica EEBench e lo scavalca di poco nel benchmark di programmazione DeepSWE.
Prezzi ed economicità
Grok 4.7 è offerto a 2 dollari per milione di token di input e 6 dollari per milione di token di output — le stesse tariffe di Grok 4.6. Quel prezzo di input è la metà dei 4 dollari di GPT-5.6 Sol e un quinto dei 10 dollari di Fable 5.1. Sul lato output, Grok 4.7 applica 6 dollari, contro i 20 doll di Sol e i 50 dollari di Fable, ovvero circa un ottavo della tariffa di Anthropic. Le tariffe per milione di token sono il metodo standard di fatturazione dei fornitori di API — i token di input coprono ciò che un modello legge, quelli di output ciò che scrive — quindi questi prezzi di listino sono i valori che gli sviluppatori valutano quando scelgono tra modelli all'avanguardia.
xAI ha inoltre messo a confronto i punteggi di CursorBench 4.0 con il costo medio per attività completata, sostenendo che il modello si collochi sulla frontiera prezzo-prestazioni. Grok 4.7 raggiunge circa il 46% in quel grafico a circa 6 dollari per attività, mentre Claude Opus 5 richiede una spesa quasi doppia per ottenere un risultato simile. Fable 5.1 performa meglio con budget più elevati, salendo fino al 51,8% a circa 17 dollari per attività.
Elon Musk ha descritto il rilascio come "a strong combination of intelligence, speed & low cost" in un post su X.
Anthropic mantiene il vantaggio nei test su terminale e programmazione
Grok 4.7 si è classificato secondo dietro a Fable 5.1 su GDPval e sul test di lavoro d'ufficio AA Briefcase, e il modello di Anthropic conserva un chiaro vantaggio nei benchmark più lunghi di programmazione e terminale. Il margine più ampio si registra su Terminal-Bench 4.0, dove Fable 5.1 ha ottenuto il 57,9% contro il 38,0% di Grok 4.7 — un divario di circa 20 punti. Fable guida anche su CursorBench e su HealthBench Professional per il ragionamento clinico, dove GPT-5.6 Sol batte a sua volta Grok.
Grok 4.7 ha ottenuto 1.695 Elo su GDPval, un benchmark che misura i modelli su attività svolte da avvocati, infermieri e analisti finanziari, in crescita rispetto agli 1.605 di Grok 4.6. Questo dato resta indietro rispetto agli 1.735 di Fable 5.1, ma si colloca sopra gli 1.542 registrati dal più recente GPT-6 Astra di OpenAI nello stesso grafico. Le classifiche Elo, adattate dagli scacchi, ordinano i modelli in base ai risultati relativi piuttosto che ai punteggi percentuali grezzi.
Nel complesso, Grok 4.7 è avanti rispetto a GPT-5.6 Sol su cinque dei sette benchmark, perdendo solo su DeepSWE e sul test clinico.
Un modello più grande addestrato con dati di SpaceX
Grok 4.7 gira su 2,1 trilioni di parametri, il 40% in più rispetto ai 1,5 trilioni che alimentano Grok 4.6. xAI ha aggiunto dati di addestramento supplementari di SpaceX, inclusi la telemetria dei satelliti Starlink e i registri di produzione, e sostiene che il nuovo modello sia anche più propenso del suo predecessore a dedicare tempo extra ai problemi più impegnativi e a ricontrollare le proprie risposte.
Il modello è stato lanciato sull'app Grok, su Cursor, Grok Build e sull'API di xAI, senza lista d'attesa.
Tutte le cifre riportate provengono dai test interni di xAI e non da verifiche indipendenti. CursorBench, il benchmark alla base del grafico prezzo-prestazioni di xAI, è realizzato da Cursor, cui SpaceX ha completato l'acquisizione il mese scorso. xAI ha confrontato Grok 4.7 con GPT-5.6 Sol, mentre il più recente GPT6 Astra di OpenAI compare solo nei confronti GDPval, AA Briefcase ed EEBench. Le valutazioni di terze parti saranno il primo controllo esterno su questi margini.

