Corte d'appello USA conferma la vittoria storica di Thomson Reuters sul copyright nell'IA contro ROSS Intelligence
Punti chiave
- •Una corte d'appello statunitense ha confermato la vittoria di Thomson Reuters sul copyright contro ROSS Intelligence, respingendo la difesa del fair use per l'uso di materiale Westlaw nell'addestramento di un motore di ricerca legale basato sull'IA.
- •Il giudice Stephanos Bibas ha accertato che ROSS ha violato 2.243 headnote di Westlaw, entrate nei suoi dati di addestramento tramite quasi 25.000 Bulk Memos forniti dal fornitore LegalEase dopo il rifiuto di una richiesta di licenza diretta.
- •Il ragionamento della corte si applica solo all'IA non generativa, e l'Ufficio del Copyright statunitense considera il fair use per l'addestramento dell'IA generativa fortemente dipendente dai fatti specifici.
- •L'Ufficio del Copyright statunitense sostiene lo sviluppo di mercati di licenza volontari prima che il Congresso valuti misure di licenza obbligatoria, sebbene la licenza su scala di addestramento dell'IA possa essere costosa e complessa.
- •Mentre gli Stati Uniti risolvono le controversie sul copyright dell'IA tramite contenziosi caso per caso, l'Europa sta costruendo infrastrutture di opt-out ai sensi dell'articolo 4 della Direttiva DSM del 2019, incluso uno studio di fattibilità per un registro a livello UE pubblicato nel luglio 2026.
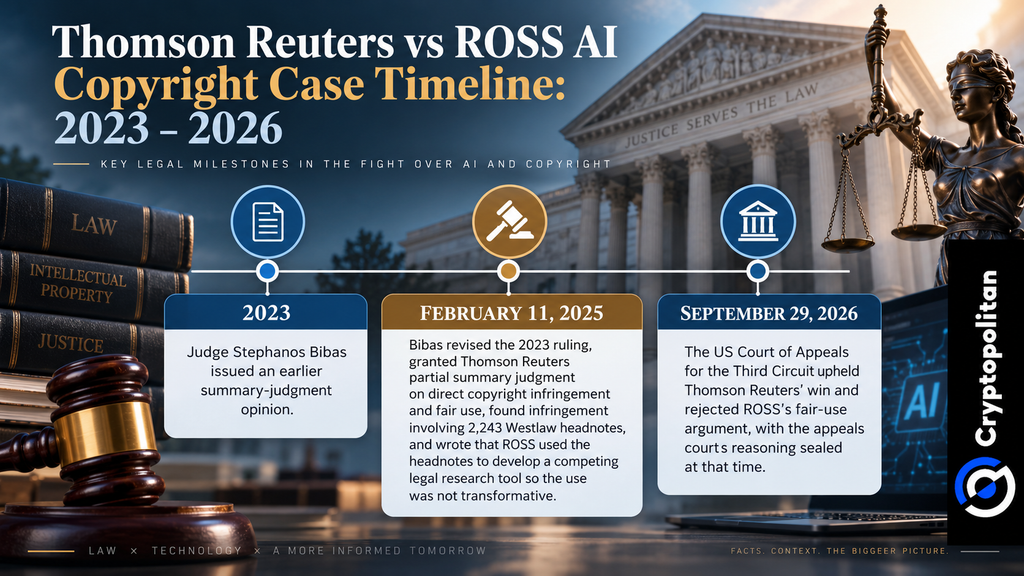
Una corte d'appello statunitense ha confermato la vittoria di Thomson Reuters in materia di copyright contro ROSS Intelligence, respingendo la difesa del fair use dell'azienda di ricerca giuridica relativa all'uso di materiale Westlaw — il servizio di ricerca legale di Thomson Reuters — per addestrare un motore di ricerca legale basato sull'IA, come riportato da Reuters il 29 settembre.
La sentenza potrebbe avere implicazioni ben oltre il campo della ricerca giuridica. Se le aziende di IA dovessero in definitiva pagare di più per i dati utilizzati per addestrare i propri sistemi, l'accesso a contenuti proprietari di alta qualità potrebbe diventare un ulteriore vantaggio competitivo riservato alle aziende con i budget maggiori.
La sentenza, riesaminata
L'11 febbraio 2025, il giudice Stephanos Bibas ha riesaminato la sua precedente decisione del 2023 e l'ha in gran parte confermata, assicurando a Thomson Reuters una vittoria sulle proprie rivendicazioni di violazione diretta e fair use.
ROSS aveva inizialmente richiesto un accordo di licenza per i contenuti Westlaw, ma la richiesta era stata respinta poiché l'azienda era in diretta concorrenza con Thomson Reuters. ROSS ha in seguitoito quasi 25.000 "Bulk Memos" dal fornitore terzo LegalEase, creati sulla base delle headnote di Westlaw — sintesi redazionali dei principi giuridici contenuti nelle sentenze. Il giudice Bibas ha stabilito che la violazione oggetto del procedimento riguardava 2.243 di tali headnote.
"Ross ha utilizzato le headnote per facilitare lo sviluppo di uno strumento di ricerca giuridica concorrente. Pertanto, l'uso di Ross non è trasformativo." — Giudice Stephanos Bibas
Perché questa non è un divieto generalizzato all'addestramento dell'IA
Comprendere questa distinzione è essenziale: ROSS ha sviluppato un motore di ricerca legale e non un modello linguistico generativo di grandi dimensioni. Bibas ha chiarito che il ragionamento della corte si applica "solo all'IA non generativa".
Anche l'Ufficio del Copyright statunitense ha assunto la posizione secondo cui il fair use nel contesto dell'IA generativa dipende in larga misura dai fatti di ciascun caso. La sua analisi valuta il materiale utilizzato, come è stato ottenuto, le ragioni della copiatura e l'effetto dell'uso sul valore dell'opera originale.
Di conseguenza, pur trattandosi di una decisione significativa, il caso ROSS non può essere generalizzato in modo ampio ad altre controversie sull'addestramento dell'IA.
Chi paga il conto delle licenze
L'Ufficio del Copyright sostiene la formazione di mercati di licenza volontari prima che il Congresso passi a misure obbligatorie, riconoscendo al contempo che la licenza su scala di addestramento dell'IA può essere costosa e amministrativamente complessa.
L'onere finanziario potrebbe non ripartirsi in modo uniforme tra le aziende. Secondo l'OCSE, il controllo rigoroso di dati, potenza di calcolo e altri input critici conferisce un vantaggio decisivo agli attori già dominanti.
L'attuale scala del mercato è notevole. Secondo Goldman Sachs, gli investimenti globali nell'intelligenza artificiale dovrebbero raggiungere circa 1.000 miliardi di dollari entro il 2026, di cui 581 miliardi solo negli Stati Uniti.
Cryptopolitan ha anche riportato la battaglia sul copyright relativa a OpenAI e Microsoft, mostrando come licenze e fair use stiano diventando questioni aziendali centrali in tutta l'industria dell'IA.
Due continenti, dueie
Gli Stati Uniti risolvono in gran parte queste controversie attraverso contenziosi caso per caso sul fair use. L'Europa, al contrario, sta costruendo un diverso livello di infrastrutture.
Ai sensi dell'articolo 4 della Direttiva DSM del 2019, i titolari dei diritti possono riservare le proprie opere al text and data mining. Nel luglio 2026, la Commissione europea ha pubblicato uno studio di fattibilità per un registro a livello UE che potrebbe aiutare gli sviluppatori di IA a identificare tali opt-out tramite fingerprint, identificatori e metadati.
Per il momento, le questioni che ROSS ha lasciato irrisolte — come si applica il fair use all'addestramento dell'IA generativa e se il concetto di registro UE andrà oltre lo studio di fattibilità — restano quelle da seguire.

