ChatGPT Images 2.5 vs. Nano Banana 2: confronto in sei categorie
Punti chiave
- •ChatGPT Images 2.5 ha pareggiato con Nano Banana 2, ottenendo tre vittorie di categoria ciascuno nel confronto.
- •OpenAI afferma che il nuovo modello può ridurre la latenza di generazione delle immagini fino al 50% rispetto a Images 2.0.
- •Il test ha rilevato che ChatGPT Images 2.5 non mostrava più la dominante gialla né l’eccessiva nitidezza presenti nelle generazioni precedenti.
- •Nano Banana 2 ha vinto il test sulle scritte dense e quello sulla cronologia di Bitcoin, dopo che ChatGPT Images 2.5 aveva commesso errori ortografici e relativi alle date.
- •OpenAI ha aggiunto Sketch, la condivisione dei prompt, commenti regionali, modelli di formato e i nuovi livelli di qualità API high e max.
OpenAI ha lanciato ChatGPT Images 2.5 l’8 settembre, promettendo dettagli più nitidi, texture più ricche, un’illuminazione più naturale, editing più preciso e una latenza di generazione delle immagini fino al 50% inferiore rispetto a Images 2.0.
In un confronto in sei categorie, Nano Banana 2 ha vinto tre prove e ChatGPT Images 2.5 le altre tre. I risultati sono stati determinati meno da differenze evidenti nella qualità che da piccoli errori verificabili, tra cui un errore ortografico e una data errata in un’infografica basata sulla ricerca.
OpenAI afferma che la latenza è diminuita fino al 50% rispetto a Images 2.0. L’azienda ha inoltre aggiunto due modelli API: GPT-Image-2.5 Flare, l’impostazione predefinita veloce, e GPT-Image-2.5 Sunburst, progettato per una precisione di editing avanzata.
Il confronto segue un test precedente pubblicato a maggio, quando GPT Image 2 e Nano Banana 2 si erano alternati nelle vittorie in otto categorie. GPT Image 2 aveva vinto più categorie, ma sviluppava un caratteristico artefatto di eccessiva nitidezza quando i prompt contenevano numerosi vincoli simultanei. Questo aveva sollevato una domanda per il modello successivo: OpenAI sarebbe riuscita a risolvere il problema?
Per questa tornata, lo stesso valutatore ha utilizzato sei categorie riprese o adattate dai test precedenti e ha sottoposto gli stessi prompt a entrambi i modelli. Il modello di Google era Nano Banana 2, il nome utilizzato dall’azienda per Gemini 3.1 Flash Image, e non il più lento e metodico Nano Banana Pro. Il test ha quindi messo a confronto il nuovo modello veloce e orientato alla precisione di OpenAI con l’offerta equivalente di Google.
Cosa è cambiato in GPT-Image-2.5
I modelli di immagini di OpenAI sono stati in passato associati a difetti caratteristici. Il modello alla base dell’originale GPT Image 1 aveva sviluppato una persistente dominante gialla e calda, che gli utenti avevano soprannominato “piss filter”. OpenAI non aveva mai spiegato né corretto completamente quella dominante.
GPT Image 2 aveva sostituito quel problema con un altro: i prompt contenenti troppi vincoli sovrapposti potevano produrre immagini eccessivamente nitide, piene di artefatti marcati e dall’aspetto sovraelaborato.
Nessuno dei due problemi è comparso in questo test. Le immagini generate con ChatGPT Images 2.5 hanno mantenuto equilibrio cromatico e dettagli anche alla massima complessità del prompt. La dominante gialla e l’eccessiva nitidezza presenti nelle due generazioni precedenti erano assenti. Il miglioramento è risultato particolarmente evidente nei test steampunk e dei ritratti, che hanno prodotto le immagini di ChatGPT fotograficamente più coerenti tra le tre generazioni esaminate.
OpenAI ha inoltre introdotto funzioni per il flusso di lavoro che non emergono da un semplice confronto tra immagini. Sketch consente agli utenti di disegnare direttamente in ChatGPT un layout approssimativo da usare come riferimento per la generazione. Le altre aggiunte includono la condivisione dei prompt, commenti integrati su specifiche aree dell’immagine e modelli di formato per poster e merchandising. Nell’API, i livelli di qualità ora si estendono da low ai nuovi livelli high e max, oltre il punto massimo raggiunto da Images 2.0.
Ecco come si sono comportati i due modelli nelle sei categorie.
Densità delle scritte: la scena di Kellerman’s Hardware
Il primo test rappresentava un incrocio urbano degradato alle 2 di notte, in cui quasi ogni superficie conteneva testo leggibile: un’insegna fantasma, graffiti spray, scritte sulle vetrine, un poster di un concerto strappato, un marciapiede con stencil e un telefono pubblico coperto di adesivi.
Nano Banana 2 ha riprodotto quasi tutto il testo in modo pulito. L’errore principale era un adesivo sul telefono pubblico che ripeteva il proprio testo in forma confusa, un difetto minore e facilmente trascurabile.
ChatGPT Images 2.5 ha incluso un dettaglio omesso da Nano Banana 2: un lampione coperto da volantini sovrapposti e fissati con punti metallici, strappati e rovinati come richiesto dal prompt. Tuttavia, la sua scritta di street art sembrava riportare “STILLL HERE”, con una L in più. Anche l’apostrofo in “KELLERMAN’S” sull’insegna fantasma era assente o illeggibile.
Sebbene OpenAI abbia prodotto nel complesso la scena più realistica, ha commesso due errori distinti di leggibilità in un test incentrato sulla resa precisa del testo. Nano Banana 2 ha vinto la categoria.
Vincitore: Nano Banana 2
Consapevolezza spaziale: la torre dell’orologio steampunk
Questo test di composizione aerea richiedeva una scena con profondità su cinque piani, incentrata su una massiccia torre dell’orologio. I suoi quadranti avrebbero dovuto mostrare orari diversi usando numeri romani leggibili, mentre altri sei elementi testuali erano distribuiti dal primo piano allo sfondo.
ChatGPT Images 2.5 ha creato un’immagine decisamente più atmosferica. Dai tetti saliva vapore visibile, un fiume attraversava il piano intermedio e la gamma tonale era più ricca sui cinque piani di profondità. Anche il testo era più facile da leggere.
Nano Banana 2 ha prodotto un’atmosfera più piatta. I suoi due quadranti visibili contenevano numeri romani leggibili—XII, III, VI e IX—ma le lancette erano posizionate in modo simile su entrambi gli orologi, contrariamente alla richiesta del prompt di mostrare orari diversi.
ChatGPT Images 2.5 ha vinto per aver seguito più fedelmente le istruzioni senza sacrificare il realismo.
Vincitore: ChatGPT Images 2.5
Illustrazione: la medium spirituale degli anime
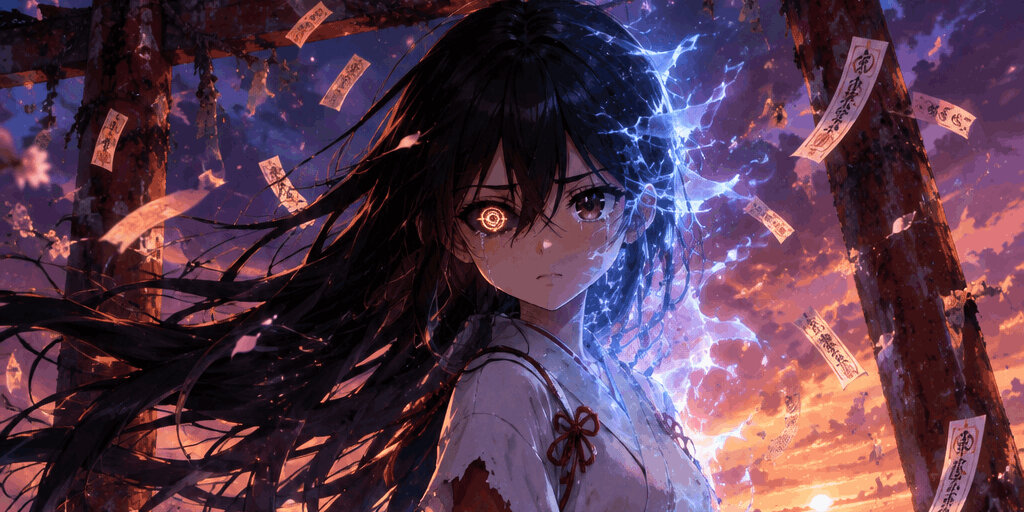
Il prompt chiedeva una key visual nello stile di Studio Ufotable, con una ragazza che si trasforma in energia spirituale davanti a un torii, accompagnata da una volpe kitsune a nove code sotto un cielo crepuscolare dipinto nello stile associato a Makoto Shinkai.
ChatGPT Images 2.5 ha prodotto il cielo migliore della serie di test. Includeva un disco solare visibile, un riflesso nell’acqua e una sagoma montuosa che sosteneva il paragone con Shinkai. Anche gli occhi asimmetrici del personaggio funzionavano bene.
Il modello è stato meno letterale nell’interpretare l’istruzione secondo cui la ragazza avrebbe dovuto “dissolversi nell’energia”. Ha reinterpretato l’idea come un effetto di scintille elettriche tra i capelli, anziché come la dissoluzione fluida e traslucida descritta nel prompt. La scia di energia bianco-azzurra e vaporosa di Nano Banana 2 era più vicina a quella specifica istruzione.
Nessuno dei due modelli ha creato una volpe a nove code convincente. ChatGPT Images 2.5 ha comunque vinto per l’impatto visivo complessivo.
Vincitore: ChatGPT Images 2.5
Realismo: l’architetta sul tetto
Questo ritratto cinematografico includeva numerosi vincoli indipendenti: un trench beige, occhiali rotondi, progetti tenuti specificamente nella mano sinistra, luce dell’ora dorata, profondità di campo ridotta e grana fotografica.
ChatGPT Images 2.5 ha prodotto una luce notevole, con il disco solare direttamente dietro il soggetto e un’eccellente micro-texture della pelle. La pelle era troppo liscia, ma l’ambiente circostante appariva altamente realistico, simile a una fotografia scattata con una macchina analogica.
L’aggiunta di istruzioni che normalmente ridurrebbero la qualità fotografica ha inaspettatamente aumentato il realismo dell’immagine. Una generazione utilizzava parole chiave tra cui “realistic, highlights, crushed shadows, uneven flash, blown out skin tones, candid moment, shot on a phone camera.”
Nano Banana 2 ha mantenuto una composizione più ampia e ha collocato i progetti nella mano destra del soggetto invece che in quella sinistra richiesta. Ha però aggiunto un’etichetta leggibile al progetto: “PROJECT: 124 DUANE ST”, un dettaglio omesso dalla maggior parte delle generazioni.
Nano Banana 2 ha vinto il confronto su una singola immagine, mentre ChatGPT Images 2.5 è stato giudicato più efficace nelle iterazioni ripetute.
Vincitore: Nano Banana 2 per una singola immagine; ChatGPT Images 2.5 per le iterazioni ripetute
Ricerca agentica: la cronologia di Bitcoin
Entrambe le piattaforme possono fare ricerche su un argomento prima di generare un’immagine. Il test chiedeva una cronologia della storia di Bitcoin in formato panoramico e nello stile di un disegno infantile, con un requisito rigoroso di accuratezza fattuale. Era la categoria più importante del confronto e quella in cui è emersa la maggiore distanza tra i modelli.
ChatGPT Images 2.5 ha generato un’infografica pulita su due righe, contenente numerose date specifiche, ma una era errata. Indicava il 2023 come l’anno in cui gli ETF su Bitcoin erano stati approvati negli Stati Uniti. La U.S. Securities and Exchange Commission ha approvato i primi ETF spot su Bitcoin il 10 gennaio 2024, un anno dopo. La fonte osservava che la discrepanza poteva riflettere un problema di interpretazione, poiché gli ETF sui futures erano stati approvati in quell’anno.
Nano Banana 2 ha prodotto una cronologia meno strutturata che rappresentava eventi simili. Il suo output utilizzava l’intervallo “2023–2024” per l’approvazione degli ETF e il quarto halving, invece di affermare un singolo anno errato. Di conseguenza, nessuna delle date indicate era tecnicamente falsa.
Nano Banana 2 ha vinto perché una data espressa con sicurezza ma errata è più significativa in un test progettato per valutare se il “ragionamento agentico” produca ricerche accurate.
Vincitore: Nano Banana 2
Concetti astratti: un prompt composto da parole inventate
L’ultimo prompt era costituito quasi interamente da termini inventati: “A woman eating shmfiyxl in Lyxin. Next to her, her Lymglsushing plays Lakishkark.” Il piatto, il luogo, il compagno e l’attività non avevano definizioni nel dizionario; ciascun modello doveva quindi inventarne il significato e decidere come rappresentarlo.
ChatGPT Images 2.5 ha inserito direttamente le parole senza senso nella scena come testo visibile. “Lyxin” appariva su un’insegna al neon sopra un ristorante elegante e futuristico, mentre “Lakishkark” era stampato sulla scatola di un gioco da tavolo a cui giocava il compagno alieno della donna. Trasformando i termini inventati in insegne leggibili, il modello li ha resi concreti anziché astratti.
Nano Banana 2 ha adottato un approccio diverso. Ha generato una scena calda e culturalmente specifica, con una bancarella di mercato guatemalteca, una donna che indossava un huipil tradizionale e una creatura simile a un orco che suonava uno strumento ibrido a corde e a fiato. Ha interpretato “plays” come suonare musica anziché giocare, una lettura diversa ma valida del prompt.
Tuttavia, nulla nell’immagine faceva riferimento nello specifico a “Lyxin” o “Lakishkark”, e nessuna delle due parole inventate appariva come testo visibile. ChatGPT Images 2.5 ha vinto perché trasformare concetti privi di definizione in etichette leggibili era la risposta più letterale a un prompt che non forniva significati prestabiliti.
Vincitore: ChatGPT Images 2.5
Il verdetto
Nano Banana 2 ha vinto tre delle sei categorie, lasciando il confronto sostanzialmente in parità. Il risultato dipende dalle aspettative dell’utente e dal modo in cui il modello viene utilizzato.
ChatGPT Images 2.5 ha risolto il problema dell’eccessiva nitidezza che affliggeva il suo predecessore. La sua illustrazione è stata probabilmente l’immagine singola più visivamente impressionante prodotta da uno dei due modelli nelle due tornate complete di test.
La scelta del modello dipende quindi dall’attività: le immagini ricche di testo e basate sulla ricerca attribuiscono maggiore importanza alla leggibilità precisa e alla verifica dei fatti, mentre i flussi di lavoro dedicati all’illustrazione e alle generazioni ripetute valorizzano punti di forza diversi emersi nel test. Il confronto non stabilisce un vincitore universale, ma mostra perché la valutazione dei modelli di immagini richieda più del giudizio su una singola immagine in base al suo impatto visivo.
La differenza principale non riguardava la qualità complessiva, ma una serie di piccoli dettagli verificabili: un errore ortografico in una scena ricca di scritte, un anno errato in un’infografica basata sulla ricerca e altre imprecisioni circoscritte nel seguire le istruzioni. Per estetica e qualità generale delle immagini, i due modelli erano ampiamente comparabili.

