Grok 4.7 de xAI surclasse les modèles d'Anthropic et d'OpenAI sur un benchmark d'agent juridique, pour une fraction du prix
Points clés
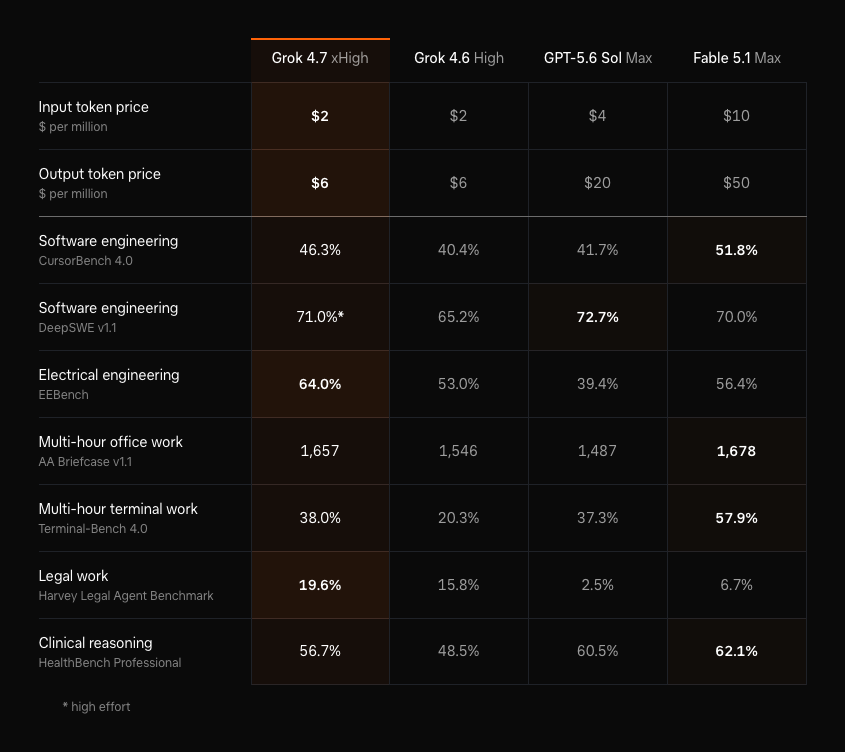
- •Grok 4.7 a obtenu 19,6 % sur le Harvey Legal Agent Benchmark, soit environ le triple de Fable 5.1 d'Anthropic à 6,7 % et près de huit fois les 2,5 % de GPT-5.6 Sol d'OpenAI.
- •Le modèle est tarifé à 2 $ par million de tokens d'entrée et 6 $ par million de tokens de sortie, ce qui situe son coût d'entrée à un cinquième des 10 $ de Fable 5.1 et à la moitié des 4 $ de GPT-5.6 Sol.
- •Fable 5.1 d'Anthropic conserve des avances substantielles sur les benchmarks de code et de terminal plus longs, remportant Terminal-Bench 4.0 avec environ 20 points de pourcentage d'avance sur Grok 4.7.
- •Grok 4.7 fonctionne avec 2 100 milliards de paramètres, soit 40 % de plus que son prédécesseur, et a été entraîné avec des données supplémentaires de SpaceX, notamment la télémétrie des satellites Starlink et des dossiers de fabrication.
- •Tous les chiffres de benchmark publiés proviennent des propres tests de xAI plutôt que d'une vérification indépendante, et le CursorBench derrière son graphique prix-performance est conçu par Cursor, récemment acquis par SpaceX.
xAI a lancé lundi Grok 4.7, un nouveau modèle phare qui a surpassé Fable 5.1 d'Anthropic et GPT-5.6 Sol d'OpenAI sur un benchmark d'agent juridique, tout en facturant un cinquième du prix de Fable 5.1 par token d'entrée.
Selon l'annonce de publication de xAI, Grok 4.7 a obtenu 19,6 % sur le Harvey Legal Agent Benchmark, où Fable 5.1 a atteint 6,7 % et GPT-5.6 Sol 2,5 %. Cela place Grok 4.7 à environ trois fois le score d'Anthropic et près de huit fois celui de Sol. Cryptopolitan rapportait le mois dernier que le précédent modèle de l'entreprise, Grok 4.6, dominait déjà ce duo avec 15,8 %. Le benchmark Harvey est maintenu par l'entreprise de technologies juridiques Harvey et évalue les modèles sur des travaux juridiques en plusieurs étapes, l'un des domaines professionnels où l'adoption de l'IA agentique est la plus scrutée.
Le travail juridique se distingue comme l'un des rares domaines où Grok 4.7 surpasse nettement ses deux concurrents. Le modèle devance également Fable 5.1 sur le test d'ingénierie électrique EEBench et le dépasse de justesse sur le benchmark de code DeepSWE.
Tarification et rapport prix-performance
Grok 4.7 est proposé à 2 $ par million de tokens d'entrée et 6 $ par million de tokens de sortie — les mêmes tarifs que Grok 4.6. Ce prix d'entrée représente la moitié des 4 $ de GPT-5.6 Sol et un cinquième des 10 $ de Fable 5.1. En sortie, Grok 4.7 facture 6 $, contre 20 $ pour Sol et 50 $ pour Fable, soit environ un huitième du tarif d'Anthropic. Les tarifs par million de tokens constituent le mode de facturation standard des fournisseurs d'API — les tokens d'entrée couvrent ce que le modèle lit, les tokens de sortie ce qu'il rédige — si bien que ces prix affichés sont les chiffres que les développeurs comparent lorsqu'ils choisissent entre des modèles de pointe.
xAI a également confronté les scores de CursorBench 4.0 au coût moyen par tâche achevée et affirme que le modèle se situe sur la frontière prix-performance. Grok 4.7 atteint environ 46 % sur ce graphique à environ 6 $ par tâche, tandis que Claude Opus 5 nécessite presque le double de dépenses pour un résultat similaire. Fable 5.1 performe mieux avec des budgets plus élevés, grimpant à 51,8 % à environ 17 $ par tâche.
Elon Musk a décrit cette publication comme « a strong combination of intelligence, speed & low cost » dans une publication sur X.
Anthropic conserve l'avance sur les tests de terminal et de code
Grok 4.7 s classé deuxième derrière Fable 5.1 sur GDPval et sur le test de travail de bureau AA Briefcase, et le modèle d'Anthropic conserve une avance nette sur les benchmarks de code et de terminal plus longs. L'écart le plus important concerne Terminal-Bench 4.0, où Fable 5.1 a obtenu 57,9 % contre 38,0 % pour Grok 4.7 — un écart d'environ 20 points. Fable domine également CursorBench et HealthBench Professional en raisonnement clinique, où GPT-5.6 Sol bat aussi Grok.
Grok 4.7 a obtenu un Elo de 1 695 sur GDPval, un benchmark qui mesure les modèles sur des tâches effectuées par des avocats, des infirmiers et des analystes financiers, en hausse par rapport aux 1 605 de Grok 4.6. Cela reste derrière le total de 1 735 de Fable 5.1, mais devant les 1 542 enregistrés par le plus récent GPT-6 Astra d'OpenAI sur le même graphique. Les classements Elo, adaptés des échecs, hiérarchisent les modèles selon leurs résultats relatifs plutôt que selon des scores bruts en pourcentage.
Au global, Grok 4.7 est devant GPT-5.6 Sol sur cinq des sept benchmarks, ne cédant que sur DeepSWE et le test clinique.
Un modèle plus vaste entraîné avec des données de SpaceX
Grok 4.7 fonctionne avec 2 100 milliards de paramètres, soit 40 % de plus que les 1 500 milliards qui alimentent Grok 4.6. xAI a ajouté des données d'entraînement supplémentaires de SpaceX, notamment la télémétrie des satellites Starlink et des dossiers de fabrication, et indique que le nouveau modèle est également plus enclin que son prédécesseur à consacrer plus de temps aux problèmes ardu et à revérifier ses propres réponses.
Le modèle a été lancé sur l'application Grok, Cursor, Grok Build et l'API de xAI, sans liste d'attente.
Tous les chiffres ci-dessus proviennent des propres tests de xAI plutôt que d'une vérification indépendante. CursorBench, le benchmark derrière le graphique prix-performance de xAI, est conçu par Cursor, dont SpaceX a achevé l'acquisition le mois dernier. xAI a comparé Grok 4.7 à GPT-5.6 Sol, tandis que le plus récent GPT-6 Astra d'OpenAI n'apparaît que dans les comparaisons GDPval, AA Briefcase et EEBench. Les évaluations par des tiers constitueront la première vérification externe de ces marges.

