Vitalik Buterin, cofondateur d'Ethereum, estime que l'IA locale peut protéger la vie privée sans sacrifier la vitesse, mais les portefeuilles exigent encore des contrôles stricts
Points clés
- •La publication de Buterin marque une évolution par rapport à sa vision d'avril : les modèles locaux sur ordinateur portable peuvent désormais servir d'interface principale pour une part plus importante des tâches, au-delà des travaux étroitement délimités.
- •Les benchmarks sur son Strix Halo ont montré des taux de traitement des entrées de 109,82 à 373,22 tokens par seconde et une génération en sortie de 18,42 à 33,37 tokens par seconde sur 10 charges de travail.
- •Qwen3.8-Flash-Next, le modèle open weight d'Alibaba, est un modèle mixture-of-experts de 125 milliards de paramètres qui n'active que 6 milliards de paramètres par token, et il a surpassé le plus grand Qwen3.7-Plus sur 8 des 14 benchmarks.
- •Les benchmarks de capacité standards ne mesurent ni la résistance aux injections de prompts, ni l'autorisation de portefeuille, ni la justesse des actions financières autonomes, laissant le contrôle de l'IA sur les actifs crypto en suspens.
- •Les protections proposées incluent la règle d'approbation 2-sur-2 humain-plus-modèle de Buterin pour les transactions risquées, des limites de dépense définies par logiciel, le portefeuille Steward sur appareil financé par l'Ethereum Foundation, et le projet de norme EIP-7906 pour les assertions d'état post-transaction.
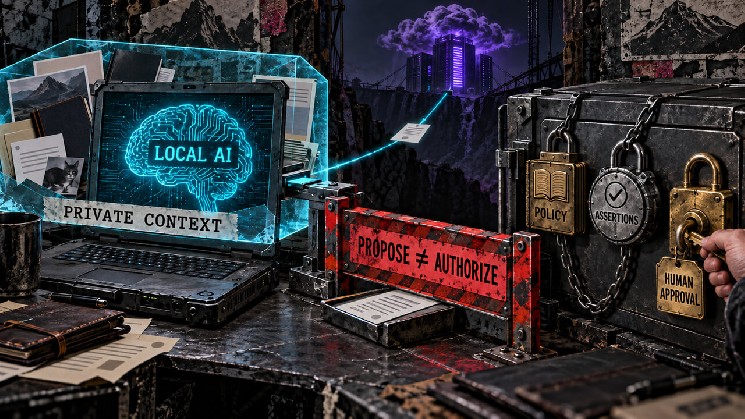
Vitalik Buterin, cofondateur d'Ethereum, estime que l'intelligence artificielle sur ordinateur portable approche d'un tournant pratique — même si les logiciels de portefeuille devront encore franchir un barrière bien plus élevée avant qu'une IA puisse se voir confier le contrôle d'actifs crypto.
Dans une publication du 17 septembre, Buterin a indiqué que Qwen 3.8 Flash et les récentes améliorations de llama.cpp — le projet open source d'exécution de grands modèles de langage directement sur du matériel local — avaient rapproché les modèles locaux de la capacité à traiter une « grande part » des tâches sur son ordinateur portable Strix Halo. Pour des travaux plus avancés, il a décrit un modèle local coordonnant les requêtes vers des systèmes distants plus puissants tout en retenant le contexte personnel complet de l'utilisateur.
Une image de benchmark jointe à la publication montrait 10 charges de travail. Les taux de traitement des entrées rapportés variaient de 109,82 à 373,22 tokens par seconde, tandis que la génération en sortie variait de 18,42 à 33,37 tokens par seconde. Ces chiffres appuient une affirmation pratique concernant la réactivité sur un ordinateur portable haut de gamme, mais ils laissent sans réponse le jugement du modèle, la résistance aux instructions malveillantes et l'autorisation des transactions.
L'inférence locale peut améliorer la confidentialité tant que le pouvoir de déplacer des fonds reste derrière des contrôles distincts et exécutoires.
Ce qui a changé entre avril et septembre
Dans un récit d'avril sur sa configuration d'IA locale, Buterin décrivait un rôle plus restreint pour les modèles sur ordinateur portable. Il écrivait que Qwen3.5:35B pouvait gérer des tâches délimitées et du travail de programmation familier, tandis que des agents indépendants avancés capables de poursuivre le travail sur une base de code restaient hors de portée pratique des ordinateurs portables. Le codage et le travail intellectuel plus difficiles requéraient encore des modèles distants plus puissants.
La publication de septembre déplace son évaluation de la frontière pratique. Un modèle local ne semble plus limité à la transcription, à la synthèse ou à d'autres travaux étroitement délimités. Dans la description plus récente, il peut servir d'interface principale pour une part plus importante des activités et décider quand un modèle distant est nécessaire. Un service distant ne reçoit que la question ou le contexte que le modèle local sélectionne — et non chaque fichier, message et détail de portefeuille nécessaires pour comprendre la situation plus large de l'utilisateur. Le système local devient à la fois gardien de l'information et assistant.
Avril et septembre impliquaient des générations de modèles et des tâches différents La publication de septembre fournit des comptes de tokens et des débits, mais omet le contenu des prompts, les choix de quantization et la configuration d'exécution complète.
Qwen3.8-Flash-Next, publié par l'équipe Qwen d'Alibaba, est un modèle multimodal open weight de type mixture-of-experts. Son modèle principal compte 125 milliards de paramètres, auxquels s'ajoutent 51 milliards de paramètres dans des tables d'embedding n-gram, avec 6 milliards de paramètres activés par token. La distribution open weight signifie que le modèle peut être téléchargé et exécuté entièrement sur la machine de l'utilisateur — la configuration qui rend possible une inférence locale et privée. Le dépôt officiel documente l'inférence locale de texte et de vision via llama.cpp à l'aide de builds GGUF quantizés.
L'activation d'une fraction du modèle pour chaque token réduit la charge de calcul. L'utilisateur a néanmoins besoin de suffisamment de mémoire pour le build et le contexte choisis, et les documents officiels ne fournissent aucun minimum matériel unique applicable à tous les niveaux de quantization et à toutes les charges de travail.
Les benchmarks de capacité laissent la question de l'autorité sur les portefeuilles en suspens
Le rapport technique de Qwen évalue le modèle de base sur 14 benchmarks couvrant les connaissances générales, les mathématiques, les sciences, le raisonnement, le codage et la compréhension multilingue. L'équipe Qwen a rapporté que Flash-Next a surpassé le modèle de base plus grand Qwen3.7-Plus sur huit de ces tests tout en utilisant moins de paramètres activés et moins de calcul d'entraînement.
Le rapport couvre la capacité du modèle, l'efficacité et la stabilité de l'entraînement. La résistance aux injections de prompts, l'application des politiques, l'autorisation de portefeuille et la justesse des actions financières autonomes sont en dehors de cet ensemble de benchmarks.
Un assistant peut expliquer une transaction en privé, préparer des calldata ou suggérer une route. Un signataire peut faire une requête irréversible qui transfère des actifs ou accorde à un autre contrat la permission de les déplacer. Un meilleur raisonnement réduit certaines erreurs, mais une instruction malveillante cachée dans un site web, un message ou une description de transaction peut toujours détourner le plan du modèle.
L'écosystème Ethereum teste déjà une version sur appareil du concept d'assistant. Dans sa mise à jour d'allocation du deuxième trimestre, l'Ethereum Foundation a listé Steward, un portefeuille de smart accounts entièrement local sur macOS dont le light client et l'assistant IA sont conçus pour fonctionner sur l'appareil. Cette annonce établit le financement et le périmètre du projet, mais laisse indéterminés le déploiement en production, le statut d'audit indépendant et l'autorité sur les transactions autonomes. Ces points ouverts sont les indicateurs à surveiller à mesure que les assistants de portefeuille sur appareil passent des annonces de financement aux logiciels réels.
Les conseils d'avril de Buterin sur les portefeuilles plaçaient cette autorité en dehors du modèle de langage. Il décrivait un pare-feu de confirmation humaine pour les actions risquées, des limites déterministes sur les montants, les calldata et le nombre de transactions, ainsi qu'une règle 2-sur-2 associant humain et modèle. Le modèle peut reconnaître un schéma d'arnaque qu'une personne distraite manquerait, tandis qu'une personne peut rejeter une action après que du contenu malveillant a manipulé le modèle. Exiger les deux approbations pour transactions risquées empêche l'un ou l'autre participant de devenir discrètement l'unique point d'ancrage de confiance.
L'automatisation à faible risque peut rester disponible dans le cadre de permissions définies par logiciel. Lire des soldes, préparer des transactions non signées ou opérer sous des limites strictement plafonnées peut rendre un assistant utile sans lui donner un pouvoir de dépense illimité.
La confiance dans les portefeuilles dépend de règles que le modèle ne peut pas réécrire
L'EIP-7906, qui reste à l'état de projet, propose des cadres d'assertions post-transaction qui inspectent les différences d'état finales produites par une transaction. Une assertion peut rejeter le résultat de l'application lorsque ces changements violent une condition spécifiée.
Un portefeuille pourrait utiliser ce mécanisme pour exiger qu'un swap n'ait modifié que des soldes approuvés, qu'aucune approbation de token cachée n'ait apparue, ou que l'état d'un compte protégé soit resté intact. Ces vérifications comparent les effets réels de la transaction à des règles explicites.
Le projet décrit également les limites de cette protection. Une assertion qui vérifie trop peu peut créer une fausse confiance. La logique de validation du portefeuille doit exiger le cadre d'assertion prévu, et l'assertion elle-même doit couvrir chaque changement d'état pertinent pour l'opération protégée.
L'inférence locale et les assertions de transaction résolvent des parties différentes du problème de l'agent de portefeuille. Le modèle local protège le contexte et transforme l'intention en langage naturel en action proposée ; les permissions déterministes restreignent les destinataires, les contrats, les montants et la fréquence ; les assertions inspectent les changements d'état finaux. La confirmation humaine reste le second facteur pour les actions risquées.
Le résultat de septembre sur ordinateur portable rend la première couche plus crédible. Il suggère qu'un modèle local privé peut répondre assez vite pour coordonner le travail quotidien et utiliser sélectivement l'intelligence distante. Les couches restantes portent toujours l'autorité qui protège les actifs.
Un portefeuille crypto peut traiter le modèle comme une interface, un planificateur et un moniteur compétents. La confiance appartient aux contrôles que le modèle ne peut pas altérer et à un chemin d'approbation qui maintient l'utilisateur véritablement aux commandes.
Source : CryptoSlate via CryptoNewsNet.

