ChatGPT Images 2.5 contre Nano Banana 2 : comparaison en six catégories
Points clés
- •ChatGPT Images 2.5 et Nano Banana 2 ont remporté chacun trois catégories dans la comparaison.
- •OpenAI affirme que le nouveau modèle peut réduire jusqu’à 50 % la latence de génération d’images par rapport à Images 2.0.
- •Le test a montré que ChatGPT Images 2.5 ne présentait plus la dominante jaune ni la forte suraccentuation observées dans les générations précédentes.
- •Nano Banana 2 a remporté le test de lettrage dense et celui de la chronologie du Bitcoin après des erreurs d’orthographe et de date de ChatGPT Images 2.5.
- •OpenAI a ajouté Sketch, le partage de prompts, les commentaires régionaux, des modèles de format ainsi que de nouveaux niveaux de qualité high et max dans l’API.
OpenAI a lancé ChatGPT Images 2.5 le 8 septembre, promettant des détails plus nets, des textures plus riches, un éclairage plus naturel, un montage plus précis et une latence de génération d’images jusqu’à 50 % inférieure à celle d’Images 2.0.
Lors d’une comparaison en six catégories, Nano Banana 2 a remporté trois tests et ChatGPT Images 2.5 les trois autres. Les résultats ont été départagés moins par des différences évidentes de qualité que par de petites erreurs vérifiables, notamment une faute d’orthographe et une date incorrecte dans une infographie fondée sur la recherche.
OpenAI affirme que la latence a diminué jusqu’à 50 % par rapport à Images 2.0. L’entreprise a également ajouté deux modèles à son API : GPT-Image-2.5 Flare, le modèle rapide par défaut, et GPT-Image-2.5 Sunburst, conçu pour une précision supérieure en matière de retouche.
Cette comparaison fait suite à un précédent test publié en mai, au cours duquel GPT Image 2 et Nano Banana 2 s’étaient partagé les victoires dans huit catégories. GPT Image 2 avait remporté davantage de catégories, mais produisait un artefact de suraccentuation caractéristique lorsque les prompts comportaient de nombreuses contraintes simultanées. Une question se posait donc pour le modèle suivant : OpenAI pouvait-il corriger ce problème ?
Pour ce nouveau test, le même évaluateur a utilisé six catégories reprises ou adaptées des précédents essais et soumis les mêmes prompts aux deux modèles. Le modèle de Google était Nano Banana 2, le nom donné par l’entreprise à Gemini 3.1 Flash Image, et non le plus lent et plus méthodique Nano Banana Pro. Le test comparait donc le nouveau modèle rapide et axé sur la précision d’OpenAI à l’offre équivalente de Google.
Les changements apportés à GPT-Image-2.5
Les modèles d’image d’OpenAI ont déjà été associés à des défauts caractéristiques. Le modèle à l’origine de GPT Image 1 avait développé une dominante jaune chaude persistante, surnommée par les utilisateurs « piss filter ». OpenAI n’a jamais complètement expliqué ni corrigé cette teinte.
GPT Image 2 avait remplacé ce problème par un autre : les prompts comportant trop de contraintes empilées pouvaient produire des images fortement suraccentuées, remplies d’artefacts très marqués et surtraités.
Aucun de ces deux problèmes n’est apparu dans ce test. Les images générées avec ChatGPT Images 2.5 ont conservé leur équilibre colorimétrique et leurs détails, même avec des prompts très complexes. La dominante jaune et la suraccentuation excessive observées dans les deux générations précédentes étaient absentes. L’amélioration était particulièrement visible dans les tests de la scène steampunk et du portrait, qui ont produit les images ChatGPT les plus cohérentes sur le plan photographique parmi les trois générations évaluées.
OpenAI a également introduit des fonctions de flux de travail qui ne sont pas prises en compte dans une simple comparaison d’images. Sketch permet aux utilisateurs de dessiner directement dans ChatGPT une ébauche de mise en page servant de référence pour la génération. Parmi les autres ajouts figurent le partage de prompts, les commentaires intégrés sur des zones précises d’une image et des modèles de format pour les affiches et les produits dérivés. Dans l’API, les niveaux de qualité vont désormais de low à de nouveaux réglages high et max, au-delà du niveau maximal d’Images 2.0.
Voici les performances des deux modèles dans les six catégories.
Densité du lettrage : la scène de la quincaillerie Kellerman’s
Le premier test représentait une intersection sinistre à 2 heures du matin, où presque chaque surface comportait du texte lisible : une enseigne fantôme, des graffitis peints à la bombe, le lettrage d’une devanture en vinyle, une affiche de concert déchirée, une bordure de trottoir pochoirisée et un téléphone public couvert d’autocollants.
Nano Banana 2 a rendu presque tout le texte proprement. Sa principale erreur concernait un autocollant du téléphone public, qui répétait son propre texte de manière brouillée, une imperfection mineure et facile à manquer.
ChatGPT Images 2.5 a inclus un détail omis par Nano Banana 2 : un lampadaire couvert de prospectus superposés et agrafés, déchirés et usés comme le demandait le prompt. En revanche, son tag de street art semblait afficher « STILLL HERE », avec un L supplémentaire. L’apostrophe de « KELLERMAN’S » sur l’enseigne fantôme était également absente ou illisible.
Bien qu’OpenAI ait produit la scène la plus réaliste dans l’ensemble, le modèle a commis deux erreurs distinctes de lisibilité dans un test consacré au rendu précis du texte. Nano Banana 2 a remporté la catégorie.
Vainqueur : Nano Banana 2
Conscience spatiale : la tour d’horloge steampunk
Ce test de composition aérienne exigeait une scène avec cinq plans de profondeur mettant en scène une immense tour d’horloge. Ses cadrans devaient afficher des heures différentes en chiffres romains lisibles, tandis que six autres éléments textuels étaient répartis de l’avant-plan à l’arrière-plan.
ChatGPT Images 2.5 a créé une image nettement plus atmosphérique. De la vapeur s’élevait visiblement des toits, une rivière traversait le plan intermédiaire et la gamme de tons était plus riche sur les cinq plans de profondeur. Le texte était également plus facile à lire.
Nano Banana 2 produisait une atmosphère plus plate. Ses deux cadrans visibles contenaient bien des chiffres romains lisibles — XII, III, VI et IX — mais les aiguilles étaient positionnées de manière similaire sur les deux horloges, contrairement à la demande du prompt, qui exigeait des heures différentes.
ChatGPT Images 2.5 a gagné en suivant plus précisément les instructions sans sacrifier le réalisme.
Vainqueur : ChatGPT Images 2.5
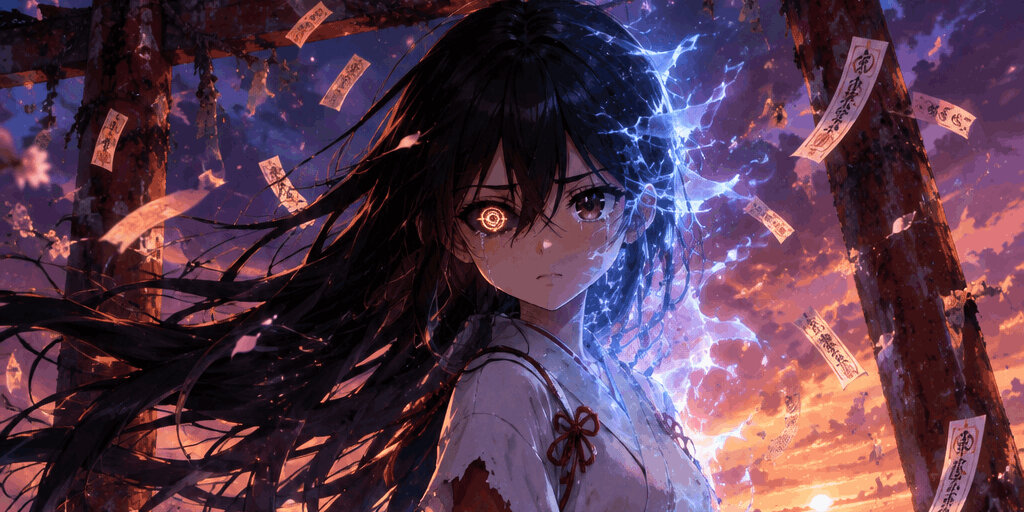
Illustration : la médium spirituelle d’anime
Le prompt demandait un visuel principal dans le style de Studio Ufotable, représentant une jeune fille se transformant en énergie spirituelle devant un torii, accompagnée d’un renard kitsune à neuf queues sous un ciel crépusculaire peint dans le style associé à Makoto Shinkai.
ChatGPT Images 2.5 a produit le meilleur ciel de la série de tests. L’image comportait un disque solaire visible, un reflet dans l’eau et une silhouette montagneuse qui justifiaient la comparaison avec Shinkai. Les yeux asymétriques du personnage fonctionnaient également très bien.
Le modèle s’est montré moins littéral concernant l’instruction demandant que la jeune fille se « dissolve en énergie ». Il a réinterprété cette idée sous la forme d’un effet de décharges électriques parcourant ses cheveux, plutôt que d’une dissolution fluide et translucide telle que décrite dans le prompt. La traînée d’énergie bleu-blanc vaporeuse de Nano Banana 2 correspondait davantage à cette instruction précise.
Aucun des deux modèles n’a créé de renard à neuf queues convaincant. ChatGPT Images 2.5 a néanmoins remporté la catégorie grâce à son impact visuel global.
Vainqueur : ChatGPT Images 2.5
Réalisme : l’architecte sur le toit
Ce portrait cinématographique comportait de nombreuses contraintes indépendantes : un trench beige, des lunettes rondes, des plans tenus précisément dans la main gauche, une lumière d’heure dorée, une faible profondeur de champ et du grain de pellicule.
ChatGPT Images 2.5 a produit une lumière remarquable, avec le disque solaire directement derrière le sujet et une excellente microtexture de la peau. La peau était trop lisse, mais l’environnement paraissait très réaliste, comme photographié avec un appareil argentique.
L’ajout d’instructions qui réduisent normalement la qualité photographique a paradoxalement accru le réalisme de l’image. Une génération utilisait notamment les mots-clés « realistic, highlights, crushed shadows, uneven flash, blown out skin tones, candid moment, shot on a phone camera ».
Nano Banana 2 a conservé une composition plus complète et placé les plans dans la main droite du sujet au lieu de la main gauche demandée. Il a toutefois ajouté une étiquette lisible au plan : « PROJECT: 124 DUANE ST », un détail omis par la plupart des rendus.
Nano Banana 2 a remporté la comparaison sur une image unique, tandis que ChatGPT Images 2.5 a été jugé plus performant lors des itérations répétées.
Vainqueur : Nano Banana 2 pour une image unique ; ChatGPT Images 2.5 pour les itérations répétées
Recherche agentique : la chronologie du Bitcoin
Les deux plateformes peuvent effectuer des recherches sur un sujet avant de générer une image. Le test demandait une chronologie panoramique de l’histoire du Bitcoin, dans le style d’un dessin d’enfant, avec une exigence stricte d’exactitude factuelle. Il s’agissait de la catégorie la plus importante de la comparaison et de celle qui a révélé l’écart le plus marqué entre les modèles.
ChatGPT Images 2.5 a généré une infographie claire en deux rangées, contenant de nombreuses dates précises, mais l’une d’elles était incorrecte. Le modèle indiquait que 2023 était l’année de l’approbation des fonds négociés en Bourse sur le Bitcoin aux États-Unis. La U.S. Securities and Exchange Commission a approuvé les premiers ETF spot sur le Bitcoin le 10 janvier 2024, soit un an plus tard. La source a indiqué que cette divergence pouvait s’expliquer par une question d’interprétation, puisque les ETF à terme avaient été approuvés cette année-là.
Nano Banana 2 a produit une chronologie moins structurée représentant des événements similaires. Sa sortie utilisait une période « 2023–2024 » pour l’approbation des ETF et le quatrième halving, au lieu d’affirmer une année incorrecte. Ainsi, aucune des dates indiquées n’était techniquement fausse.
Nano Banana 2 a gagné parce qu’une date erronée affirmée avec assurance est plus problématique dans un test destiné à évaluer la capacité du « raisonnement agentique » à produire des recherches exactes.
Vainqueur : Nano Banana 2
Concepts abstraits : un prompt composé de mots inventés
Le dernier prompt était presque entièrement composé de termes inventés : « A woman eating shmfiyxl in Lyxin. Next to her, her Lymglsushing plays Lakishkark. » Le plat, le lieu, le compagnon et l’activité n’avaient aucune définition dans un dictionnaire, laissant chaque modèle inventer leur signification et décider comment les représenter.
ChatGPT Images 2.5 a intégré les mots absurdes directement dans la scène sous forme de texte visible. « Lyxin » apparaissait sur une enseigne au néon au-dessus d’un restaurant élégant et futuriste, tandis que « Lakishkark » était imprimé sur la boîte d’un jeu de société auquel jouait le compagnon extraterrestre de la femme. En transformant les termes inventés en enseignes lisibles, le modèle les rendait concrets plutôt qu’abstraits.
Nano Banana 2 a adopté une approche différente. Il a généré une scène chaleureuse et culturellement marquée, avec un étal de marché guatémaltèque, une femme portant un huipil traditionnel et une créature ressemblant à un orc jouant d’un instrument hybride à cordes et à vent. Le modèle a interprété « plays » comme le fait de jouer de la musique plutôt que de jouer à un jeu, une lecture différente mais valide du prompt.
Cependant, rien dans l’image ne faisait spécifiquement référence à « Lyxin » ou à « Lakishkark », et aucun de ces mots inventés n’apparaissait sous forme de texte visible. ChatGPT Images 2.5 a gagné parce que transformer des concepts indéfinis en étiquettes lisibles constituait la réponse la plus littérale à un prompt ne fournissant aucune signification établie.
Vainqueur : ChatGPT Images 2.5
Le verdict
Nano Banana 2 a remporté trois des six catégories, laissant la comparaison pratiquement à égalité. Le résultat dépend des attentes de l’utilisateur et de la manière dont le modèle est utilisé.
ChatGPT Images 2.5 a corrigé le problème de suraccentuation qui affectait son prédécesseur. Son illustration était probablement l’image unique la plus impressionnante visuellement produite par l’un ou l’autre modèle au cours des deux séries complètes de tests.
Le choix du modèle dépend donc de la tâche : les images riches en texte et fondées sur la recherche accordent davantage de poids à la lisibilité exacte et à la vérification factuelle, tandis que l’illustration et les flux de génération répétée mettent en avant d’autres points forts observés dans ce test. La comparaison ne désigne pas de vainqueur universel, mais elle montre pourquoi l’évaluation des modèles d’image exige davantage que le jugement d’une seule image sur son attrait visuel.
La principale différence ne concernait pas la qualité globale, mais une série de petits détails vérifiables : une faute d’orthographe dans une scène riche en lettrage, une année incorrecte dans une infographie fondée sur la recherche et d’autres erreurs limitées de suivi des instructions. En matière d’esthétique globale et de qualité d’image, les deux modèles étaient largement comparables.

