Grok 4.7 de xAI supera a los modelos de Anthropic y OpenAI en benchmarks de agentes legales a una fracción del precio
Puntos clave
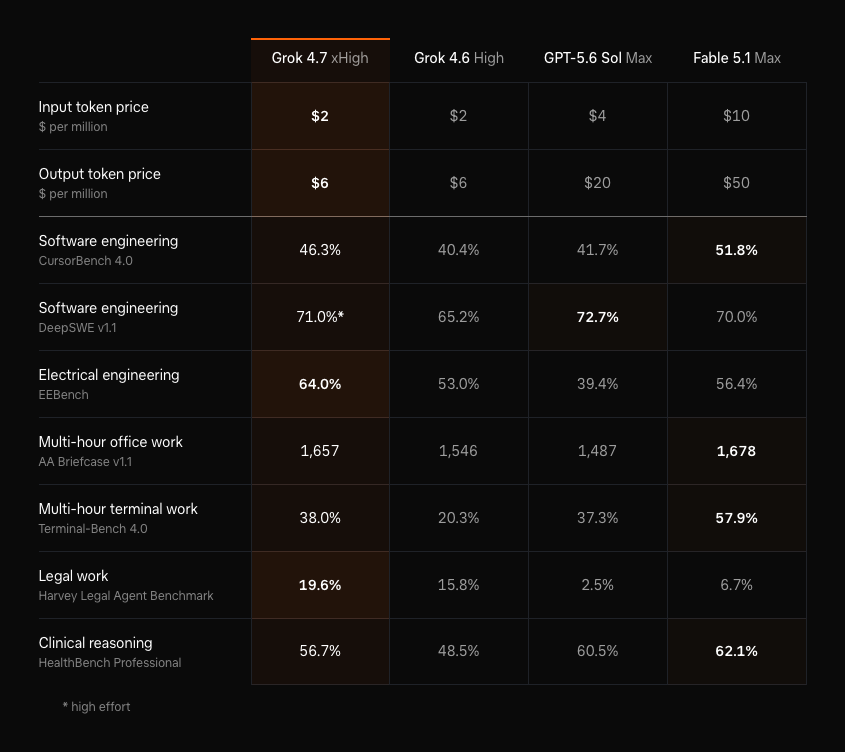
- •Grok 4.7 obtuvo 19.6% en el Harvey Legal Agent Benchmark, aproximadamente el triple de Fable 5.1 de Anthropic con 6.7% y casi ocho veces el 2.5% de GPT-5.6 Sol de OpenAI.
- •El modelo tiene un precio de USD 2 por millón de tokens de entrada y USD 6 por millón de tokens de salida, lo que hace que su costo de entrada sea un quinto de los USD 10 de Fable 5.1 y la mitad de los USD 4 de GPT-5.6 Sol.
- •Fable 5.1 de Anthropic mantiene ventajas sustanciales en benchmarks más largos de código y terminal, ganando Terminal-Bench 4.0 por unos 20 puntos porcentuales sobre Grok 4.7.
- •Grok 4.7 funciona con 2.1 billones de parámetros, un 40% más que su predecesor, y fue entrenado con datos adicionales de SpaceX, incluida telemetría de satélites Starlink y registros de fabricación.
- •Todas las cifras de benchmarks publicadas provienen de pruebas propias de xAI y no de verificación independiente, y el CursorBench detrás de su gráfico de precio-rendimiento es creado por Cursor, que SpaceX adquirió recientemente.
xAI lanzó Grok 4.7 el lunes, presentando un nuevo modelo insignia que superó a Fable 5.1 de Anthropic y a GPT-5.6 Sol de OpenAI en un benchmark de agentes legales, cobrando un quinto del precio de Fable 5.1 por token de entrada.
Según el anuncio de lanzamiento de xAI, Grok 4.7 obtuvo un 19.6% en el Harvey Legal Agent Benchmark, donde Fable 5.1 alcanzó 6.7% y GPT-5.6 Sol logró 2.5%. Eso sitúa a Grok 4.7 en aproximadamente el triple del puntaje de Anthropic y casi ocho veces el de Sol. Cryptopolitan reportó el mes pasado que el modelo anterior de la empresa, Grok 4.6, ya lideraba a ese par con 15.8%. El benchmark Harvey es mantenido por la empresa de tecnología legal Harvey y evalúa a los modelos en trabajo legal de múltiples pasos, uno de los dominios profesionales donde la adopción de IA agéntica se observa con mayor atención.
El trabajo legal destaca como uno de los pocos dominios en los que Grok 4.7 supera francamente a ambos competidores. El modelo también supera a Fable 5.1 en la prueba de ingeniería eléctrica EEBench y le gana por poco en el benchmark de código DeepSWE.
Precios y relación precio-rendimiento
Grok 4.7 tiene un precio de USD 2 por millón de tokens de entrada y USD 6 por millón de tokens de salida —las mismas tarifas que Grok 4.6. Ese precio de entrada es la mitad de los USD 4 de GPT-5.6 Sol y un quinto de los USD 10 de Fable 5.1. En salida, Grok 4.7 cobra USD 6, frente a USD 20 de Sol y USD 50 de Fable, cerca de un octavo de la tarifa de Anthropic. Las tarifas por millón de tokens son la forma estándar en que los proveedores de API facturan —los tokens de entrada cubren lo que el modelo lee y los de salida lo que escribe—, por lo que estos precios de lista son las cifras que los desarrolladores evalúan al elegir entre modelos de frontera.
xAI también graficó los puntajes de CursorBench 4.0 contra el costo promedio por tarea completada y afirma que el modelo se ubica en la frontera de precio-rendimiento. Grok 4.7 alcanza alrededor del 46% en ese gráfico a unos USD 6 por tarea, mientras que Claude Opus 5 necesita casi el doble de gasto para lograr un resultado similar. Fable 5.1 rinde mejor con presupuestos más altos, llegando a 51.8% a unos USD 17 por tarea.
Elon Musk describió lanzamiento como "una combinación sólida de inteligencia, velocidad y bajo costo" en una publicación en X.
Anthropic conserva la ventaja en pruebas de terminal y código
Grok 4.7 quedó segundo detrás de Fable 5.1 en GDPval y en la prueba de trabajo de oficina AA Briefcase, y el modelo de Anthropic mantiene una ventaja clara en benchmarks más largos de código y terminal. El margen más amplio se registra en Terminal-Bench 4.0, donde Fable 5.1 obtuvo 57.9% frente al 38.0% de Grok 4.7 —una brecha de unos 20 puntos. Fable también lidera en CursorBench y en HealthBench Professional de razonamiento clínico, donde GPT-5.6 Sol también vence a Grok.
Grok 4.7 obtuvo 1,695 Elo en GDPval, un benchmark que mide a los modelos en tareas realizadas por abogados, enfermeros y analistas financieros, por encima del 1,605 de Grok 4.6. Eso queda detrás del 1,735 de Fable 5.1, pero por delante del 1,542 registrado por el más nuevo GPT-6 Astra de OpenAI en el mismo gráfico. Las calificaciones Elo, adaptadas del ajedrez, clasifican a los modelos por resultados relativos en lugar de porcentajes brutos.
En conjunto, Grok 4.7 está por delante de GPT-5.6 Sol en cinco de los siete benchmarks, perdiendo solo en DeepSWE y en la prueba clínica.
Un modelo más grande entrenado con datos de SpaceX
Grok 4.7 funciona con 2.1 billones de parámetros, un 40% más que el 1.5 billón que impulsa a Grok 4.6. xAI añadió datos de entrenamiento adicionales de SpaceX, incluida telemetría de satélites Starlink y registros de fabricación, y dice que el nuevo modelo también es más propenso que su predecesor a dedicar tiempo extra a problemas difíciles y a verificar sus propias respuestas.
El modelo se lanzó en la app Grok, Cursor, Grok Build y la API de xAI, sin lista de espera.
Todas las cifras anteriores provienen de pruebas propias de xAI y no de verificación independiente. CursorBench, el benchmark detrás del gráfico de precio-rendimiento de xAI, es creado por Cursor, que SpaceX terminó de adquirir el mes pasado. xAI evaluó a Grok 4.7 contra GPT-5.6 Sol, mientras que el más nuevo GPT-6 Astra de OpenAI aparece solo en las comparaciones de GDPval, AA Briefcase y EEBench. Las evaluaciones de terceros serán el primer contraste externo de esos márgenes.

