xAIs Grok 4.7 schlägt Anthropic- und OpenAI-Modelle beim Legal-Agent-Benchmark zu einem Bruchteil des Preises
Wichtige Erkenntnisse
- •Grok 4.7 erzielte 19,6 % beim Harvey Legal Agent Benchmark – rund dreimal so viel wie Anthropics Fable 5.1 mit 6,7 % und fast achtmal so viel wie OpenAIs GPT-5.6 Sol mit 2,5 %.
- •Das Modell kostet 2 $ pro Million Input-Tokens und 6 $ pro Million Output-Tokens; der Input-Preis beträgt damit ein Fünftel der 10 $ von Fable 5.1 und die Hälfte der 4 $ von GPT-5.6 Sol.
- •Anthropics Fable 5.1ält deutliche Vorsprünge bei längeren Coding- und Terminal-Benchmarks und gewinnt den Terminal-Bench 4.0 mit rund 20 Prozentpunkten Vorsprung vor Grok 4.7.
- •Grok 4.7 läuft mit 2,1 Billionen Parametern, 40 % mehr als sein Vorgänger, und wurde mit zusätzlichen SpaceX-Daten trainiert, darunter Starlink-Satellitentelemetrie und Fertigungsunterlagen.
- •Alle veröffentlichten Benchmark-Zahlen stammen aus xAIs eigenen Tests statt aus einer unabhängigen Überprüfung, und der CursorBench hinter der Preis-Leistungs-Grafik stammt von Cursor, das SpaceX kürzlich übernommen hat.
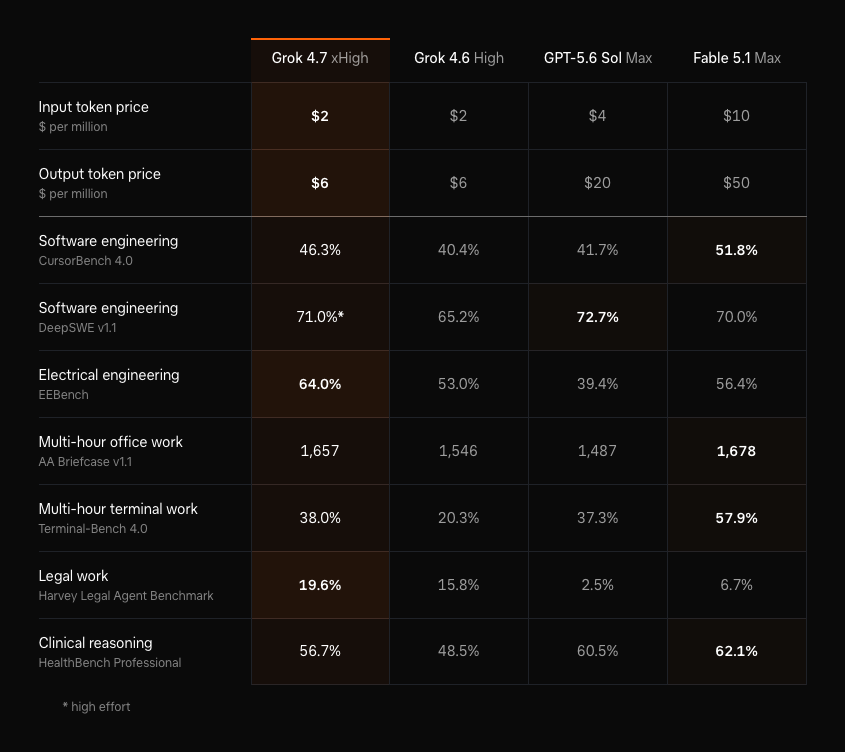
xAI hat am Montag Grok 4.7 vorgestellt und damit ein neues Flaggschiffmodell auf den Markt gebracht, das beim Legal-Agent-Benchmark Anthropics Fable 5.1 und OpenAIs GPT-5.6 Sol übertraf und dabei nur ein Fünftel des Input-Token-Preises von Fable 5.1 berechnet.
Laut xAIs Release-Ankündigung erzielte Grok 4.7 beim Harvey Legal Agent Benchmark 19,6 %, während Fable 5.1 auf 6,7 % und GPT-5.6 Sol auf 2,5 % kam. Damit liegt Grok 4.7 rund dreimal so hoch wie der Wert von Anthropic und fast achtmal so hoch wie der von Sol. Cryptopolitan berichtete letzte Monat, dass das Vorgängermodell Grok 4.6 das Duo mit 15,8 % bereits angeführt hatte. Der Harvey-Benchmark wird vom Legal-Tech-Unternehmen Harvey gepflegt und bewertet Modelle bei mehrstufigen juristischen Aufgaben – einem der beruflichen Felder, in denen die Einführung agentischer KI am genauesten beobachtet wird.
Juristische Arbeit ist eines der wenigen Bereiche, in denen Grok 4.7 beide Konkurrenten klar übertrifft. Das Modell schlägt Fable 5.1 auch beim EEBench-Test für Elektrotechnik und liegt knapp vor ihm beim DeepSWE-Coding-Benchmark.
Preise und Preis-Leistungs-Verhältnis
Grok 4.7 kostet 2 $ pro Million Input-Tokens und 6 $ pro Million Output-Tokens – dieselben Sätze wie Grok 4.6. Der Input-Preis entspricht der Hälfte der 4 $ von GPT-5.6 Sol und einem Fünftel der 10 $ von Fable 5.1. Beim Output verlangt Grok 4.7 6 $, gegenüber 20 $ bei Sol und 50 $ bei Fable – etwa ein Achtel des Anthropic-Satzes. Preise pro Million Tokens sind die übliche Abrechnungsmethode der API-Anbieter – Input-Tokens decken ab, was Modell liest, Output-Tokens, was es schreibt – daher sind diese Listenpreise die Zahlen, anhand derer Entwickler Modelle an der Leistungsgrenze vergleichen.
xAI hat die CursorBench-4.0-Ergebnisse zudem gegen die durchschnittlichen Kosten pro abgeschlossener Aufgabe abgetragen und behauptet, das Modell liege auf der Preis-Leistungs-Grenzfläche. Grok 4.7 erreicht auf dieser Grafik rund 46 % bei etwa 6 $ pro Aufgabe, während Claude Opus 5 fast das Doppelte ausgibt, um ein ähnliches Ergebnis zu erzielen. Fable 5.1 schneidet bei höheren Budgets besser ab und klettert auf 51,8 % bei rund 17 $ pro Aufgabe.
Elon Musk beschrieb die Veröffentlichung in einem Beitrag auf X als „eine starke Kombination aus Intelligenz, Geschwindigkeit & niedrigen Kosten“.
Anthropic bleibt bei Terminal- und Coding-Tests vorn
Grok 4.7 wurde bei GDPval und beim AA-Briefcase-Büroarbeitstest Zweiter hinter Fable 5.1, und Anthropics Modell behält eine klare Führung bei längeren Coding- und Terminal-Benchmarks. Der größte Abstand zeigt sich beim Terminal-Bench 4.0, wo Fable 5.1 auf 57,9 % gegenüber 38,0 % von Grok 4.7 kam – ein Abstand von rund 20 Punkten. Fable führt auch bei CursorBench und beim HealthBench Professional für klinisches Schlussfolgern, wo ebenfalls GPT-5.6 Sol vor Grok liegt.
Grok 4.7 erreichte bei GDPval 1.695 Elo, einem Benchmark, der Modelle an Aufgaben von Anwälten, Pflegekräften und Finanzanalysten misst, gegenüber 1.605 bei Grok 4.6. Das liegt hinter den 1.735 von Fable 5.1, aber vor den 1.542, die OpenAIs neueres GPT-6 Astra auf derselben Grafik erreichte. Elo-Wertungen, die vom Schach übernommen wurden, ordnen Modelle nach relativen Ergebnissen statt nach reinen Prozentwerten.
Insgesamt liegt Grok 4.7 bei fünf von sieben Benchmarks vor GPT-5.6 Sol und verliert nur bei DeepSWE und beim klinischen Test.
Ein größeres Modell, trainiert mit SpaceX-Daten
Grok 4.7 läuft mit 2,1 Billionen Parametern, 40 % mehr als die 1,5 Billionen, die Grok 4.6 antreiben. xAI hat zusätzliche SpaceX-Trainingsdaten eingebunden, darunter Starlink-Satellitentelemetrie und Fertigungsunterlagen, und erklärt, das neue Modell verbringe im Vergleich zu seinem Vorgänger eher zusätzliche Zeit mit schwierigen Problemen und prüfe seine eigenen Antworten eher doppelt.
Das Modell wurde in der Grok-App, in Cursor, Grok Build und über die xAI-API veröffentlicht – ohne Warteliste.
Alle oben genannten Zahlen stammen aus xAIs eigenen Tests und nicht aus einer unabhängigen Überprüfung. CursorBench, der Benchmark hinter der Preis-Leistungs-Grafik von xAI, stammt von Cursor, dessen Übernahme SpaceX letzten Monat abgeschlossen hat. xAI hat Grok 4.7 gegen GPT-5.6 Sol getestet, während OpenAIs neueres GPT-6 Astra nur in den GDPval-, AA-Briefcase- und EEBench-Vergleichen auftaucht. Drittanbieter-Evaluationen werden die erste externe Überprüfung dieser Abstände sein.

