2026 年開源 AI 模型統計:下載量、使用情形與採用度
重點速覽
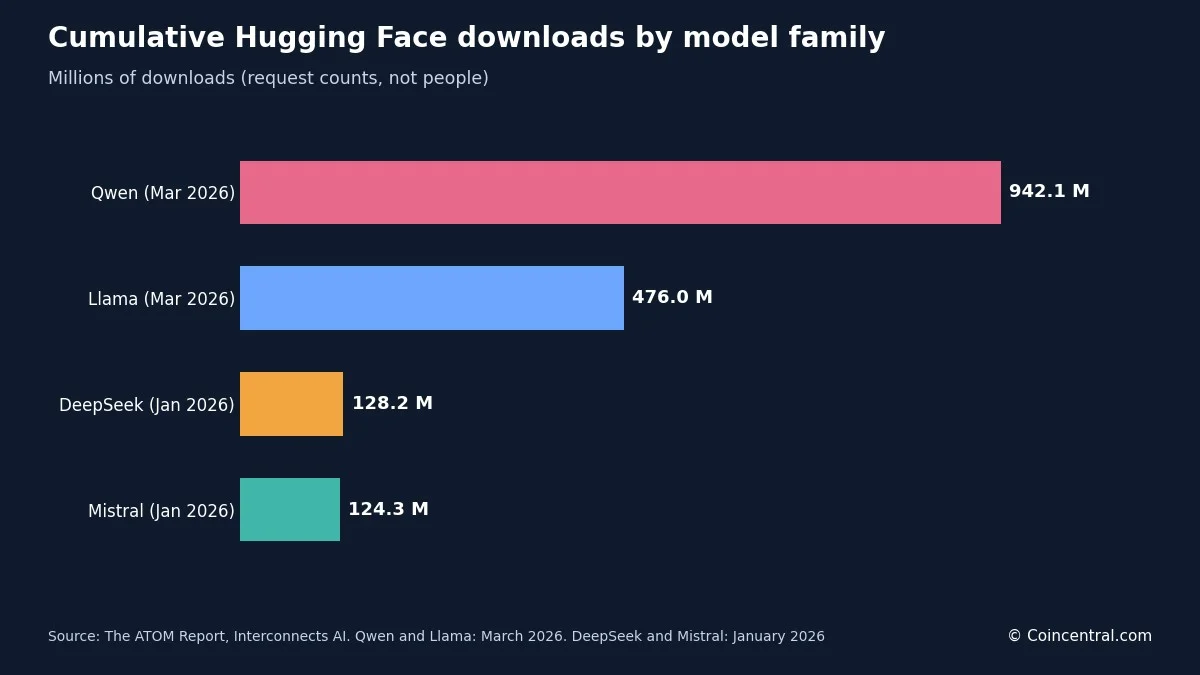
- •截至 2026 年 3 月,阿里巴巴的 Qwen 在 Hugging Face 的累計下載量已達 9.421 億次,約為 Meta Llama(4.760 億次)的兩倍。
- •Mozilla 估計,開源模型處理約 33% 的活躍 AI 使用量,卻僅獲得全球 AI 營收的約 4%。
- •中國開源模型於 2025 年 7 月下旬在累計下載量上超越美國,截至 2026 年 3 月領先 4.28 億次。
- •使用開源模型的團隊中僅 51% 進入正式生產環境,閉源模型為 63%,差距主要歸因於基礎設施不足而非模型品質。
- •GPT-4 級別模型的推論成本在 36 個月內下降約 50 倍,從每百萬 tokens 約 20 美元降至 0.40 美元,報告將此降幅與開放權重競爭聯繫起來。
開源 AI 模型如今已是軟體開發的常規組成部分。開發者下載它們、在它們之上構建應用程式,並在自己的硬體上執行。多個機構試圖衡量這類活動,但其數據並不總是一致。本報告將主要數據並列呈現,涵蓋下載量、token 使用量、區域變化、成本、開發者調查與企業融資。每項數據都標明其來源、日期,以及實際統計的內容。
以下每項指標都有一個共同的注意事項。一次下載是一次檔案請求,不代表一個人。token 數量衡量的是完成的工作量,而非複製份數。大多數開源模型更準確地說是開放權重模型:訓練後的參數是公開的,但訓練資料與程式碼往往不然。因此,這些數據描述的是不同層面的採用:分發、推論、實驗與正式部署。它們應該放在一起閱讀,而不是被視為可互換的市佔率指標。
關鍵數據一覽:
- 截至 2026 年 3 月,Qwen 在 Hugging Face 的累計下載量已達 9.421 億次;Llama 為 4.760 億次。
- 2024 年 11 月至 2025 年 11 月間,DeepSeek 在 OpenRouter 上處理了 14.37 兆個 tokens。
- 根據 Mozilla,開源模型處理約 33% 的活躍 AI 使用量,但僅獲得約 4% 的 AI 營收。
- 79% 為應用添加 AI 功能的開發者使用開源模型,閉源模型為 71%。
- 使用開源模型的團隊進入正式生產環境的比例較低:51%,閉源模型為 63%。
開源 AI 下載統計(按模型家族)
ATOM 報告追蹤 Hugging Face 上約 1,500 個開源語言模型,並將一次下載定義為對模型檔案端點的任何 HTTP 請求,包括來自 transformers 或 curl 工具的自動拉取。
截至 2026 年 3 月,阿里巴巴的 Qwen 家族累計下載量達 9.421 億次,Meta 的 Llama 家族同月為 4.760 億次。Qwen 於 2025 年 9 月首次超越 Llama,當時兩者總量分別為 3.254 億與 3.237 億。六個月後差距擴大至 4.661 億:期間 Qwen 新增約 6.17 億次下載,Llama 則新增約 1.52 億次。
資料來源:The ATOM Report、Interconnects AI,Hugging Face 累計下載量。
DeepSeek 與 Mistral 遠遠落後前兩名。2026 年 1 月,DeepSeek 以 1.282 億次下載超越 Mistral 的 1.243 億次。Mistral 此前一直領先——受 Mistral 7B 與 Mixtral 帶動,其新衍生模型份額於 2023 年 12 月達到 57% 的峰值。Meta 的衍生模型份額於 2024 年 8 月見頂於 44%,至 2026 年 2 月已降至 11%。
較新的美國實驗室起步基數小得多。2025 年 8 月至 2026 年 3 月間,NVIDIA 的 Nemotron 錄得 3,070 萬次下載,Allen Institute for AI 的 OLMo 錄得 1,480 萬次,IBM 的 Granite 錄得 860 萬次。
企業公告則遵循不同的規則。Meta 表示 Llama 於 2025 年 3 月 18 日突破 10 億次下載。Google 表示 Gemma 於 2026 年 8 月 20 日突破 10 億次,並有 Google 工程師指出該數字不含 Android 與 Chrome 整合。兩家公司的數字均未經獨立審核,且 ATOM 對 Llama 的統計僅涵蓋 Hugging Face 上被追蹤的文字生成模型,因此兩組數字無法直接比較。
Qwen 的月度規模是其領先的基礎。2026 年 2 月,Qwen 一家就產生 1.536 億次下載,而下載量次高的八個開源模型組織合計為 7,120 萬次。
開源 AI 下載統計(按地區)
ATOM 依發布組織總部所在地,將每個模型歸類為美國、中國或歐洲。截至 2026 年 3 月,追蹤到的總下載量達 20.4 億次,高於一年前的 3.39 億次。
資料來源:The ATOM Report、Interconnects AI,Hugging Face 累計下載量。
沒有任何地區出現下滑。2025 年 3 月,美國領先中國 8,000 萬次下載;至 2026 年 3 月,中國領先 4.28 億次,ATOM 將交叉點定在 2025 年 7 月下旬。
調查數據指向相同的方向。Mozilla 的開發者調查發現,大中華區與東亞的開源模型使用率為 89%,為全球最高;西歐為 70%。OpenRouter 流量顯示出同步的變化:Mozilla 的分析發現,中國開放權重模型佔每週流量的比例從 2024 年底的不到 2% 增長至 2026 年 4 月的 45%。
Hugging Face 2026 年夏季報告檢視了模型規模。在 2026 年幾乎每個月,中國實驗室發布的最大開源模型都比美國實驗室的任何模型更大。中國月度上限介於 7,540 億至 2.78 兆個參數之間,而美國模型在七個月中有五個月保持在 1,300 億個參數以下。2026 年,AMD 與 NVIDIA 各自發布超過 200 個新模型儲存庫,多於任何其他組織,LiquidAI 以約 100 個居第三。
開源模型的 Token 使用統計
下載量衡量權重被複製的次數;token 則衡量模型完成的工作量。OpenRouter 與 a16z 分析了 2024 年 11 月至 2025 年 11 月間超過 100 兆個真實平台流量 tokens。DeepSeek 處理了 14.37 兆個 tokens,領先 Qwen 的 5.59 兆與 Meta Llama 的 3.96 兆——與下載排名的順序不同,在下載排名中 Qwen 大幅領先。
資料來源:OpenRouter 與 a16z,State of AI,2024 年 11 月至 2025 年 11 月在 OpenRouter 路由的 tokens。
至 2025 年底,開放權重模型約佔 OpenRouter 用量的三分之一。在這一年期間,中國開源模型平均佔每週 token 量的 13.0%,其他地區的開源模型平均為 13.7%,其他地區的專有模型為 70%。
ATOM 自身的 OpenRouter 系列數據顯示份額變化之快。2025 年 6 月,DeepSeek V3 與 R1 合計一度佔開源模型推論 tokens 的 75.6%,至 2026 年 1 月降至 31.1%。Meta 的份額從 2025 年 1 月 37.4% 的峰值降至 2025 年 8 月的零。在這項指標上的領先地位可能在數月內易主。
Presenc AI 使用不同的來源組合,報告的開源份額較小:2026 年 1 月約佔推論 tokens 的 15%,高於一年前的約 1%。在該估計中,DeepSeek 佔約 6%,Qwen 約 5%,Llama 約 3%。
開源與閉源 AI:使用量、營收與性能
Mozilla 於 2026 年 7 月發布其首份 State of Open Source AI 報告。報告發現,開源模型處理約 33% 的活躍 AI 使用量,但僅獲得全球 AI 營收的約 4%;閉源模型佔其餘 67% 的使用量與 96% 的營收。這種分歧源於開源模型的營收方式:執行開放權重無需支付按 token 計費的授權費,營收流向託管模型的一方——往往是買方自己的基礎設施。
其他來源報告的使用份額較低。TechnologyChecker 引述 MIT Sloan 的數據指出,閉源模型約佔模型使用量的 80%,並表示開源模型在發布時可達到閉源模型約 90% 的性能。
性能差距隨時間變化。Mozilla 的 Chatbot Arena 追蹤顯示,平均差距從約 8.04% 降至 2024 年 8 月低至 0.5%。閉源實驗室發布新型推理模型後,差距再度擴大,2026 年 3 月為 3.3 個百分點。
BenchLM 使用不同的標尺。截至 2026 年 10 月 20 日,其前 50 名模型中有 12 個(24%)為開放權重,其追蹤的 972 個模型中有 494 個(51%)為開放權重。其排名最高的開源模型、小米的 MiMo-V2.6-Pro 得分 73.66(滿分 100),名列第 12——比頂尖專有模型 Claude Opus 5.5 落後 13.03 分。BenchLM 列出,2026 年 10 月 15 日閉源與開源榜首模型之間的 Arena Elo 差距為 36.8 分,約一年前為 29.2 分。頁面稱差距正在縮小,但所列數字顯示差距更大,因此對此趨勢應審慎解讀。
差距也取決於任務。Presenc AI 的 2026 年 5 月比較顯示,開源與閉源模型在知識與程式編寫測試上接近持平,但在高難度推理測試上閉源模型大幅領先。
資料來源:Presenc AI,Open Source vs Closed AI Market Share 2026。數值為近似值。
個別結果可能打破整體模式。Z.ai 的 GLM-5.2 在 Terminal-Bench 2.1 上得 81.0 分,GPT-5.5 為 83.4 分;在 SWE-bench Pro 上得 62.1 分,GPT-5.5 為 58.6 分。在 GLM-5.2 出現之前,Mozilla 自身數據集中最佳開源模型在 Terminal-Bench 2.1 上為 67.9 分——報告發布當天,其數據已落後於最新發布的模型。
開發者採用與正式部署統計
Mozilla 的報告基於 SlashData 於 2026 年 5 月對 1,494 名開發者進行的調查,受訪者為為應用程式添加 AI 功能的開發者。
資料來源:Mozilla 與 SlashData 2026 開發者調查,於 2026 年 5 月執行。前兩行數據存在重疊。
正式部署是兩個群體出現分歧之處。使用開源模型的團隊中,51% 進入正式生產環境,閉源模型為 63%。Mozilla 的報告頁面將開源模型的數字列為 53%,其部落格文章則為 51%。SlashData 的 Alvaro Ruiz Cubero 將此差距歸因於基礎設施不足,而非模型品質。
在被問及是什麼阻礙開源模型專案時,開發者最常提到基礎設施成本,佔 27%;其次是安全與合規佔 26%、維護與更新佔 24%、部署複雜性佔 23%。四項答案權重相近,因此沒有任何單一措施能解決問題。
使用情況也取決於工作類型。Presenc AI 估計,約 94% 的邊緣與裝置端工作使用開源模型;對成本敏感的高用量工作約為 85%;法律、金融與醫療等領域的敏感資料工作約為 71%。
資料來源:Presenc AI,Open Source vs Closed AI Market Share 2026。
調查結果取決於提問方式。Presenc AI 表示約 89% 的企業在正式環境中使用至少一個開源模型;TechnologyChecker 引述 Linux Foundation 的研究發現,63% 的組織使用源 AI,89% 的組織在其 AI 技術堆疊的某處使用開源軟體。
可見的網頁端部署則低得多。TechnologyChecker 於 2026 年 5 月掃描了超過 5,000 萬個域名,發現其能偵測到的最常見開源 AI 框架 Botpress 部署於 1,558 個域名——閉源的 OpenAI API 為 52,682 個,Google 的 Dialogflow 為 1,349 個。在 899 家可對應到 Botpress 部署的公司中,64% 員工不多於 10 人,81% 少於 50 人,約 5% 達 1,000 人或以上。美國約佔偵測到部署的 23%,西班牙為 6.9%,印度為 6%。TechnologyChecker 指出,其方法無法偵測 transformers、LangChain 或 Ollama 等後端工具;其統計僅反映瀏覽器可見的層面。
Hugging Face 生態系統統計
Hugging Face 2026 年春季報告稱,2025 年平台增長至 1,300 萬用戶、超過 200 萬個公開模型與逾 50 萬個公開資料集。其夏季報告涵蓋 2026 年 1 月至 8 月,錄得公開模型儲存庫從 243 萬增至 296 萬,資料集從 71.1 萬增至 100 萬,Spaces 從 100 萬增至 144 萬。
注意力高度集中。春季報告發現約半數模型的總下載量不足 200 次,而下載量前 200 名的模型——僅佔總數的 0.01%——佔了所有下載的 49.6%。夏季報告將終身下載量低於 200 次的模型份額定為 85.6%,並稱 1.5% 的儲存庫佔了 99.2% 的下載量。兩份報告的統計方式與涵蓋期間不同,但都呈現相同形態:一小撮模型佔據幾乎全部流量。
Stanford AI Index 2026 統計 GitHub 與 Hugging Face 上約 560 萬個 AI 相關專案,其中僅 206,880 個(3.7%)擁有 10 顆或以上星標。2023 年至 2025 年間,Hugging Face 模型上傳量增長超過三倍,單季達 332,000 次。
資料來源:Hugging Face,State of Open Source on Hugging Face: Spring 2026,發布於 2026 年 3 月 17 日。
平均數的增長遠快於中位數。Hugging Face 將頂端拉高的原因歸功於量化與混合專家(mixture-of-experts)架構,而小型模型的使用保持平穩。小型模型仍佔大多數下載量:低於 10 億參數的模型佔歷來總下載量的 83%,高於 1,000 億參數的模型佔 1%;僅就 2026 年的下載而言,3% 流向高於 700 億參數的模型。
按讚數與下載量衡量的對象不同。2026 年下載量前 25 名的儲存庫與按讚數前 25 名的儲存庫僅有一個重疊項。模型 all-MiniLM-L6-v2 在七個月內被取 15.5 億次,卻只有 5,156 個按讚。
Qwen 已成為他人構建模型的地基。基於 Qwen 的模型在 Hub 上有 151,448 個衍生版本——是 Meta 總數的 2.6 倍、單是 Llama 儲存庫的 4.7 倍——Google 以 82,506 個居次。2026 年前七個月,Qwen 衍生模型以每天約 180 至 210 個新儲存庫的速度增長。
本地執行呈現相同形態。Qwen 每月錄得 3,960 萬次 GGUF 下載,Gemma 為 2,080 萬次,Llama 為 750 萬次。GGUF 是 llama.cpp 等本地執行器所使用的檔案格式。
增長最快的是執行時層。使用 gguf 函式庫的儲存庫增長 464%,lerobot 增長 194%,Apple 的 mlx 增長 148%,transformers 與 peft 增長 16%,diffusers 增長 21%。所有模型儲存庫合計增長 21.5%。
代理(agent)已成為新類型的使用者。2026 年 7 月,Claude Code 佔 Hub 上帶有代理標籤流量的 44.4%,低於 4 月的 67.8%;同期 Codex 從 10.4% 升至 20.8%。
成本、定價與融資統計
Mozilla 報告指出,GPT-4 級別的推論成本在 36 個月內從約 20 美元降至每百萬 tokens 約 0.40 美元——降幅達 50 倍,報告將此歸因於開放權重模型的競爭。報告引述的一項 Linux Foundation 分析估計,閉源模型的推論成本約為同類開源模型的六倍。Mozilla 將此差距換算為估計值:若買方將符合條件的工作負載轉向開放權重,每年可節省 248 億美元。舉例來說,Stripe 將部分 AI 工作轉移至開源模型後,在處理每日 5,000 萬次 API 呼叫的同時,將推論成本降低了 73%。
供應商價目表顯示了價格分佈。Presenc AI 的 2026 年 5 月比較列出 DeepSeek V4 為每百萬輸入 tokens 0.14 美元,GPT-5.5 與 Claude 4.7 Opus 則為 3.00 美元。
資料來源:Presenc AI,Open Source vs Closed AI Market Share 2026,2026 年 5 月供應商價格。
較小的閉源模型價格接近開源模型,GPT-5.5 mini 定價 0.15 美元,Gemini 3.1 Flash 為 0.075 美元——在較低價位層級,單憑價格無法區分開源與閉源。
基於開源模型的公司開始公布營收。Mozilla 的報告列出 Databricks 的年化營收為 54 億美元,Mistral AI 的年度經常性營收約為 4 億美元,十二個月內增長 20 倍。DeepSeek 約為 2.2 億美元,並以超過 500 億美元的估值募集了 74億美元。Mistral 於 2025 年 9 月 9 日宣布 17 億歐元的 C 輪融資,投後估值為 117 億歐元,由 ASML 領投。Zhipu AI 與 MiniMax 均計劃於 2026 年在香港上市。2026 年 5 月,IBM 與 Red Hat 承諾投入 50 億美元於開源 AI 工具與基礎設施。Market.us 預測開源 AI 模型市場將從 2025 年的 190.5 億美元增長至 2026 年的 230.8 億美元,約 21%。
授權條款顯示了回報並非來自何處。在 2026 年 178 個高於 200 億參數的中國模型發布中,59% 使用 Apache 2.0,22% 使用 MIT。美國同規模的發布中,29% 使用 Apache 或 MIT,41% 使用自訂條款,30% 未聲明任何授權。Hugging Face 指出,一些近期最大的模型發布,如 Kimi K3 與 Qwen 3.8 2.4T,已開始加入非商業限制或營收分成條款——授權格局正在改變。
資料來源
- The ATOM Report (arXiv)
- OpenRouter, State of AI
- Hugging Face, State of Open Source on Hugging Face: Spring 2026
- State of Open Source AI (Mozilla)
- BenchLM, Open Source LLM Statistics (2026)
- Hugging Face, State of Open Models: Summer 2026 Observations
- TechnologyChecker, Open-Source AI Adoption 2026
- Tech Insider, Open-Source AI Powers 33% of Use, Just 4% of Revenue
- Presenc AI, Open Source vs Closed AI Market Share 2026
- Command Linux, Open-Source AI Model Download Statistics 2026
本文最初發表於 Blockonomi。

