ChatGPT Images 2.5 對比 Nano Banana 2:六大類別比較
重點速覽
- •ChatGPT Images 2.5 與 Nano Banana 2 在比較中各贏得三個類別,戰成平手。
- •OpenAI 表示,相較於 Images 2.0,新模型可將圖像生成延遲最多降低 50%。
- •測試顯示,ChatGPT Images 2.5 不再出現前幾代的黃色偏色或嚴重過度銳化問題。
- •Nano Banana 2 贏得文字密集型字樣測試和比特幣時間軸測試,ChatGPT Images 2.5 則出現拼字與日期錯誤。
- •OpenAI 新增 Sketch、提示詞分享、區域評論、格式範本,以及全新的 high 和 max API 品質層級。
OpenAI 於 9 月 8 日推出 ChatGPT Images 2.5,承諾提供更銳利的細節、更豐富的紋理、更自然的光線、更精準的編輯,以及比 Images 2.0 低達 50% 的圖像生成延遲。
在六大類別的比較中,Nano Banana 2 贏得三項測試,ChatGPT Images 2.5 則贏得另外三項。結果的差異主要不是來自明顯的品質差距,而是一些可核對的小錯誤,包括拼字錯誤,以及研究型資訊圖表中的錯誤日期。
OpenAI 表示,相較於 Images 2.0,延遲最多降低 50%。該公司也新增兩個 API 模型:GPT-Image-2.5 Flare,作為快速預設模型;以及 GPT-Image-2.5 Sunburst,專為高階編輯精準度而設計。
這次比較延續了 5 月發布的早期測試,當時 GPT Image 2 和 Nano Banana 2 在八個類別中互有勝負。GPT Image 2 贏得較多類別,但在提示詞同時包含許多限制時,會產生明顯的過度銳化瑕疵。這也讓下一個模型面臨一個問題:OpenAI 能否修正這項問題?
這一輪測試中,同一名評測者採用了六個延續自早期測試或經過調整的類別,並向兩個模型提交相同的提示詞。Google 方面使用的是 Nano Banana 2,也就是 Google 對 Gemini 3.1 Flash Image 的稱呼,而不是速度較慢、處理方式更審慎的 Nano Banana Pro。因此,這次測試比較的是 OpenAI 新推出、兼具速度與精準度的模型,以及 Google 同級的產品。
GPT-Image-2.5 有哪些變化
OpenAI 的圖像模型過去一直帶有各自鮮明的缺陷。最初 GPT Image 1 背後的模型出現持續性的暖黃色偏色,使用者稱之為「piss filter」。OpenAI 從未完全解釋或修正這種色調。
GPT Image 2 則以另一個問題取代了前述缺陷:當提示詞堆疊過多限制時,生成的圖像可能會過度銳化,充滿粗糙、過度處理的瑕疵。
這兩個問題都沒有在本次測試中出現。ChatGPT Images 2.5 生成的圖像,即使提示詞複雜度達到最高,仍能維持色彩平衡與細節。前兩代出現的黃色偏色和過度銳化現象都已消失。這項改進在蒸汽龐克與肖像測試中尤其明顯,兩者生成了我們在三代模型測試中看過、攝影一致性最高的 ChatGPT 圖像。
OpenAI 也推出了一些單純圖像對比測試無法呈現、但對工作流程很重要的功能。Sketch 讓使用者能直接在 ChatGPT 中繪製粗略布局,作為生成參考。其他新增功能包括提示詞分享、針對特定圖像區域的內嵌評論,以及海報與商品的格式範本。在 API 方面,品質層級現在從 low 延伸至全新的 high 和 max,超越 Images 2.0 原先的最高級別。
以下是兩個模型在六個類別中的表現。
文字密度:Kellerman’s Hardware 場景
第一項測試呈現一個凌晨 2 點的粗獷街口,幾乎每個表面都包含可讀文字:褪色招牌、噴漆塗鴉、店面乙烯基字樣、撕破的演唱會海報、模板噴漆路緣,以及貼滿貼紙的公共電話。
Nano Banana 2 幾乎清楚地生成了所有文字。主要錯誤是一張公共電話貼紙以混亂的形式重複自身文字,這是容易被忽略的小瑕疵。
ChatGPT Images 2.5 加入了 Nano Banana 2 完全省略的細節:一根電線桿上貼著重疊、以訂書釘固定的傳單,傳單如提示詞描述般破損且風化。然而,模型生成的街頭藝術標籤看起來像是「STILLL HERE」,多了一個 L。褪色招牌上的「KELLERMAN’S」也缺少撇號,或難以辨讀。
雖然 OpenAI 生成的整體場景更寫實,但在一項核心是精準文字生成的測試中,出現了兩個可分開辨識的可讀性錯誤。Nano Banana 2 贏得此類別。
優勝者:Nano Banana 2
空間感知:蒸汽龐克鐘樓
這項空中構圖測試要求呈現五個深度平面的場景,其中包含一座巨大的鐘樓。鐘面應以可讀的羅馬數字顯示不同時間,另有六個文字元素分布在前景至背景之間。
ChatGPT Images 2.5 生成的氛圍明顯更強。蒸汽從屋頂清楚升起,河流穿過中景,五個深度平面之間的色調範圍也更加豐富。文字同樣更容易閱讀。
Nano Banana 2 的氛圍較為扁平。它的兩個可見鐘面確實生成了清楚的羅馬數字——XII、III、VI 和 IX——但兩個鐘面的指針位置相近,沒有遵循提示詞要求顯示不同時間。
ChatGPT Images 2.5 因為更準確地遵循指示,同時沒有犧牲寫實感而獲勝。
優勝者:ChatGPT Images 2.5
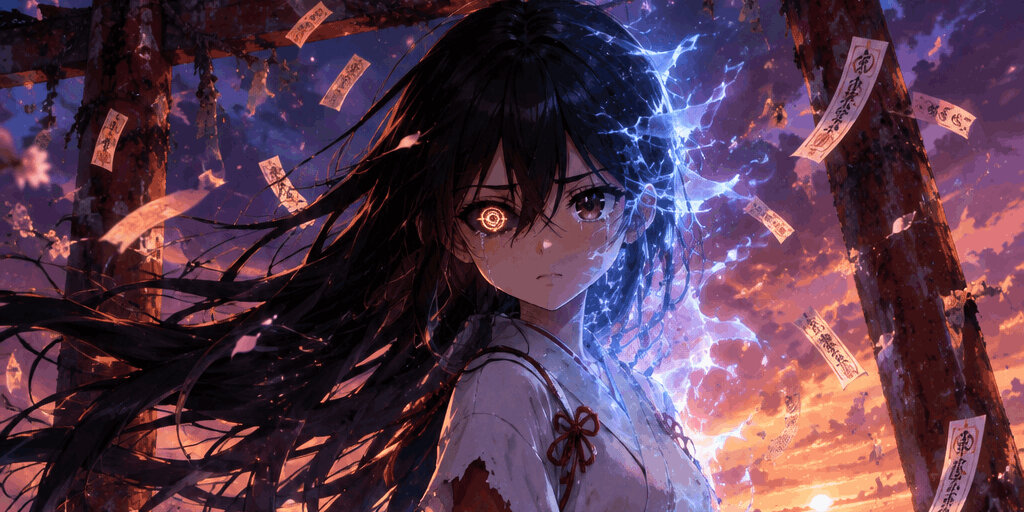
插畫:動漫靈媒
提示詞要求生成 Studio Ufotable 風格的主視覺:一名女孩在鳥居前轉化為靈性能量,身旁有一隻九尾狐,背景是以 Makoto Shinkai 風格描繪的暮色天空。
ChatGPT Images 2.5 生成了整個測試系列中最出色的天空。畫面包含清楚可見的太陽圓盤、水面倒影,以及支持 Shinkai 比喻的山巒剪影。角色不對稱的雙眼也呈現得很好。
模型對女孩應「溶解成能量」的指示沒有完全按照字面呈現。它將這個概念重新詮釋為穿過女孩頭髮的電光效果,而不是提示詞所描述的流動、半透明溶解。Nano Banana 2 輕柔的藍白色能量軌跡,更接近該項具體指示。
兩個模型都沒有生成令人信服的九尾狐。不過,ChatGPT Images 2.5 仍憑藉整體視覺效果獲勝。
優勝者:ChatGPT Images 2.5
寫實感:屋頂上的建築師
這幅電影感肖像包含許多獨立限制:米色風衣、圓框眼鏡、藍圖必須拿在左手、黃金時刻光線、淺景深,以及底片顆粒。
ChatGPT Images 2.5 生成了出色的光線效果,太陽圓盤直接位於人物身後,皮膚微觀紋理也很優秀。皮膚過於平滑,但周遭場景高度寫實,像是以類比相機拍攝的照片。
加入通常會降低攝影品質的指示,意外地提高了圖像的寫實感。其中一個版本加入了「realistic, highlights, crushed shadows, uneven flash, blown out skin tones, candid moment, shot on a phone camera」等關鍵詞。
Nano Banana 2 保留了更完整的構圖,並將藍圖放在人物右手,而不是要求的左手。不過,它在藍圖上加入了清晰可讀的標籤:「PROJECT: 124 DUANE ST」,這是多數生成結果都省略的細節。
Nano Banana 2 贏得單張圖像比較,而 ChatGPT Images 2.5 在重複迭代方面被評為更強。
優勝者:單張圖像為 Nano Banana 2;重複迭代為 ChatGPT Images 2.5
代理式研究:比特幣時間軸
兩個平台都能在生成圖像前先研究主題。這項測試要求製作一張寬螢幕、兒童畫風格的比特幣歷史時間軸,並嚴格要求事實準確。這是比較中最重要的類別,也是兩個模型差距最大的地方。
ChatGPT Images 2.5 生成了一張整潔的兩行資訊圖表,包含許多具體日期,但其中一個日期錯誤。它將 2023 年標示為美國批准比特幣交易所交易基金的年份。美國證券交易委員會實際上是在 2024 年 1 月 10 日批准首批現貨比特幣 ETF,晚了一整年。原文指出,這項差異可能源於詮釋問題,因為期貨 ETF 確實是在該年獲得批准。
Nano Banana 2 生成的時間軸結構較不完整,但描繪了類似事件。它以「2023–2024」的區間表示 ETF 獲批和第四次減半,而不是斷言一個錯誤年份。因此,它列出的日期沒有任何一個在技術上是錯誤的。
Nano Banana 2 獲勝,因為在一項旨在評估「代理式推理」能否產生準確研究結果的測試中,自信地給出錯誤日期更加嚴重。
優勝者:Nano Banana 2
抽象概念:由虛構詞彙組成的提示詞
最後一項提示詞幾乎完全由虛構術語組成:「A woman eating shmfiyxl in Lyxin. Next to her, her Lymglsushing plays Lakishkark.」這道菜、地點、同伴和活動都沒有字典定義,因此兩個模型都必須自行創造含義,並決定如何呈現。
ChatGPT Images 2.5 將這些無意義詞彙直接融入場景,作為可見文字。「Lyxin」出現在一家時髦未來感餐廳上方的霓虹招牌上,而「Lakishkark」則印在女性外星桌伴正在玩的桌遊盒上。模型將虛構詞彙轉化為可讀的招牌,使它們從抽象概念變得具體。
Nano Banana 2 採用了不同方法。它生成了一個溫暖且具有明確文化特色的場景:一個瓜地馬拉市場攤位、一名穿著傳統 huipil 的女性,以及一個正在演奏弦管混合樂器的獸人般生物。它將「plays」理解為演奏音樂,而不是玩遊戲,這是不同但同樣合理的解讀。
然而,畫面中沒有任何內容特別指向「Lyxin」或「Lakishkark」,兩個虛構詞彙也都沒有以可見文字出現。ChatGPT Images 2.5 獲勝,因為將未定義概念轉化為可讀標籤,是對一個沒有提供既定含義的提示詞更貼近字面的回應。
優勝者:ChatGPT Images 2.5
結論
Nano Banana 2 在六個類別中贏得三項,使這次比較基本上打成平手。結果取決於使用者的期望,以及模型的使用方式。
ChatGPT Images 2.5 修正了困擾前代版本的過度銳化問題。在兩輪完整測試中,它的插畫輸出可以說是兩個模型生成過、視覺效果最突出的單張圖像。
因此,模型的選擇取決於任務:文字密集型和研究型圖像更重視精確可讀性與事實核查,而插畫和重複生成工作流程則凸顯了本次測試中展現的其他優勢。這項比較沒有確立一個通用的優勝者,但確實說明了評估圖像模型不能只看單張圖像的視覺吸引力。
兩者的主要差異並不在整體品質,而在一系列細小且可驗證的細節:文字密集場景中的拼字錯誤、研究型資訊圖表中的錯誤年份,以及其他狹義的指示遵循問題。就整體美感和圖像品質而言,兩個模型大致相當。

