AI模型成本解析:訓練支出飆升,推論價格暴跌
重點速覽
- •Epoch AI估計,自2016年以來前沿訓練的硬體與能源攤銷成本每年約成長2.4倍,並預測若趨勢持續,最大規模的訓練可能在2027年左右突破10億美元。
- •估計的訓練運算成本:GPT-4約7,900萬美元、Gemini 1.0 Ultra約1.92億美元、Llama 3.1 405B約1.7億美元;硬體約占前沿開發成本的47%至67%,研發人員占另外的29%至49%。
- •DeepSeek公布DeepSeek-V3的訓練運算成本約為557.6萬美元,基於約278.8萬個Nvidia H800 GPU小時,該數字不含早期研究、消融研究與其他開發費用。
- •自2023年以來,達到固定AI效能水準的成本每季下降約47%,即每年約13倍;Epoch AI表示此降幅快於DNA定序與鋰離子電池等早期的技術成本曲線。
- •GPT-3.5等級的推論成本從2022年底的每百萬代幣約20美元降至2024年10月的0.07美元;到2026年10月,GPT-6 Luna與Claude Haiku 5.5等小型商用模型的輸入代幣價格為每百萬0.10美元,輸出代幣為每百萬0.50美元。
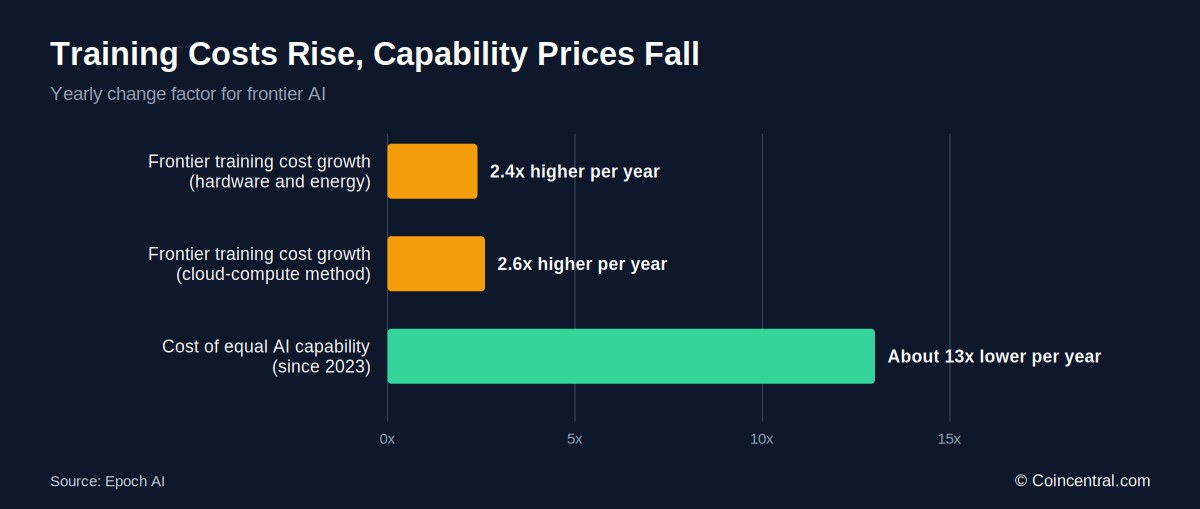
人工智慧已進入經濟學分裂的時代:打造前沿模型的成本持續攀升,使用模型的成本卻不斷下降。兩種趨勢正同時推進。
訓練一個前沿AI模型可能需要數千萬甚至數億美元的運算資源。Epoch AI估計,這類訓練的硬體與能源成本每年約成長2.4倍。
模型訓練完成後,情況便逆轉。根據Epoch AI的資料,達到固定AI效能水準的價格自2023年以來每季下降約47%——相當於每年約13倍的跌幅。
本文彙整訓練成本、推論成本與代幣定價的主要數據,資料來自Epoch AI、史丹佛大學、DeepSeek、OpenAI、Anthropic與Google。所有價格均為2026年10月的標準公布費率。
AI模型成本數據一覽
- 前沿AI訓練成本每年約成長2.4倍。
- Epoch AI預測,若趨勢持續,最大規模的訓練可能在2027年左右突破10億美元。
- GPT-4的訓練運算成本估計約為7,900萬美元。
- Gemini 1.0 Ultra估計約為1.92億美元。
- Llama 3.1 405B估計約為1.7億美元。
- Grok-2估計約為1.07億美元。
- DeepSeek公布DeepSeek-V3官方訓練成本為557.6萬美元,此數字不含早期研究與人員成本。
- 硬體約占前沿模型開發成本的47%至67%;研發人員占另外的29%至49%。
- 能源僅占約2%至6%。
- 達到相同AI效能的成本每季下降約47%,即每年約13倍。
- GPT-3.5等級的推論成本在2022年底至2024年底間下跌超過280倍。
- GPT-6 Luna與Claude Haiku 5.5的輸入代幣價格為每百萬0.10美元,輸出代幣為每百萬0.50美元。
- 在部分API上,快取代幣可比一般輸入代幣便宜90%至95%。
訓練成本上升與使用成本下降之間日益擴大的差距,正是AI經濟學的核心。本文其餘部分將依序探討這兩個面向。
訓練一個AI模型需要多少成本?
沒有單一答案。成本從早期研究模型的數百美元,到前沿系統的數億美元不等。
史丹佛的AI Index(與Epoch AI共同開發估算方法)追蹤訓練成本的演變。史丹佛指出,這些數字主要估算的是運算資源的消耗,而非打造每個模型的完整經濟成本。即便如此,七年來的變化仍然驚人:最早的Transformer估計訓練運算成本不到1,000美元,而GPT-4約為7,900萬美元——是其10萬倍以上。
並非每個模型都遵循上升曲線。Llama 2 70B約為300萬美元,低於GPT-3的400萬美元,也遠低於PaLM 540B的1,200萬美元。模型規模、晶片類型與訓練方法都會影響最終帳單。
前沿訓練成本每年成長2至3倍
Epoch AI研究了數十個主要AI系統,估計自2016年以來,前沿訓練的硬體與能源攤銷成本每年約成長2.4倍。另一種基於雲端運算價格的方法得出類似的每年2.6倍成長率。兩種獨立方法指向同一區間,使這項估算更具說服力。
若趨勢持續,Epoch預測最大的前沿模型可能在2027年左右突破每次訓練10億美元。史丹佛在2026年指出,業界對新前沿系統的估計如今介於每次迭代數億美元至接近10億美元之間。
這並不意味著每個未來的領先模型都會耗資10億美元。混合專家(mixture-of-experts)架構、更好的資料、改良的演算法與更便宜的硬體,都能降低達到特定效能水準所需的運算量。DeepSeek便展示了這種差距可以有多大。
DeepSeek-V3訓練成本
DeepSeek公布DeepSeek-V3的訓練運算成本約為557.6萬美元後,引起廣泛關注。其技術報告指出,完整的官方訓練過程使用了約278.8萬個Nvidia H800 GPU小時。以每GPU小時2美元的假設租用價格計算,總額即為557.6萬美元。
這個數字經常被誤讀。它並非開發V3的總成本。DeepSeek表示,該數字排除了早期研究、架構實驗、消融研究、資料工作及其他開發成本。因此,它無法與包含更廣泛研發支出的估計直接比較;公平的比較需要雙方範圍一致。
這個數字確實顯示的是,設計與工程選擇可以大幅削減最終大型訓練的成本——這項發現對整個產業都具參考價值。
運算只是成本的一部分
打造前沿模型需要的不只是GPU。Epoch AI估計,總開發成本分布在三大領域:硬體約占47%至67%,研發人員占另外的29%至49%,能源僅占約2%至6%。
其他成本可能包括資料取得、資料清洗、失敗的實驗、訓練後調整與強化學習。安全測試、模型評估、網路、儲存與資料中心設施也都會增加總成本。
因此,最終訓練的表面成本可能大幅低估打造具競爭力的前沿模型所需的投入,兩者之間的差距可能相當大。
推論與代幣定價
訓練 vs. 推論
訓練創造模型;推論則是執行模型。每當有人使用模型,企業就必須支付推論費用。如果每天有數百萬人使用某個模型,總推論支出可能超過原始訓練成本。
隨著AI進入程式編寫代理、AI搜尋、客戶服務、語音助理、影片分析與企業自動化,這種動態變得更加重要。聊天機器人數百個代幣的回覆很便宜;但一個閱讀數百萬代幣、反覆呼叫工具並運行數小時的程式編寫代理,消耗的運算資源要多得多。
目前的代幣價格
大多數商用AI API按代幣收費。代幣是一小段文字,一百萬個代幣相當於數十萬個英文字,但確切比例各不相同。
Gemini 4 Argon的2美元與10美元定價為促銷價,有效期至2026年11月30日。Google表示之後標準價格將調整為輸入4美元、輸出20美元。
這些都是標價,並非供應商自身運行模型的成本。
小型模型 vs. 前沿模型
OpenAI的GPT-6 Luna輸入代幣收費為每百萬0.10美元,輸出代幣為每百萬0.50美元。Anthropic的Claude Haiku 5.5對低於10萬代幣的提示提供相同的標價。Anthropic於2026年10月發布Haiku 5.5,並表示該模型的平均運行成本比Haiku 4.5低約75%。
以此費率計算,一家向0.10美元模型發送1億個輸入代幣的企業只需支付10美元,而1,000萬個輸出代幣以每百萬0.50美元計價另需5美元。輸出成本較高,因為模型一次只產生一個代幣,需要更多運算資源。
廉價模型並不適合所有任務。前沿推理系統需要多得多的運算資源,供應商也因此收取更高費用:Anthropic將Claude Opus 5.5定價為輸入代幣每百萬4美元、輸出代幣每百萬20美元——是Haiku 5.5輸出價格的40倍。
這種價差讓AI代理有明確的誘因將簡單任務分配給小型模型,將昂貴的模型保留給困難的推理工作。
AI推論成本大幅下降
史丹佛的AI Index提供了一個鮮明的例子。2022年11月,GPT-3.5等級的效能在MMLU基準上約為每百萬代幣20美元。到了2024年10月,Gemini 1.5 Flash-8B以每百萬代幣0.07美元達到相同的基準水準——不到兩年內下跌超過280倍。
史丹佛發現,視所測任務而定,推論價格每年下跌9倍至900倍不等。範圍之所以如此寬廣,是因為每個基準與每個效能水準都有各自的價格演變史。
利潤率下降並非唯一原因。AI模型及其運行硬體的效率都已大幅提升。
達到相同AI能力的價格每年下跌13倍
Epoch AI於2026年9月的研究超越了原始代幣價格,衡量達到固定模型效能水準的成本。Epoch估計,自2023年以來,這項成本每季下降約47%。全年累計約為13倍的跌幅。
計算很簡單:若價格每季下跌47%,則剩餘53%。四個季度後約剩7.9%,接近十三分之一。
Epoch表示,這種降幅比以往主要技術的成本曲線更快,包括DNA定序、通用運算、鋰離子電池與電力成本。降幅因任務而異。
硬體與軟體讓AI的運行更便宜
AI推論受益於晶片經濟學的持續改善,史丹佛透過機器學習硬體的三項年度趨勢進行追蹤。現代GPU還採用更低精度的數值格式、更好的記憶體系統與更快的晶片間連結。每一項改變都讓資料中心能以同樣的費用完成更多工作。
軟體進一步放大了這些收益。量化、蒸餾、稀疏化、混合專家架構、投機解碼、連續批次處理與更好的編譯器等技術,都降低了每次回答所需的運算量。結果是,隨著時間推移,相同份量的AI能力可以用更少的運算資源提供。
快取與批次處理進一步降低成本
現代API越來越多地對重複資訊提供折扣。設想一個AI代理在每次請求中都附上同一份100頁的公司手冊:供應商可以快取該文字,而不必每次重新處理。
OpenAI對GPT-6 Sol的快取輸入代幣收費為每百萬0.20美元,相較於一般輸入的2美元——即90%的折扣。Google的Gemini 4 Argon目前對符合條件的隱式快取輸入提供95%的折扣。
不需要即時答案的使用者也可以支付更少費用。OpenAI將GPT-6 Sol的批次(Batch)與彈性(Flex)處理定價為標準費率的約50%。批次處理適合文件分類、隔夜分析、資料擷取、大規模摘要與離線評估。
AI定價開始變得像雲端運算:客戶依速度、可靠性與工作負載的彈性支付不同費率。
為什麼單一代幣價格可能造成誤導
每百萬代幣1美元的模型不一定比2美元的模型便宜。假設第一個模型需要500萬代幣才能完成一項任務,而第二個模型只需100萬代幣。第一個模型完成該任務需5美元,第二個只要2美元。
推理模型讓這項檢核更加重要,因為它們可能產生大量內部思考代幣——而其中一部分會被計費。Anthropic表示,Claude Sonnet 5.5每項任務使用的代幣比Sonnet 5少,即使標價看起來相近,在實際工作流程中也可能更便宜。企業越來越多地追蹤每項成功完成任務的成本,而不只看每百萬代幣的價格。
是什麼讓價格持續下跌
三股力量推動推論成本下降:更高效的硬體、更高效的模型設計,以及供應商之間的激烈競爭。
OpenAI將GPT-6 Sol與Luna的API價格較GPT-5.6促銷版本調降約50%,同時提升了能力。Anthropic表示,Haiku 5.5在典型工作負載下比Haiku 4.5便宜約75%。Google也在代幣定價上積極競爭。
結果是,兩三年前成本過高的AI應用,如今可以融入一般產品之中。
成本下降可能推高總支出
更便宜的AI不一定代表產業支出降低。如果每通客戶對話成本為1美元,企業可能不會自動化100萬通對話;但若每通只要1美分,它可能會全部自動化。
這種模式類似於傑文斯悖論(Jevons paradox):資源使用效率提升反而導致總使用量增加。這或許有助於解釋,為什麼最大的雲端公司在每次查詢成本下降的同時,仍持續在AI資料中心投入數千億美元。
結論
AI經濟學正同時朝兩個方向發展。在前沿,訓練成本快速成長:GPT-4估計需要7,900萬美元的訓練運算,Gemini 1.0 Ultra約1.92億美元,Llama 3.1 405B約1.7億美元,而Epoch AI估計前沿訓練成本每年約成長2.4倍。
模型問世後,使用成本則迅速下降。GPT-3.5等級的推論從2022年的每百萬代幣約20美元降至2024年的0.07美元,Epoch較新的研究則指出,達到固定AI效能水準的成本每季下降約47%,即每年約13倍。到2026年10月,小型商用模型的價格低至輸入代幣每百萬0.10美元、輸出代幣每百萬0.50美元。
簡言之,最先進的模型打造成本更高,而這些模型的輸出使用成本更低。若此趨勢持續,AI的影響可能不再取決於訓練一個模型的成本,而取決於當數十億人與企業能以接近普通雲端軟體的價格使用強大AI時,世界將發生什麼。
資料來源
- Epoch AI: The Plunging Price of Thought
- Epoch AI: How Much Does It Cost to Train Frontier AI Models?
- 史丹佛大學:2025 AI Index報告,研究與開發
- 史丹佛大學:2026 AI Index報告
- DeepSeek: DeepSeek-V3技術報告
- OpenAI: Introducing GPT-6 Sol and Luna
- OpenAI: API定價
- Anthropic: Claude Haiku 5.5
- Anthropic: Claude Sonnet 5.5
- Google AI: Gemini 4 Argon定價
本文最初發表於 CoinCentral。

