2026年开源AI模型数据盘点:下载量、使用情况与采用率
要点速览
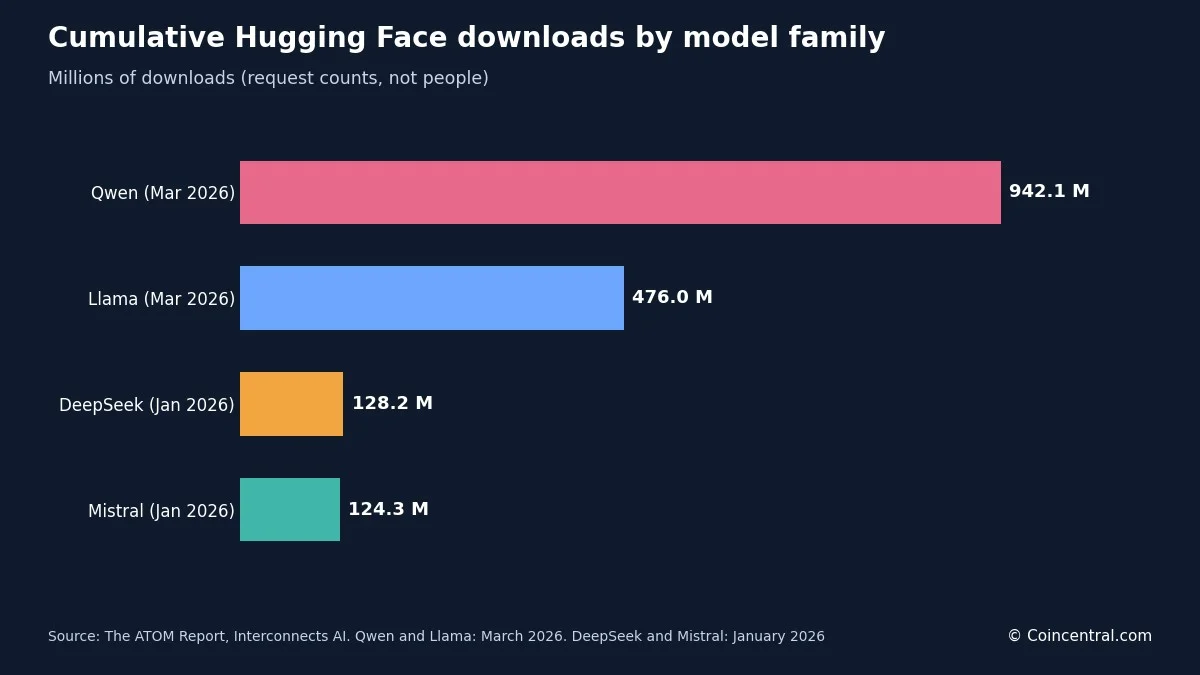
- •截至2026年3月,阿里巴巴Qwen的Hugging Face累计下载量已达9.421亿次,约为Meta Llama 4.760亿次的两倍。
- •Mozilla估计,开放模型承担约33%的活跃AI使用量,但仅获得全球AI收入的约4%。
- •中国开放模型于2025年7月下旬在累计下载量上超越美国,截至2026年3月领先4.28亿次。
- •使用开放模型的团队中仅51%进入生产环境,闭源模型为63%,这一差距主要归因于基础设施缺失而非模型质量。
- •GPT-4级别模型的推理成本在36个月内下降约50倍,从约20美元降至0.40美元/百万token,报告将此归因于开放权重竞争。
开源AI模型如今已成为软件开发的常规组成部分。开发者下载它们、在其之上构建应用,并运行在自己的硬件上。多家机构试图统计这一活动,但各家数据并不总是吻合。本报告将主要数据并排呈现,涵盖下载量、token使用量、地区变化、成本、开发者调查以及企业融资。每项数据均注明来源、日期及其统计口径。
下文所有指标均有一个共同前提:一次下载是一个文件请求,而非一个人。token数量衡量的是完成的工作量,而非复制次数。大多数开放模型更准确地应称为开放权重模型:训练参数是公开的,但训练数据和代码往往并非如此。因此,这些数据描述的是采用的不同层面:分发、推理、实验和生产部署。应将它们结合来看,而非视为可互换的市场份额衡量标准。
关键数据一览:
- 截至2026年3月,Qwen的Hugging Face累计下载量已达9.421亿次;Llama为4.760亿次。
- 2024年11月至2025年11月间,DeepSeek在OpenRouter上处理了14.37万亿token。
- 据Mozilla统计,开放模型承担约33%的活跃AI使用量,但仅获得约4%的AI收入。
- 在添加AI功能的开发者中,79%使用开放模型,使用闭源模型的比例为71%。
- 使用开放模型的团队进入生产环境的比例较低:51%,闭源模型为63%。
开源AI按模型系列的下载统计
ATOM报告追踪Hugging Face上约1,500个开放语言模型,并将下载定义为对模型文件端点的任何HTTP请求,包括来自transformers或curl等工具的自动拉取。
截至2026年3月,阿里巴巴的Qwen系列累计下载量达9.421亿次,Meta的Llama系列同月为4.760亿次。Qwen于2025年9月首次超越Llama,当时两者的总量分别为3.254亿和3.237亿次。六个月后,差距扩大至4.661亿次:同期Qwen新增约6.17亿次下载,而Llama新增约1.52亿次。
来源:The ATOM Report、Interconnects AI,Hugging Face累计下载量。
DeepSeek和Mistral与前两名差距明显。2026年1月,DeepSeek以1.282亿次下载超过Mistral的1.243亿次。Mistral此前曾领先——受Mistral 7B和Mixtral带动,其新衍生模型占比在2023年12月达到57%的峰值。Meta的衍生模型占比在2024年8月达到44%的峰值,至2026年2月已降至11%。
较新的美国实验室起点要小得多。NVIDIA的Nemotron在2025年8月至2026年3月间录得3,070万次下载,艾伦人工智能研究所(Allen Institute for AI)的OLMo录得1,480万次,IBM的Granite录得860万。
企业公告遵循不同的统计规则。Meta称Llama于2025年3月18日下载量突破10亿次。Google称Gemma于2026年8月20日突破10亿次,一位Google工程师指出该数字不包括Android和Chrome集成。两家公司的数字均未经第三方审计,且ATOM对Llama的统计仅涵盖Hugging Face上被追踪的文本生成模型,因此两组数字无法直接比较。
Qwen的月度下载量是其领先的基础。2026年2月,Qwen单月产生1.536亿次下载,而排名其后的八家开放模型机构合计产生7,120万次。
开源AI按地区的下载统计
ATOM根据发布机构总部所在地,将每个模型归入美国、中国或欧洲。截至2026年3月,被追踪的累计下载总量达20.4亿次,一年前为3.39亿次。
来源:The ATOM Report、Interconnects AI,Hugging Face累计下载量。
没有任何地区出现下滑。2025年3月,美国领先中国8,000万次下载;到2026年3月,中国反超4.28亿次,ATOM将交叉点定在2025年7月下旬。
调查数据指向相同方向。Mozilla的开发者调查发现,大中华区和东亚的开放模型使用率为89%,为全球最高;西欧为70%。OpenRouter流量也显示出类似变化:Mozilla的分析发现,中国开放权重模型在周流量中的占比从2024年末的不足2%增长至2026年4月的45%。
Hugging Face的2026年夏季报告考察了模型规模。在2026年几乎所有月份,中国实验室发布的最大开放模型都大于美国实验室的任何模型。中国的月度上限在7,540亿至2.78万亿参数之间,而美国模型在七个月中有五个月保持在1,300亿参数以下。2026年,AMD和NVIDIA各自发布了超过200个新模型仓库,领先所有其他机构,LiquidAI以约100个位居第三。
开放模型的Token使用统计
下载衡量权重被复制的次数;token衡量模型完成的工作量。OpenRouter与a16z分析了2024年11月至2025年11月间超过100万亿token的真实平台流量。DeepSeek处理了14.37万亿token,领先于Qwen的5.59万亿和Meta Llama的3.96万亿——这一排序与下载排名不同,后者Qwen大幅领先。
来源:OpenRouter与a16z,State of AI,OpenRouter路由token,2024年11月至2025年11月。
到2025年末,开放权重模型约占OpenRouter使用量的三分之一。在这一年窗口期内,中国开放模型平均占周token量的13.0%,其他地区开放模型平均占13.7%,其他地区专有模型占70%。
ATOM自己的OpenRouter序列显示份额变化之快。2025年6月,DeepSeek V3和R1合计占开放模型推理token的75.6%,到2026年1月降至31.1%。Meta的份额从2025年1月37.4%的峰值降至2025年8月的零。在这一指标上的领先地位可能在数月内易主。
Presenc AI采用不同的来源组合,报告的开放份额较低:2026年1月开放权重模型约占推理token的15%,一年前约为1%。在该估算中,DeepSeek约占6%,Qwen约5%,Llama约3%。
开源与闭源AI:使用量、收入与性能
Mozilla于2026年7月发布其首份State of Open Source AI报告。报告发现,开放模型承担约33%的活跃AI使用量,但仅获得约4%的全球AI收入;闭源模型占其余67%的使用量和96%的收入。这一差异源于开放模型的盈利方式:运行开放权重无需支付按token计费的许可费,收入流向托管模型的一方——通常是买方自己的基础设施。
其他来源报告的使用份额较低。MIT Sloan(经TechnologyChecker引用)认为闭源模型约占模型使用量的80%,并指出开放模型在时可达闭源模型约90%的性能。
性能差距随时间变化。Mozilla的Chatbot Arena追踪显示,平均差距从约8.04%降至2024年8月低至0.5%。在闭源实验室发布新的推理模型后,差距再度扩大,2026年3月为3.3个百分点。
BenchLM采用不同的衡量尺度。截至2026年10月20日,其前50名模型中有12个(24%)为开放权重,其追踪的972个模型中有494个(51%)为开放权重。其排名最高的开放模型、小米的MiMo-V2.6-Pro得分为73.66/100,排名第12位,落后于榜首专有模型Claude Opus 5.5达13.03分。BenchLM列出的闭源榜首与开放榜首之间的Arena Elo差距在2026年10月15日为36.8分,约一年前为29.2分。该页面称差距在缩小,但页面所载数字显示差距更大,因此对这一趋势应谨慎解读。
差距还取决于任务类型。Presenc AI在2026年5月的对比显示,开放模型在知识和编程测试上接近持平,但在高难度推理测试上闭源模型大幅领先。
来源:Presenc AI,Open Source vs Closed AI Market Share 2026。数值为近似值。
个别结果可能打破总体格局。Z.ai的GLM-5.2在Terminal-Bench 2.1上得分为81.0,对比GPT-5.5的83.4;在SWE-bench Pro上得分为62.1,对比GPT-5.5的58.6。Mozilla自己的数据集中,在GLM-5.2出现之前,最佳开放模型在Terminal-Bench 2.1上的得分为67.9——该报告的数据在发布当天就已落后于最新发布的模型。
开发者采用与生产环境使用统计
Mozilla的报告基于SlashData于2026年5月对1,494名开发者的调查,受访者为正在为应用添加AI功能的开发者。
来源:Mozilla与SlashData 2026年开发者调查,2026年5月执行。前两行数据存在重叠。
两个群体的分歧体现在生产环境。使用开放模型的团队中,51%进入生产环境,闭源模型为63%。Mozilla的报告页面将开放模型数字列为53%,而其博客文章为51%。SlashData的Alvaro Ruiz Cubero将这一差距归因于基础设施缺失,而非模型质量。
当被问及阻碍开放模型项目的因素时,开发者最常提及基础设施成本(27%),其次是安全与合规(26%)、维护与更新(24%)以及部署复杂性(23%)。四项回答权重接近,因此没有任何单一方案能解决问题。
使用情况还取决于具体工作。Presenc AI估计,约94%的边缘和端侧工作使用开放模型,成本敏感的高吞吐量工作约占85%,法律、金融和医疗等领域的敏感数据工作约占71%。
来源:Presenc AI,Open Source vs Closed AI Market Share 2026。
调查结果取决于提问方式。Presenc AI称约89%的企业在生产环境中使用至少一个开源模型;经TechnologyChecker引用,Linux Foundation发现63%的组织使用开源AI,89%在其AI技术栈的某处使用了开源组件。
可见的Web部署要低得多。TechnologyChecker于2026年5月扫描了超过5,000万个域名,发现其可检测到的最常见开源AI框架Botpress运行于1,558个域名,对比闭源OpenAI API的52,682个和Google Dialogflow的1,349个。在与Botpress部署匹配的899家公司中,64%的员工不超过10人,81%少于50人,约5%拥有1,000人或以上。美国约占检测到部署的23%,其次是西班牙(6.9%)和印度(6%)。TechnologyChecker指出,其方法无法看到transformers、LangChain或Ollama等后端工具;其统计仅反映面向浏览器的层面。
Hugging Face生态系统统计
Hugging Face的2026年春季报告称,该平台在2025年增长至1,300万用户、超过200万个公开模型和逾50万个公开数据集。其夏季报告覆盖2026年1月至8月:公开模型仓库从243万增至296万,数据集从71.1万增至100万,Spaces从100万增至144万。\n关注度高度集中。春季报告发现,约半数模型的总下载量不足200次,而排名前200的模型——仅占总数的0.01%——占全部下载量的49.6%。夏季报告将终身下载量不足200次的模型占比列为85.6%,并称1.5%的仓库占99.2%的下载量。两份报告统计口径不同、覆盖时期不同,但都呈现同样的形态:一小部分模型占据几乎所有流量。
Stanford AI Index 2026统计了GitHub和Hugging Face上约560万个AI相关项目,其中仅206,880个(3.7%)拥有10个及以上star。Hugging Face模型上传量在2023年至2025年间增长超过两倍,单季度达到33.2万次。
来源:Hugging Face,State of Open Source on Hugging Face: Spring 2026,发布于2026年3月17日。
均值增长远快于中位数。Hugging Face将头部提升归因于量化和混合专家(mixture-of-experts)设计,而小模型使用保持平稳。小模型仍占据大部分下载量:参数量低于10亿的模型占历史总下载量的83%,超过1,000亿的占1%;仅就2026年的下载而言,3%流向参数量超过700亿的模型。
点赞数和下载量衡量的是不同维度。按2026年下载量排名的前25个仓库与按点赞数排名的前25个仓库只有一个重合条目。模型all-MiniLM-L6-v2在七个月内被拉取15.5亿次,拥有5,156个点赞。
Qwen已成为他人构建的基础。基于Qwen的模型在Hub上有151,448个衍生版本,是Meta总数的2.6倍,是仅Llama仓库数的4.7倍;Google以82,506个位居其后。2026年前七个月,Qwen衍生模型以每天约180至210个新仓库的速度增长。
本地运行也遵循同样模式。Qwen每月录得3,960万次GGUF下载,对比Gemma的2,080万和Llama的750万。GGUF是llama.cpp等本地运行器使用的文件格式。
增长最快的是运行时层。使用gguf库的仓库增长464%,lerobot增长194%,Apple的mlx增长148%;transformers和peft增长16%,diffusers增长21%,而所有模型仓库整体增长21.5%。
智能体(Agent)已成为一类新用户。2026年7月,Claude Code占Hub上智能体标记流量的44.4%,低于4月的67.8%;同期Codex从10.4%升至20.8%。
成本、定价与融资统计
Mozilla报告称,GPT-4级别推理成本在36个月内从约20美元降至约0.40美元/百万token——降幅约50倍,报告将其归因于开放权重竞争。报告引用的Linux Foundation分析认为,闭源模型推理成本约为同类开放模型的六倍。Mozilla据此估算,如果买方将符合条件的工作负载迁移至开放权重,每年可节省248亿美元。例如,Stripe在每日处理5,000万次API调用的情况下,通过将部分AI工作迁移至开放模型,将推理成本降低了73%。
供应商价格表显示了价差。Presenc AI在2026年5月的对比中列出DeepSeek V4为每百万输入token 0.14美元,对比GPT-5.5和Claude 4.7 Opus的3.00美元。
来源:Presenc AI,Open Source vs Closed AI Market Share 2026,2026年5月供应商价格。
较小的闭源模型价格接近开放模型,GPT-5.5 mini标价0.15美元,Gemini 3.1 Flash标价0.075美元——在低端市场,单凭价格无法区分开放与闭源。
基于开放模型的公司开始公布收入。Mozilla的报告列出Databricks的运行率为54亿美元,Mistral AI的年经常性收入约4亿美元,十二个月内增长20倍。DeepSeek约为2.2亿美元,并以超过500亿美元的估值融资74亿美元。Mistral于2025年9月9日宣布17亿欧元C轮融资,投后估值117亿欧元,由ASML领投。智谱AI(Zhipu AI)和MiniMax均在推进2026年香港上市。2026年5月,IBM和Red Hat承诺向开源AI工具和基础设施投入50亿美元。Market.us预计开源AI模型市场将从2025年的190.5亿美元增长至2026年的230.8亿美元,增幅约21%。
许可证表明回报并非来自何处。2026年中国178个参数量超过200亿的发布中,59%使用Apache 2.0,22%使用MIT。美国同规模发布中,29%使用Apache或MIT,41%使用自定义条款,30%未作声明。Hugging Face指出,部分近期最大的发布,如Kimi K3和Qwen 3.8 2.4T,已开始加入非商用限制或收入分成条款——许可证格局正在变化。
来源
- The ATOM Report (arXiv)
- OpenRouter, State of AI
- Hugging Face, State of Open Source on Hugging Face: Spring 2026
- State of Open Source AI (Mozilla)
- BenchLM, Open Source LLM Statistics (2026)
- Hugging Face, State of Open Models: Summer 2026 Observations
- TechnologyChecker, Open-Source AI Adoption 2026
- Tech Insider, Open-Source AI Powers 33% of Use, Just 4% of Revenue
- Presenc AI, Open Source vs Closed AI Market Share 2026
- Command Linux, Open-Source AI Model Download Statistics 2026
本文最初发布于 Blockonomi。

