美国司法部支持OpenAI的合理使用主张,警告强制授权或催生AI寡头垄断
要点速览
- •司法部提交了利益声明书,主张OpenAI在模型训练中使用受版权保护的文字应受合理使用保护。
- •美国政府警告,强制授权训练文本将抬高进入壁垒,有利于财力雄厚的公司和老牌出版商,同时边缘化较小的开发者。
- •该声明书并未提供全面保护,它区分了模型训练与再现受版权保护材料的输出,以及训练数据的获取方式。
- •《纽约时报》和作家协会首席执行官Mary Rasenberger批评了政府立场,而Sidney Stein法官仍可自由不予采纳。
- •高盛研究预测,2026年全球AI相关投资将超过1万亿美元,其中美国占5810亿美元。
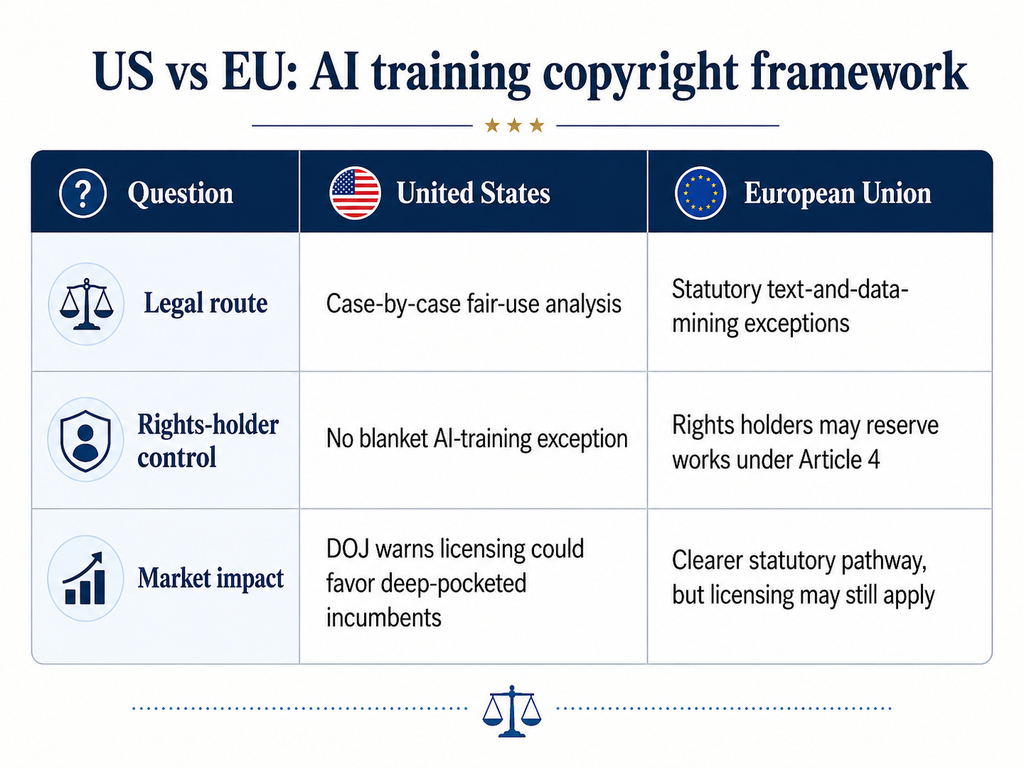
美国司法部周二向曼哈顿一家联邦法院表示,OpenAI在模型训练阶段使用受版权保护的文字应受合理使用原则保护——在全球投资今年有望突破1万亿美元之际,这一立场可能重塑全球AI产业的经济格局。
政府在针对OpenAI的合并版权诉讼中提交了利益声明书,警告称如果要求开发者授权训练文本,只有财力雄厚的公司才能继续打造尖端的AI技术。
美国政府从法律和经济两个层面阐述其论点:强制授权可能对市场准入设置重大障碍,巩固现有科技巨头的地位,并将由此产生的利润大部分转移给拥有最大内容存量的老牌出版商。
此类利益声明书并不决定案件结果;它们让联邦政府就法院审理中的议题表明立场,法官仍可自由采纳或不予理会。
华盛顿为何称授权制度是进入壁垒
司法部认为,对用于训练AI的信息施加成本,可能使较小的开发者被更大的企业边缘化。这与OECD的一份报告的观点一致,即当前AI市场中算力、数据和专业人才的获取已经高度集中,并将继续有利于根基稳固的大公司。
华盛顿还主张,较小的创作者可以从廉价的AI工具中受益。尤其是作家,可以利用模型生成他们原本负担不起的图像,或找到原本会错过的信息来源和视角。
然而,美国版权局的态度更为审慎。其在关于生成式AI训练的报告中指出,某些训练用途可能受合理使用保护,而另一些则不然,取决于所用材料的来源、使用目的及市场影响。
处于核心的转化性使用论点
司法部着重依赖合理使用的第一个法定因素,将AI训练描述为“极具转化性”。根据美国版权法,合理使用的判定需权衡多项法定因素——包括使用的目的和性质、作品性质、使用数量以及对原作市场的影响。政府主张,训练副本的用途与原文不同,且AI的益处“远超任何竞争损害”。
不过,该声明书并未给予AI开发者全面保护。它区分了模型训练与再现受版权保护材料的输出,以及训练数据如何获取的问题。
这一区别在加州的案件中有所体现。版权联盟的分析指出,在Bartz诉Anthropic案和Kadrey诉Meta案中,两家法院均裁定训练具有转化性,但在盗版和市场损害问题上得出了不同结论。
司法部副部长Stanley Woodward Jr.称这份声明书是“历史性的利益声明”,将政府在版权问题上的立场与保持美国在AI领域地位这一更广泛的目标联系起来。
国家安全与对外国竞争对手的竞赛
该文件还将版权规则上升到产业政策和国家安全议题,主张更高的开发成本可能使美国企业在与外国竞争对手的较量中处于劣势。
利害关系重大。高盛研究预测,2026年全球AI相关投资将超过1万亿美元,其中美国占5810亿美元。
欧盟则走上了不同的道路。其数字单一市场指令规定了明确的文本与数据挖掘例外,尽管权利人可以让其作品退出某些形式的挖掘。因此,美国关于合理使用的裁决将发生在全球两大西方市场在AI训练数据监管上已经分道扬镳的背景之下。
出版商与法院的后续反应
于2023年起诉OpenAI和微软的《纽约时报》拒绝了华盛顿的立场。
作家协会首席执行官Mary Rasenberger同样持批评态度,她对WIRED表示,该声明书“极其令人失望”,“充斥着错误的论点,且对合理使用原则和版权法存在严重误解”。
伯克利版权学者Pamela Samuelson对政府介入的评价较为谨慎,称其为“一项重大进展”。
主持本案审理的Sidney H. Stein法官无需遵循司法部的立场。
即便裁决有利于OpenAI,一个关键问题仍可能悬而未决:训练数据是如何获取的。正如Cryptopolitan此前报道,Anthropic与作家达成的15亿美元和解针对的是训练材料的盗版副本——而非训练行为本身。
这一区别可能至关重要。即使训练被认定为合理使用,AI开发者若非法获取用于构建模型的材料,仍将面临重大的法律风险。

