ChatGPT Images 2.5 对比 Nano Banana 2:六类测试结果
要点速览
- •在这次对比中,ChatGPT Images 2.5 与 Nano Banana 2 各赢得三个类别。
- •OpenAI 表示,与 Images 2.0 相比,新模型的图像生成延迟最多可降低 50%。
- •测试显示,ChatGPT Images 2.5 不再出现早期版本中的黄色偏色或严重过度锐化问题。
- •Nano Banana 2 赢得了文字密集型测试和比特币时间线测试,原因是 ChatGPT Images 2.5 出现了拼写和日期错误。
- •OpenAI 新增了 Sketch、提示词分享、区域评论、格式模板,以及新的 high 和 max API 质量等级。
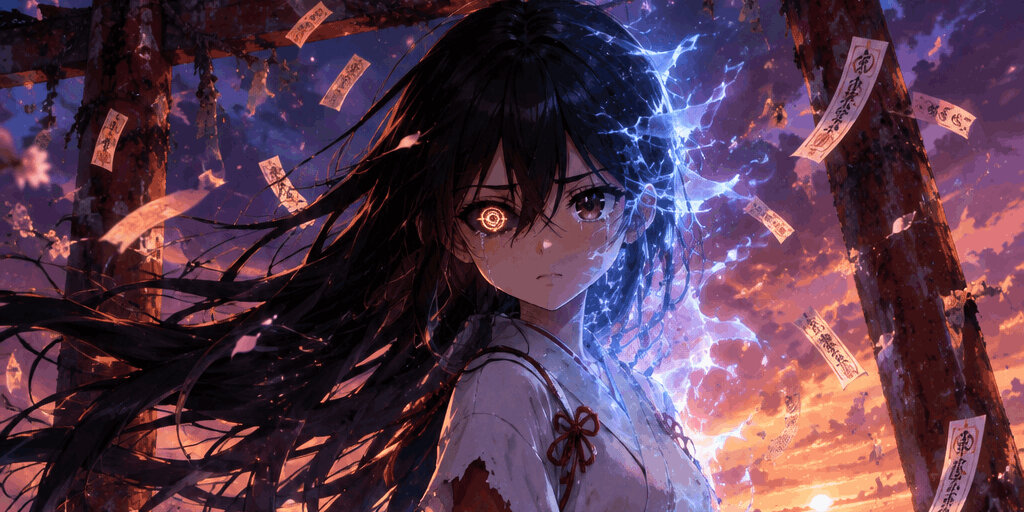
OpenAI 于 9 月 8 日推出 ChatGPT Images 2.5,承诺提供更锐利的细节、更丰富的纹理、更自然的光照、更精准的编辑,以及相比 Images 2.0 最多降低 50% 的图像生成延迟。
在六类测试中,Nano Banana 2 赢得三项,ChatGPT Images 2.5 赢得另外三项。结果的差异并不主要来自明显的质量差距,而是一些细小且可以核查的错误,包括拼写错误和研究型信息图中的错误日期。
OpenAI 表示,与 Images 2.0 相比,延迟最多降低了 50%。该公司还新增了两个 API 模型:作为快速默认选项的 GPT-Image-2.5 Flare,以及面向高级编辑精度的 GPT-Image-2.5 Sunburst。
这次对比延续了 5 月发布的一项早期测试。当时,GPT Image 2 和 Nano Banana 2 在八个类别中交替胜出。GPT Image 2 赢得了更多类别,但当提示词包含大量同时存在的限制条件时,会出现具有辨识度的过度锐化伪影。这也为下一款模型留下了一个问题:OpenAI 能否解决这一问题?
本轮测试中,同一位评测者沿用了六个此前测试中的类别,或对其进行了调整,并向两款模型提交了相同的提示词。Google 方面使用的是 Nano Banana 2,即 Google 对 Gemini 3.1 Flash Image 的命名,而不是速度更慢、处理更审慎的 Nano Banana Pro。因此,这次测试比较的是 OpenAI 新推出的快速、注重精度的模型与 Google 的同级产品。
GPT-Image-2.5 有哪些变化
OpenAI 的图像模型此前都带有各自鲜明的缺陷。最初的 GPT Image 1 背后的模型出现了持续的暖黄色偏色,用户将其称为“尿液滤镜”。OpenAI 从未完全解释或修复这一色调问题。
GPT Image 2 用另一个问题取代了这一缺陷:当提示词包含过多叠加的限制条件时,生成的图像可能会出现严重过度锐化,并充满粗糙、过度处理的伪影。
这两种问题在本次测试中都没有出现。即使提示词的复杂度达到最高,ChatGPT Images 2.5 生成的图像仍保持了色彩平衡和细节。前两代产品中出现的黄色偏色和过度锐化均未再出现。这一改进在蒸汽朋克和肖像测试中尤其明显,这两类测试生成了我们在三代模型中见过的、摄影一致性最强的 ChatGPT 图像。
OpenAI 还推出了一些简单的图像对比无法体现、但对工作流很重要的功能。Sketch 允许用户直接在 ChatGPT 中绘制粗略布局,作为生成参考。其他新增功能包括提示词分享、针对特定图像区域的行内评论,以及海报和商品的格式模板。在 API 方面,质量等级现在从 low 延伸到新的 high 和 max,超过了 Images 2.0 的最高水平。
以下是两款模型在六个类别中的表现。
文字密度:Kellerman’s Hardware 场景
第一项测试描绘了一个凌晨 2 点的粗粝街口,几乎每个表面都带有可读文字:幽灵招牌、喷漆涂鸦、乙烯基店面字样、被撕破的音乐会海报、喷绘路缘,以及贴满贴纸的公用电话。
Nano Banana 2 几乎将所有文字都清晰地呈现了出来。它的主要错误出现在公用电话贴纸上,贴纸重复了自身的文字并形成乱码,这是一个很容易被忽略的小问题。
ChatGPT Images 2.5 加入了 Nano Banana 2 完全遗漏的细节:一根电线杆上贴着相互重叠、用订书钉固定的传单,传单如提示词所描述的那样破损且饱经风吹日晒。不过,它生成的街头艺术标签看起来像是“STILLL HERE”,多出了一个 L。幽灵招牌上的“KELLERMAN’S”也缺少撇号,或无法辨认。
尽管 OpenAI 生成的整体场景更加真实,但在一项以精准文字渲染为核心的测试中出现了两处独立的可读性错误。Nano Banana 2 赢得了这一类别。
胜者:Nano Banana 2
空间感知:蒸汽朋克钟楼
这项空中构图测试要求呈现一个具有五个景深平面的场景,其中包括一座巨大的钟楼。钟面需要使用清晰可读的罗马数字显示不同时间,另有六个文字元素分布在从前景到背景的不同位置。
ChatGPT Images 2.5 生成的图像氛围感明显更强。蒸汽从屋顶上清晰升起,一条河流穿过中景,五个景深平面之间的色调范围也更加丰富。文字同样更容易辨认。
Nano Banana 2 的氛围感较为平淡。它的两个可见钟面确实呈现了清晰的罗马数字——XII、III、VI 和 IX——但两个钟面的指针位置相近,不符合提示词要求显示不同时间的设定。
ChatGPT Images 2.5 在不牺牲真实感的情况下更好地遵循了指令,因此赢得了这一类别。
胜者:ChatGPT Images 2.5
插画:动漫灵媒
提示词要求生成一张 Studio Ufotable 风格的关键视觉图:一名女孩在鸟居前转化为灵性能量,身旁有一只九尾狐,背景是以新海诚风格绘制的暮色天空。
ChatGPT Images 2.5 生成了整个测试系列中表现最出色的天空。画面包含清晰可见的太阳圆盘、水面倒影和山脉剪影,确实支撑了与新海诚作品的比较。角色不对称的双眼也表现良好。
模型对女孩“溶解为能量”这一指令的处理不够直观。它将这一概念重新解释为穿过女孩头发的电火花效果,而不是提示词所描述的流动、半透明的消融过程。Nano Banana 2 生成的轻盈蓝白色能量轨迹更贴近这一具体要求。
两款模型都没有生成令人信服的九尾狐。不过,ChatGPT Images 2.5 凭借整体视觉冲击力赢得了这一类别。
胜者:ChatGPT Images 2.5
真实感:屋顶建筑师
这张电影感肖像包含许多独立限制条件:米色风衣、圆框眼镜、明确要求由左手拿着蓝图、黄金时段光线、浅景深和胶片颗粒。
ChatGPT Images 2.5 生成了极具表现力的光线,太阳圆盘正好位于人物身后,皮肤微观纹理也很出色。皮肤过于光滑,但周围场景看起来非常真实,仿佛用模拟相机拍摄。
加入一些通常会降低照片质量的指令,反而意外提升了图像的真实感。其中一次生成使用了包括“realistic, highlights, crushed shadows, uneven flash, blown out skin tones, candid moment, shot on a phone camera”在内的关键词。
Nano Banana 2 保留了更完整的构图,并将蓝图放在人物右手而不是要求的左手中。不过,它在蓝图上添加了清晰可读的标签:“PROJECT: 124 DUANE ST”,这是大多数生成结果都遗漏的细节。
Nano Banana 2 赢得了单张图像对比,而 ChatGPT Images 2.5 在重复迭代方面被认为表现更强。
胜者:单张图像为 Nano Banana 2;重复迭代为 ChatGPT Images 2.5
代理式研究:比特币时间线
两款平台都可以在生成图像前研究相关主题。这项测试要求生成一张宽屏、儿童画风格的比特币历史时间线,并严格保证事实准确性。这是本次对比中最重要的类别,也是两款模型差距最大的地方。
ChatGPT Images 2.5 生成了一张整洁的两行信息图,其中包含许多具体日期,但其中一个日期是错误的。它将 2023 年标为美国批准比特币交易所交易基金的年份。美国证券交易委员会实际上是在 January 10, 2024 批准首批现货 Bitcoin ETF,比这一日期晚了整整一年。原文指出,这一差异可能源于解释问题,因为期货 ETF 确实是在那一年获批的。
Nano Banana 2 生成的时间线结构较弱,但描绘了相似事件。其结果将 ETF 获批和第四次减半放在“2023–2024”的时间范围内,而不是断言一个错误的单一年份。因此,它给出的日期在技术上都没有错误。
Nano Banana 2 获胜,是因为在一项旨在评估“代理式推理”能否生成准确研究结果的测试中,一个自信但错误的日期更为重要。
胜者:Nano Banana 2
抽象概念:由虚构词组成的提示词
最后一项提示词几乎完全由虚构术语组成:“A woman eating shmfiyxl in Lyxin. Next to her, her Lymglsushing plays Lakishkark.”其中的食物、地点、同伴和活动都没有词典定义,因此两款模型都必须自行赋予这些词语含义,并决定如何呈现。
ChatGPT Images 2.5 将这些无意义的词直接作为可见文字融入场景。“Lyxin”出现在一家时髦未来餐厅上方的霓虹招牌上,而“Lakishkark”则印在女性外星同桌正在玩的桌游盒子上。模型将虚构词转化为可读的招牌,使其从抽象概念变得具体。
Nano Banana 2 采取了不同方法。它生成了一个温暖且具有鲜明文化特征的场景:危地马拉市场摊位、一名穿着传统 huipil 的女性,以及一只演奏弦乐与管乐混合乐器的兽人般生物。它将“plays”理解为演奏音乐,而不是玩游戏,这是对提示词不同但同样合理的解读。
然而,画面中没有任何内容具体对应“Lyxin”或“Lakishkark”,这两个虚构词也都没有以可见文字出现。ChatGPT Images 2.5 获胜,是因为将未定义的概念转化为清晰可读的标签,更贴近一个没有提供既定含义的提示词。
胜者:ChatGPT Images 2.5
结论
Nano Banana 2 赢得六个类别中的三项,因此两款模型基本打成平手。最终结果取决于用户的预期以及使用模型的方式。
ChatGPT Images 2.5 修复了困扰其前代产品的过度锐化问题。在两轮完整测试中,它的插画输出或许是两款模型生成的最具视觉冲击力的单张图像。
因此,模型的选择取决于具体任务:文字密集型和研究型图像更看重精确的可读性和事实核查,而插画和重复生成工作流则会突出本次测试中体现出的其他优势。这项对比并没有确定一个普遍适用的胜者,但说明了评估图像模型不能只看单张图像的视觉吸引力。
两款模型的主要差异并不在整体质量,而在一系列细小且可验证的细节:文字密集场景中的拼写错误、研究型信息图中的错误年份,以及其他狭义的指令遵循问题。就整体美感和图像质量而言,两款模型大体相当。

