AI模型成本统计:训练支出飙升,推理价格暴跌
要点速览
- •Epoch AI估计,自2016年以来前沿训练运行的硬件和能源摊销成本每年增长约2.4倍,并预测如果趋势持续,最大的训练运行可能在2027年左右突破10亿美元。
- •估算训练算力成本约为:GPT-4约7,900万美元、Gemini 1.0 Ultra约1.92亿美元、Llama 3.1 405B约1.7亿美元;硬件占前沿开发成本的47%至67%,研发人员占另外29%至49%。
- •DeepSeek报告DeepSeek-V3训练算力成本约为557.6万美元,基于约278.8万个Nvidia H800 GPU小时,该数字排除了早期研究、消融研究和其他开发费用。
- •自2023年以来,达到固定AI性能水平的成本每季度下降约47%,即每年约下降13倍,Epoch AI表示这一速度快于DNA测序和锂离子电池等此前的技术成本曲线。
- •GPT-3.5级别推理成本从2022年底的每百万token约20美元降至2024年10月的0.07美元;到2026年10月,GPT-6 Luna和Claude Haiku 5.5等小型商业模型的输入token价格为每百万0.10美元,输出token价格为每百万0.50美元。
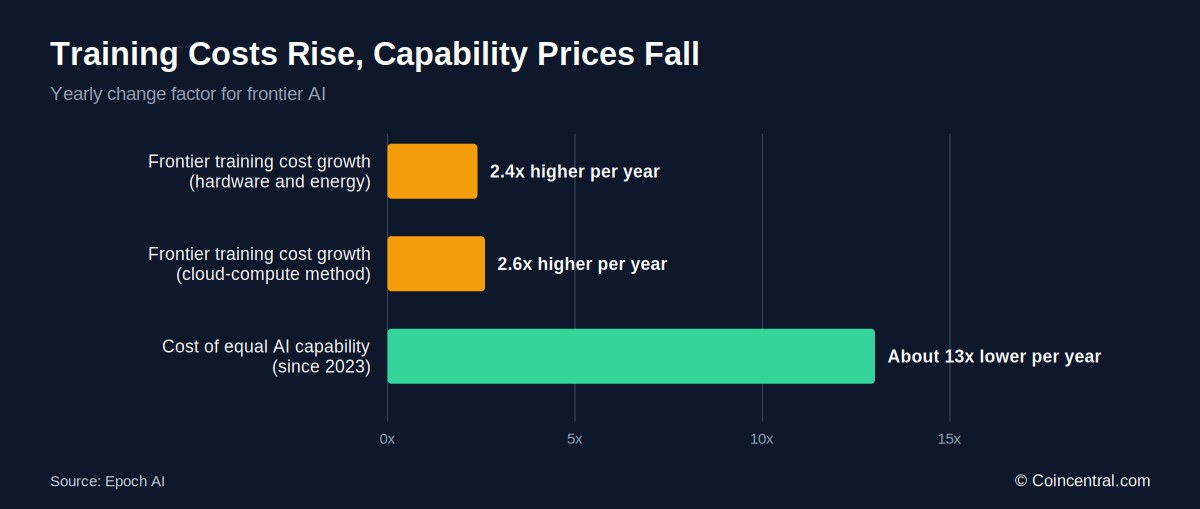
人工智能已进入经济分化时代:构建前沿模型的成本不断攀升,而使用模型的成本却持续下降。这两种趋势正在同时发生。
训练一个前沿AI模型可能需要数千万甚至数亿美元的算力。Epoch AI估计,此类训练运行的硬件和能源成本每年增长约2.4倍。
模型训练完成后,局面发生逆转。据Epoch AI估计,自2023年以来,达到固定AI性能水平的价格每季度下降约47%——相当于每年下降约13倍。
本文汇总了训练成本、推理成本和token定价的主要数据,数据来源包括Epoch AI、斯坦福大学、DeepSeek、OpenAI、Anthropic和Google。所有价格均为截至2026年10月的标准公布价格。
AI模型成本数据一览
- 前沿AI训练成本每年增长约2.4倍。
- Epoch AI预测,如果这一趋势持续,最大的训练运行成本可能在2027年左右突破10亿美元。
- GPT-4训练算力成本估计约为7,900万美元。
- Gemini 1.0 Ultra估计约为1.92亿美元。
- Llama 3.1 405B估计约为1.7亿美元。
- Grok-2估计约为1.07亿美元。
- DeepSeek报告的DeepSeek-V3官方训练运行成本为557.6万美元,该数字不包括早期研究和人员成本。
- 硬件约占前沿模型开发成本的47%至67%;研发人员占另外29%至49%。
- 能源仅占约2%至6%。
- 相同AI性能的成本每季度下降约47%,即每年约下降13倍。
- 2022年底至2024年底,GPT-3.5级别推理成本下降了280多倍。
- GPT-6 Luna和Claude Haiku 5.5的输入token价格为每百万0.10美元,输出token价格为每百万0.50美元。
- 在某些API上,缓存token可比普通输入token便宜90%至95%。
训练成本上升与使用成本下降之间日益扩大的差距是AI经济学的核心。本文余下部分将依次分析这两方面。
训练一个AI模型需要多少成本?
这个问题没有单一答案。成本从早期研究模型的几百美元到前沿系统的数亿美元不等。
斯坦福大学的AI Index与Epoch AI共同开发的估算方法,追踪了训练成本的演变。斯坦福指出,这些数据主要估算的是所消耗的计算资源,而非构建每个模型的全部经济成本。尽管如此,七年间变化巨大:最初的Transformer估计训练算力成本不到1,000美元,而GPT-4约为7,900万美元——相差超过10万倍。
并非所有模型都遵循上升曲线。Llama 2 70B约为300万美元,低于GPT-3的400万美元,更远低于PaLM 540B的1,200万美元。模型规模、芯片类型和训练方法都会影响最终账单。
前沿训练成本每年增长2至3倍
Epoch AI研究了数十个主要AI系统,估计自2016年以来前沿训练运行的硬件和能源摊销成本每年增长约2.4倍。另一种基于云计算价格的方法也得出了类似的每年2.6倍的增速。两种独立方法指向同一区间,使这一估算更具可信度。
如果这一趋势持续,Epoch预测最大的前沿模型可能在2027年左右达到每次训练运行超过10亿美元。斯坦福在2026年指出,业界对新前沿系统的估计现在从每次迭代数亿美元到接近10亿美元不等。
这并不意味着每个未来的领先模型都将耗资十亿美元。混合专家架构、更好的数据、改进的算法和更便宜的硬件都可以降低达到特定性能水平所需的算力。DeepSeek展示了这种差异可以有多大。
DeepSeek-V3训练成本
DeepSeek报告DeepSeek-V3的训练算力成本约为557.6万美元,引起了广泛关注。其技术报告称,完整的官方训练过程使用了约278.8万个Nvidia H800 GPU小时。按每GPU小时2美元的假定租赁价格计算,总额即为557.6万美元。
这个数字经常被误读。它并非开发V3的总成本。DeepSeek表示,该数字排除了早期研究、架构实验、消融研究、数据工作和其他开发成本。因此,该数字无法与包含更广泛研发支出的估算直接比较;公平的比较需要双方具有相同的统计范围。
这个数字确实表明,设计和工程选择可以大幅降低最终大型训练运行的成本——这一发现对整个行业都具有重要意义。
算力只是成本的一部分
构建前沿模型不仅需要GPU。Epoch AI估计,总开发成本分布在三个主要领域:硬件约占47%至67%,研发人员占另外29%至49%,能源仅占约2%至6%。
其他成本可能包括数据获取、数据清洗、失败的实验、后训练和强化学习。安全测试、模型评估、网络、存储和数据中心设施都会增加总成本。
因此,最终训练运行的标称成本可能大大低估构建具有竞争力的前沿模型所需的投入,两者之间的差距可能很大。
推理与Token定价
训练 vs. 推理
训练创造模型;推理运行模型。每当有人使用模型时,公司都要为推理付费。如果每天有数百万人使用某个模型,总推理支出可能超过最初的训练成本。
随着AI进入编程代理、AI搜索、客户服务、语音助手、视频分析和业务自动化领域,这一动态变得更加重要。聊天机器人回复几百个token很便宜;而读取数百万token、反复调用工具并运行数小时的编程代理则消耗多得多的算力。
当前Token价格
大多数商业AI API按token收费。token是文本的一小部分,一百万token相当于数十万英文单词,尽管确切比例有所不同。
Gemini 4 Argon的2美元和10美元定价是截至2026年11月30日的介绍性价格。Google表示,此后标准定价将上涨至输入4美元、输出20美元。
这些是目录价格,并非服务商自身运行模型的成本。
小型模型 vs. 前沿模型
OpenAI的GPT-6 Luna输入token价格为每百万0.10美元,输出token价格为每百万0.50美元。Anthropic的Claude Haiku 5.5对10万token以下的提示采用相同的标称价格。Anthropic于2026年10月发布了Haiku 5.5,并表示该模型的运行成本平均比Haiku 4.5低约75%。
按此价格,向0.10美元模型发送1亿输入token的企业只需支付10美元,而按每百万0.50美元计算的1,000万输出token还需另付5美元。输出成本更高,因为模型一次生成一个token,需要更多算力。
廉价模型并不适合所有任务。前沿推理系统需要多得多的算力,服务商也相应收取更高费用:Anthropic的Claude Opus 5.5定价为每百万输入token 4美元、每百万输出token 20美元——是Haiku 5.5输出价格的40倍。
这一价差使AI代理有明确的理由将简单任务路由到小模型,将昂贵模型留给复杂推理。
AI推理成本大幅下降
斯坦福的AI Index提供了一个鲜明例子。2022年11月,在MMLU基准上达到GPT-3.5级别性能的成本约为每百万token 20美元。到2024年10月,Gemini 1.5 Flash-8B以每百万token 0.07美元达到相同基准水平——不到两年内下降超过280倍。
斯坦福发现,推理价格每年下降9倍至900倍不等,取决于所测任务。范围之所以宽泛,是因为每个基准和每个性能水平都有各自的价格历史。
利润率降低并非唯一原因。AI模型及其运行硬件的效率已大幅提高。
相同AI能力的价格每年下降13倍
Epoch AI 2026年9月的研究超越了原始token价格,衡量达到固定模型性能水平的成本。Epoch估计,自2023年以来,这一成本每季度下降约47%。按全年计算,相当于下降约13倍。
计算很简单。如果价格每季度下降47%,则保留53%。四个季度后,约剩7.9%——接近十三分之一。
Epoch表示,这一下降速度超过了此前主要技术成本曲线,包括DNA测序、通用计算、锂离子电池和电力成本。速率因任务而异。
硬件与软件让AI运行更便宜
AI推理受益于芯片经济的稳步进步,斯坦福通过机器学习硬件的三项年度趋势进行追踪。现代GPU还采用更低精度的数字格式、更好的内存系统和更快的芯片间连接。每一项改进都让数据中心以同样的成本完成更多工作。
软件进一步放大了这些收益。量化、蒸馏、稀疏化、混合专家架构、投机解码、连续批处理和更好的编译器等技术都降低了每次回答所需的算力。因此,随着时间的推移,同样的AI能力可以用更少的计算资源交付。
缓存与批处理进一步降低成本
现代API越来越倾向于对重复信息提供折扣。设想一个AI代理在每次请求中都发送相同的100页公司手册:服务商可以缓存该文本,而不必每次重新处理。
OpenAI对GPT-6 Sol的缓存输入token收费为每百万0.20美元,而普通输入为2美元——即90%的折扣。Google的Gemini 4 Argon目前对符合条件的隐式缓存输入提供95%折扣。
不需要即时答案的用户也可以少付费。OpenAI为GPT-6 Sol提供的Batch和Flex处理价格约为标准价格的一半。批处理适合文档分类、隔夜分析、数据提取、大规模摘要和离线评估。
AI定价开始向云计算靠拢,客户根据速度、可靠性和工作负载的灵活程度支付不同费率。
每任务成本与AI总支出
为什么每token价格可能产生误导
每百万token 1美元的模型并不一定比2美元的模型更便宜。假设第一个模型需要500万token完成任务,而第二个模型只需100万token。第一个模型的任务成本为5美元,第二个为2美元。
推理模型使这一核算更加重要,因为它们可能产生大量内部思考token——其中一部分会被计费。Anthropic表示,Claude Sonnet 5.5每任务的token用量少于Sonnet 5,即使目录价格看起来相似,它也可能在实际工作流程中更便宜。企业越来越多地追踪每个成功完成任务的成本,而不仅仅看每百万token的成本。
什么推动价格持续下降
三股力量推动推理成本下降:更高效的硬件、更高效的模型设计以及服务商之间的激烈竞争。
OpenAI将GPT-6 Sol和Luna的API价格相较其GPT-5.6促销版本下调了约50%,同时提升了能力。Anthropic表示,Haiku 5.5在典型工作负载上的成本比Haiku 4.5低约75%。Google也在token定价上展开竞争。
其结果是,两三年前成本过高的AI应用如今可以融入普通产品。
成本下降可能推高总支出
更便宜的AI并不总是意味着更低的行业支出。如果每次客户对话成本为1美元,公司可能不会自动化100万次对话;而每次只需1美分,它可能会全部自动化。
这种模式类似杰文斯悖论:资源使用效率的提高会导致总使用量的增加。这或许有助于解释为什么最大的云计算公司在每次查询成本下降的同时,仍持续在AI数据中心投入数千亿美元。
结论
AI经济正在同时向两个方向发展。在前沿领域,训练成本快速增长:GPT-4估计需要7,900万美元训练算力,Gemini 1.0 Ultra约1.92亿美元,Llama 3.1 405B约1.7亿美元,Epoch AI估计前沿训练成本每年增长约2.4倍。
模型可用之后,使用成本迅速下降。GPT-3.5级别推理从2022年的每百万token约20美元降至2024年的0.07美元,Epoch AI较新的研究显示,固定AI性能水平的成本每季度下降约47%,即每年约13倍。到2026年10月,小型商业模型的输入token价格低至每百万0.10美元,输出token价格为每百万0.50美元。
简而言之,最先进的模型构建成本更高,而这些模型的输出使用成本更低。如果这一趋势持续,AI的影响可能更多取决于数十亿人和企业能否以接近普通云软件的价格获得强大的AI,而不是取决于训练一个模型的成本。
资料来源
- Epoch AI: The Plunging Price of Thought
- Epoch AI: How Much Does It Cost to Train Frontier AI Models?
- 斯坦福大学:2025 AI Index Report, Research and Development
- 斯坦福大学:2026 AI Index Report
- DeepSeek: DeepSeek-V3 Technical Report
- OpenAI: Introducing GPT-6 Sol and Luna
- OpenAI: API Pricing
- Anthropic: Claude Haiku 5.5
- Anthropic: Claude Sonnet 5.5
- Google AI: Gemini 4 Argon Pricing
本文最初发表于 CoinCentral。

